3. 数据清洗与预处理流程实现
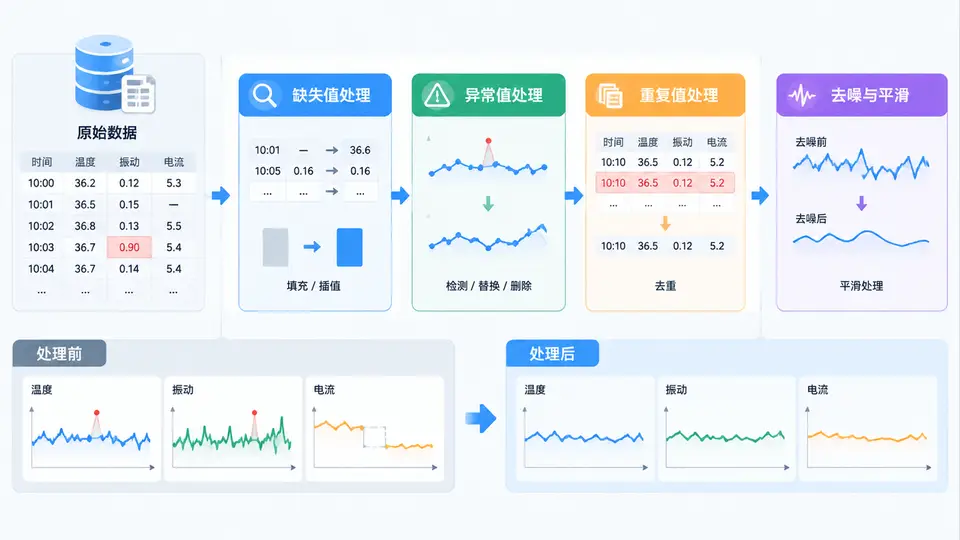
任务说明
本案例面向健康管理PHM系统中的传感器采集数据,实现一条完整的数据清洗与预处理流水线。输入为包含时间戳、温度、振动幅值的原始CSV数据,输出为清洗后的标准数据集。需要处理缺失值(均值填充)、异常值(3σ准则剔除并插值)、重复值(按时间戳去重),并完成滑动平均平滑与中值滤波去噪。
数据清洗流程设计
整体处理链路为:读取原始数据 → 时间戳排序与去重 → 缺失值检测与均值填充 → 异常值检测(3σ)与线性插值修正 → 滑动平均平滑 → 中值滤波去噪 → 输出清洗结果。各步骤顺序固定,确保异常值修正不会因平滑而掩盖,去噪在最后执行以保留趋势特征。
代码实现
import pandas as pd
import numpy as np

def load_data(filepath):
    """读取原始CSV,返回DataFrame"""
    df = pd.read_csv(filepath, parse_dates=['timestamp'])
    return df

def remove_duplicates(df):
    """按时间戳去重,保留第一条记录"""
    before = len(df)
    df = df.drop_duplicates(subset='timestamp', keep='first')
    df = df.sort_values('timestamp').reset_index(drop=True)
    dup_count = before - len(df)
    return df, dup_count

def fill_missing(df, columns):
    """缺失值用该列均值填充,返回填充数量"""
    missing_count = 0
    for col in columns:
        mask = df[col].isna()
        missing_count += mask.sum()
        df.loc[mask, col] = df[col].mean()
    return df, missing_count

def detect_outliers(df, columns, threshold=3):
    """3σ准则检测异常值,用线性插值修正"""
    outlier_count = 0
    for col in columns:
        mean = df[col].mean()
        std = df[col].std()
        if std == 0:
            continue
        mask = (np.abs(df[col] - mean) > threshold * std)
        outlier_count += mask.sum()
        # 对异常位置置NaN,然后线性插值
        df.loc[mask, col] = np.nan
        df[col] = df[col].interpolate(method='linear', limit_direction='both')
    return df, outlier_count

def smooth_data(df, columns, window=5):
    """滑动平均平滑"""
    df[columns] = df[columns].rolling(window=window, center=True, min_periods=1).mean()
    return df

def median_filter(df, columns, kernel=3):
    """中值滤波去噪"""
    df[columns] = df[columns].rolling(window=kernel, center=True, min_periods=1).median()
    return df

def preprocess_pipeline(input_path, output_path):
    """执行完整清洗流程"""
    df = load_data(input_path)
    value_cols = ['temperature', 'vibration']

    df, dup_count = remove_duplicates(df)
    df, miss_count = fill_missing(df, value_cols)
    df, out_count = detect_outliers(df, value_cols)
    df = smooth_data(df, value_cols, window=5)
    df = median_filter(df, value_cols, kernel=3)

    df.to_csv(output_path, index=False)

    stats = {
        'duplicates_removed': dup_count,
        'missing_filled': miss_count,
        'outliers_corrected': out_count,
        'total_records': len(df)
    }
    return stats

if __name__ == '__main__':
    # 生成样例数据(含缺失、异常、重复)
    np.random.seed(42)
    n = 100
    time_idx = pd.date_range('2024-01-01', periods=n, freq='min')
    temp = 25 + 5 * np.sin(np.linspace(0, 8, n)) + np.random.normal(0, 0.5, n)
    vib = 2.0 + 0.3 * np.cos(np.linspace(0, 6, n)) + np.random.normal(0, 0.1, n)

    # 注入1个重复时间戳
    time_idx = time_idx.insert(50, time_idx[50])
    temp = np.insert(temp, 50, temp[50])
    vib = np.insert(vib, 50, vib[50])

    # 注入3个缺失值
    temp[20] = np.nan
    vib[45] = np.nan
    temp[80] = np.nan

    # 注入2个异常值
    temp[30] = 45.0
    vib[70] = 8.0

    raw_df = pd.DataFrame({'timestamp': time_idx, 'temperature': temp, 'vibration': vib})
    raw_df.to_csv('sensor_data.csv', index=False)

    # 执行清洗
    stats = preprocess_pipeline('sensor_data.csv', 'cleaned_data.csv')
    print('清洗统计:', stats)
    print('清洗后数据预览:')
    print(pd.read_csv('cleaned_data.csv').head())
运行与验证
运行方式:将上述代码保存为 data_cleaning.py,在Python环境中执行 python data_cleaning.py。需要安装 pandas 和 numpy(pip install pandas numpy)。
验证方法:程序会生成 sensor_data.csv(含1个重复、3个缺失、2个异常)并输出清洗后的 cleaned_data.csv。控制台打印的统计信息应显示:duplicates_removed=1、missing_filled=3、outliers_corrected=2、total_records=100。检查输出文件:时间戳无重复且严格递增;温度列范围应在20~30之间(异常值45已被修正);振动列范围应在1.5~2.5之间(异常值8已被修正);无NaN值。
判定标准:统计计数与注入的污染数据完全一致,且清洗后数据范围符合物理合理区间,即可判定流程正确。若需验证其他数据,替换 sensor_data.csv 后重新运行即可。