3. 人脸关键点检测
任务说明
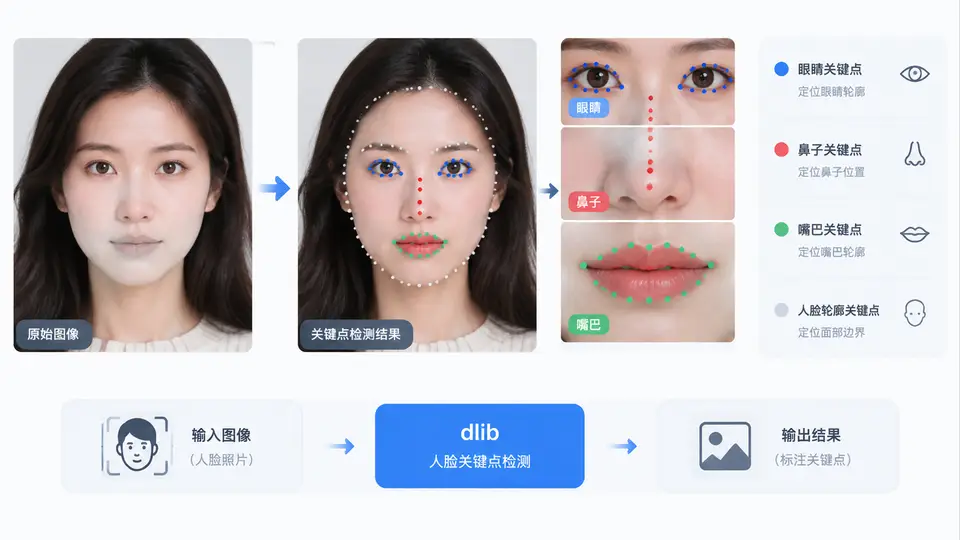
本案例使用 dlib 的预训练 68 点人脸关键点模型,对输入图像中的人脸进行检测,并定位眼睛、鼻子、嘴巴等关键区域。最终在图像上绘制关键点与区域轮廓,输出标注后的图像文件。
实现方案
采用 dlib 的 HOG + 线性 SVM 人脸检测器定位人脸框,再使用 shape_predictor_68_face_landmarks.dat 模型预测 68 个关键点。根据 68 点模型的语义约定,将关键点分组:左眼(点36–41)、右眼(点42–47)、鼻子(点27–35)、嘴巴(点48–67),并用不同颜色绘制。代码同时输出关键点坐标的文本文件,便于后续分析。
代码实现
import dlib
import cv2
import json

# 初始化检测器与预测器
detector = dlib.get_frontal_face_detector()
predictor = dlib.shape_predictor("shape_predictor_68_face_landmarks.dat")

# 定义各部位关键点索引(68点模型)
PARTS = {
    "jaw":      list(range(0, 17)),
    "left_eye": list(range(36, 42)),
    "right_eye":list(range(42, 48)),
    "nose":     list(range(27, 36)),
    "mouth":    list(range(48, 68))
}

# 颜色定义 (BGR)
COLORS = {
    "jaw":       (200, 200, 200),
    "left_eye":  (0, 255, 0),
    "right_eye": (0, 255, 0),
    "nose":      (255, 0, 0),
    "mouth":     (0, 0, 255)
}

def detect_landmarks(image_path, output_image_path, output_json_path):
    img = cv2.imread(image_path)
    if img is None:
        raise ValueError(f"无法读取图像: {image_path}")
    gray = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)

    faces = detector(gray, 1)
    if len(faces) == 0:
        print("未检测到人脸")
        return

    # 仅处理第一张人脸
    face = faces[0]
    landmarks = predictor(gray, face)

    # 收集坐标
    points = {name: [] for name in PARTS}
    for name, idx_list in PARTS.items():
        for i in idx_list:
            x = landmarks.part(i).x
            y = landmarks.part(i).y
            points[name].append((x, y))
            cv2.circle(img, (x, y), 2, COLORS[name], -1)

    # 绘制人脸框
    cv2.rectangle(img, (face.left(), face.top()),
                  (face.right(), face.bottom()), (0, 255, 255), 2)

    # 保存标注图像
    cv2.imwrite(output_image_path, img)

    # 保存坐标JSON
    with open(output_json_path, "w", encoding="utf-8") as f:
        json.dump(points, f, indent=2)

    print(f"检测完成,共 {len(faces)} 张人脸")
    print(f"标注图像: {output_image_path}")
    print(f"坐标文件: {output_json_path}")

if __name__ == "__main__":
    detect_landmarks(
        image_path="input.jpg",
        output_image_path="output_landmarks.jpg",
        output_json_path="landmarks.json"
    )
依赖与运行
- 安装依赖:
pip install dlib opencv-python - 下载模型文件
shape_predictor_68_face_landmarks.dat(约 99MB),放置于代码同目录 - 准备一张包含正脸人像的
input.jpg于同目录 - 运行:
python face_landmarks.py
验证方法
运行后检查输出:
- 图像验证:打开
output_landmarks.jpg,应看到人脸框(黄色矩形),左眼与右眼为绿色点,鼻子为蓝色点,嘴巴为红色点,脸部轮廓为灰色点。各点应准确落在对应器官边缘。 - 坐标验证:打开
landmarks.json,确认包含 jaw、left_eye、right_eye、nose、mouth 五个键,每个键对应一个坐标数组。例如 left_eye 应有 6 个点,mouth 应有 20 个点。 - 判定标准:若图像中关键点位置与五官轮廓基本吻合,且 JSON 中各部位点数与上述约定一致,则案例通过。
关键点分组说明
68 点模型将人脸关键点按固定顺序排列:点 0–16 为下颌轮廓,点 17–26 为眉毛,点 27–35 为鼻梁与鼻翼,点 36–41 为左眼,点 42–47 为右眼,点 48–67 为嘴巴外轮廓与内轮廓。本案例仅提取眼睛、鼻子、嘴巴及下颌轮廓进行可视化,眉毛区域未单独绘制但包含在完整 68 点中。
判定标准
运行程序后,若输出图像中绿色点准确覆盖左右眼睑边缘、蓝色点沿鼻梁分布、红色点勾勒嘴唇轮廓,且 JSON 文件中各部位点数正确(左眼 6 点、右眼 6 点、鼻子 9 点、嘴巴 20 点),则视为检测成功。若图像中人脸角度过大(如侧脸超过 60°)或存在遮挡,dlib 可能检测失败,此时程序会输出“未检测到人脸”,属于正常限制。