2. 解析 SPDX 许可证标识符并标准化
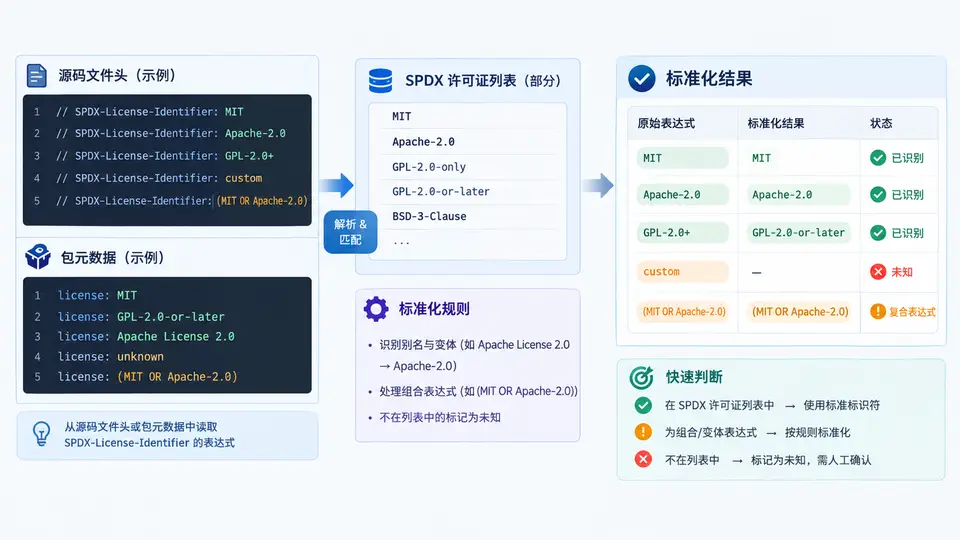
SPDX 许可证标识符的构成与标准化目标
源码文件头或包元数据中常见的声明形式是 SPDX-License-Identifier: MIT、SPDX-License-Identifier: Apache-2.0 OR MIT、SPDX-License-Identifier: GPL-2.0-only WITH Classpath-exception-2.0。标准化要做三件事:把大小写、别名、旧式写法映射到 SPDX 许可证列表中的规范 ID;保留并规范化表达式中的 AND、OR、WITH 与括号结构;对无法匹配的标识符或非法表达式打上 UNKNOWN 标记并保留原始文本,便于人工复核。
标准化映射规则与实现要点
SPDX 许可证列表中的规范标识符区分大小写,但实际声明中常出现大小写混用、别名和旧式写法。标准化时按以下优先级处理:
- 精确匹配:与 SPDX 列表中的
licenseId完全一致时直接采用。 - 别名映射:如
GPL-2.0映射为GPL-2.0-only,Apache 2.0映射为Apache-2.0,BSD映射为BSD-3-Clause(需结合上下文确认)。 - 大小写归一:将 token 转为规范形式后再查表,例如
mit→MIT,apache-2.0→Apache-2.0。 - 表达式结构校验:检查
AND/OR/WITH两侧是否有合法操作数,括号是否配对,WITH右侧是否为已知例外标识符。 - 无法识别处理:保留原始文本,输出
UNKNOWN标记,并记录原因(未知 ID、括号不匹配、非法运算符组合等)。
可复用的标准化函数(Python 示例)
以下代码实现从文本中提取 SPDX-License-Identifier 字段并完成标准化,依赖一份简化的 SPDX 许可证 ID 集合与别名映射表。运行前需准备 spdx_ids.txt(每行一个规范 ID)和 aliases.json(别名到规范 ID 的映射)。
import re
import json

# 加载 SPDX 规范 ID 集合与别名映射
with open("spdx_ids.txt", encoding="utf-8") as f:
    SPDX_IDS = {line.strip() for line in f if line.strip()}

with open("aliases.json", encoding="utf-8") as f:
    ALIASES = json.load(f)  # 例如 {"GPL-2.0": "GPL-2.0-only", "Apache 2.0": "Apache-2.0"}

# 运算符与例外标识符(简化示例)
OPERATORS = {"AND", "OR", "WITH"}
KNOWN_EXCEPTIONS = {"Classpath-exception-2.0", "LLVM-exception"}

def extract_spdx_field(text: str):
    """从文本中提取 SPDX-License-Identifier 字段值,返回列表(可能多行声明)。"""
    pattern = re.compile(r"SPDX-License-Identifier:\s*(.+)", re.IGNORECASE)
    return [m.group(1).strip() for m in pattern.finditer(text)]

def normalize_token(token: str):
    """将单个 token 标准化为规范 ID 或返回 None。"""
    # 精确匹配
    if token in SPDX_IDS:
        return token
    # 别名映射
    if token in ALIASES:
        return ALIASES[token]
    # 大小写归一后匹配
    for sid in SPDX_IDS:
        if sid.lower() == token.lower():
            return sid
    return None

def normalize_expression(expr: str):
    """标准化 SPDX 表达式,返回 (标准化结果, 状态, 原因)。"""
    # 括号配对检查
    if expr.count("(") != expr.count(")"):
        return f"UNKNOWN ({expr})", "非法", "括号不匹配"

    # 按空格分词,保留括号
    tokens = re.findall(r"\(|\)|[^\s()]+", expr)
    result_tokens = []
    for tok in tokens:
        if tok in ("(", ")"):
            result_tokens.append(tok)
        elif tok.upper() in OPERATORS:
            result_tokens.append(tok.upper())
        else:
            normalized = normalize_token(tok)
            if normalized is None:
                return f"UNKNOWN ({expr})", "无法识别", f"未知标识符: {tok}"
            result_tokens.append(normalized)

    # 简单结构校验:WITH 右侧必须是已知例外
    for i, tok in enumerate(result_tokens):
        if tok == "WITH":
            if i + 1 >= len(result_tokens) or result_tokens[i + 1] not in KNOWN_EXCEPTIONS:
                return f"UNKNOWN ({expr})", "非法", "WITH 右侧例外标识符无效"

    return " ".join(result_tokens), "已识别", ""

# 示例调用
sample_text = """
// SPDX-License-Identifier: mit
// SPDX-License-Identifier: Apache-2.0 OR MIT
// SPDX-License-Identifier: GPL-2.0-only WITH Classpath-exception-2.0
// SPDX-License-Identifier: MyCustomLicense-1.0
// SPDX-License-Identifier: MIT OR (Apache-2.0 AND
"""

for raw in extract_spdx_field(sample_text):
    normalized, status, reason = normalize_expression(raw)
    print(f"原始: {raw}")
    print(f"  标准化: {normalized}")
    print(f"  状态: {status}  {reason}")
验证方法:用上述示例文本运行后,预期输出中
mit 应变为 MIT,Apache-2.0 OR MIT 保持不变,GPL-2.0-only WITH Classpath-exception-2.0 保持不变,MyCustomLicense-1.0 标记为 UNKNOWN,括号不匹配的表达式标记为非法。若实际输出与预期不符,优先检查别名映射表是否覆盖了测试用例中的写法。
注意:SPDX 许可证列表会随版本更新,标准化时应固定使用某一版本的列表文件,并在输出中记录版本号,避免因列表变化导致同一份代码在不同时间得到不同结果。对于
UNKNOWN 项,不要自动猜测许可证类型,应保留原始文本并交由人工复核。