1. 企业司库数据读取与初步探查
任务说明
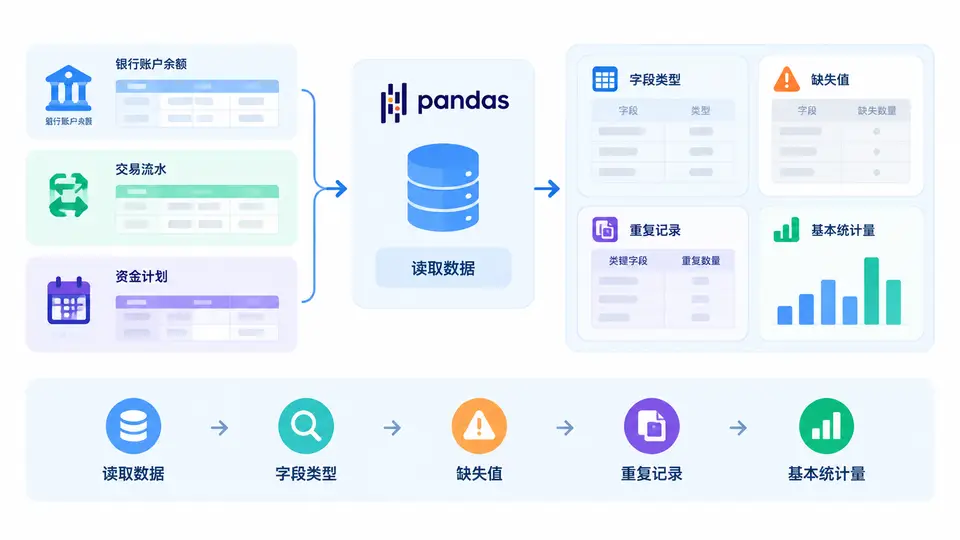
本案例用 pandas 读取三份司库数据(银行账户余额、交易流水、资金计划),对每张表输出字段类型、缺失值、重复记录和数值列基本统计量,形成一份可复用的数据质量概览。
环境与数据
依赖:Python 3.9+、pandas。三份 CSV 放在同目录下,字段如下:
accounts.csv:account_id, bank, account_type, balance, currency, updated_attransactions.csv:txn_id, account_id, txn_date, amount, direction, counterpartyplans.csv:plan_id, account_id, plan_month, plan_inflow, plan_outflow
数据质量探查流程
完整代码
import pandas as pd

FILES = {
    "accounts": "accounts.csv",
    "transactions": "transactions.csv",
    "plans": "plans.csv",
}

def load_tables(files):
    return {name: pd.read_csv(path) for name, path in files.items()}

def quality_report(name, df):
    print(f"\n===== {name} =====")
    print(f"行数: {len(df)}  列数: {df.shape[1]}")
    print("\n[字段类型]")
    print(df.dtypes)
    print("\n[缺失值]")
    print(df.isna().sum())
    print("\n[重复记录数]")
    print(df.duplicated().sum())
    num_cols = df.select_dtypes(include="number").columns
    if len(num_cols):
        print("\n[数值列统计量]")
        print(df[num_cols].describe().T)
    else:
        print("\n[数值列统计量] 无")

if __name__ == "__main__":
    tables = load_tables(FILES)
    for name, df in tables.items():
        quality_report(name, df)
运行与验证
在数据文件所在目录执行 python quality_report.py。通过条件:三张表均打印出字段类型、缺失值、重复记录数;含数值列的表额外输出 count/mean/std/min/max 等统计量,无数值列的表显示“无”。若某表读取报错,检查文件名与列名是否与上方一致。