3. 财务凭证序时账数据加载与科目编码规范化
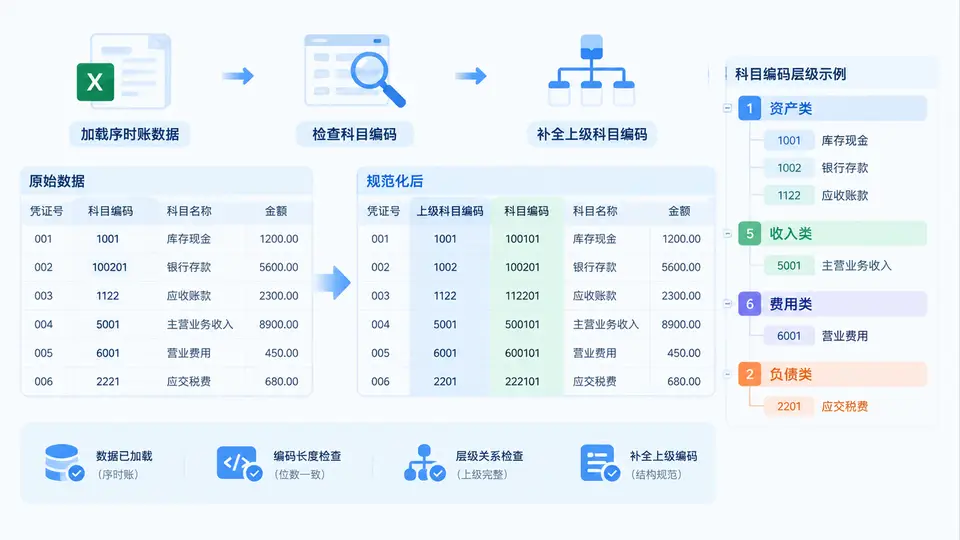
任务说明
本案例读取财务序时账 CSV,检查“科目编码”列的长度分布与层级结构,并为缺失上级编码的记录补全上级科目编码。科目编码按层级分段:一级 4 位,其后每级 2 位(如 1122、112201、11220101)。补全规则:若某记录的科目编码长度大于 4 位,则其上级科目编码为去掉最后 2 位后的前缀;若长度为 4 位,则无上级科目编码。
环境与依赖
Python 3.8+,依赖 pandas。安装:pip install pandas。输入文件 journal.csv 需包含列:凭证号, 科目编码, 科目名称, 借方, 贷方。
核心实现
import pandas as pd

def load_journal(path):
    df = pd.read_csv(path, dtype={"科目编码": str})
    df["科目编码"] = df["科目编码"].str.strip()
    return df

def check_levels(df):
    # 长度分布
    dist = df["科目编码"].str.len().value_counts().sort_index()
    # 层级:4位为1级,之后每2位加1级
    def level(code):
        n = len(code)
        if n < 4 or (n - 4) % 2 != 0:
            return None
        return 1 + (n - 4) // 2
    df["层级"] = df["科目编码"].map(level)
    return dist, df

def fill_parent(df):
    def parent(code):
        return code[:-2] if len(code) > 4 else None
    df["上级科目编码"] = df["科目编码"].map(parent)
    return df

if __name__ == "__main__":
    df = load_journal("journal.csv")
    dist, df = check_levels(df)
    print("科目编码长度分布:")
    print(dist)
    invalid = df[df["层级"].isna()]
    if not invalid.empty:
        print("存在非法编码:")
        print(invalid[["凭证号", "科目编码"]])
    df = fill_parent(df)
    print(df[["凭证号", "科目编码", "层级", "上级科目编码"]])
    df.to_csv("journal_filled.csv", index=False, encoding="utf-8-sig")
运行与验证
将上述代码保存为 normalize.py,与 journal.csv 同目录,执行 python normalize.py。验证要点:
- 长度分布只应出现 4、6、8 等偶数且 ≥4 的值;若出现其他长度,脚本会打印非法编码记录。
- 输出中每条长度 >4 的记录,其“上级科目编码”应等于自身编码去掉末 2 位;长度 =4 的记录该列为空。
- 生成
journal_filled.csv,用 Excel 打开确认新增“层级”“上级科目编码”两列且内容与规则一致。