3. 金融数据获取与清洗
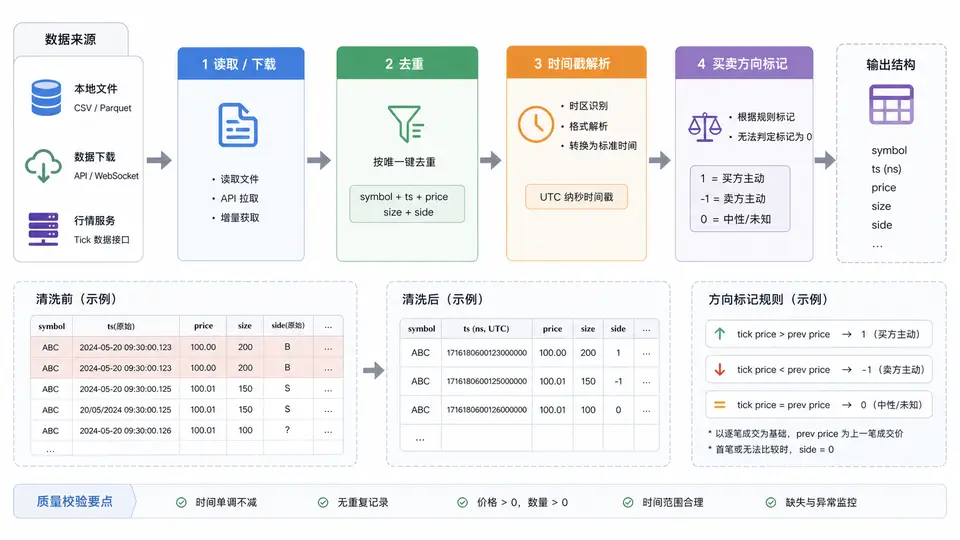
任务说明
本案例从本地 CSV 读取 tick 级逐笔成交数据,完成三件事:按“时间戳+成交编号”去重、把时间戳解析为带时区的 DatetimeIndex、用“成交价对比上一笔中间价”的规则标记买卖方向(side:1 主动买、-1 主动卖、0 无法判定)。
环境与数据
依赖 pandas(pip install pandas)。输入文件 ticks.csv 需包含列:ts(ISO8601 时间戳)、trade_id、price、bid、ask。示例数据由下方代码自动生成,无需手工准备。
处理流程
完整代码
import pandas as pd

# 1. 生成示例 tick 数据(真实场景改为 pd.read_csv("ticks.csv"))
raw = pd.DataFrame({
    "ts": ["2024-01-02T09:30:00.100Z", "2024-01-02T09:30:00.250Z",
           "2024-01-02T09:30:00.250Z", "2024-01-02T09:30:00.400Z",
           "2024-01-02T09:30:00.550Z"],
    "trade_id": [1, 2, 2, 3, 4],          # 第2、3行重复
    "price": [100.02, 100.05, 100.05, 99.98, 100.01],
    "bid":   [100.00, 100.03, 100.03, 99.97, 99.99],
    "ask":   [100.02, 100.05, 100.05, 99.99, 100.01],
})

def clean_ticks(df: pd.DataFrame) -> pd.DataFrame:
    df = df.copy()
    # 2. 时间戳解析为 UTC 并设为索引
    df["ts"] = pd.to_datetime(df["ts"], utc=True)
    df = df.sort_values("ts")
    # 3. 去重:同一时间戳+成交编号只保留一条
    df = df.drop_duplicates(subset=["ts", "trade_id"]).set_index("ts")
    # 4. 买卖方向:成交价高于中间价=主动买,低于=主动卖
    mid = (df["bid"] + df["ask"]) / 2
    df["side"] = 0
    df.loc[df["price"] > mid, "side"] = 1
    df.loc[df["price"] < mid, "side"] = -1
    return df

ticks = clean_ticks(raw)
print(ticks[["trade_id", "price", "bid", "ask", "side"]])
print("去重后行数:", len(ticks))
运行与验证
直接运行脚本。判定通过条件:
- 输出行数为 4(原始 5 行去掉 1 条重复);
- 索引为
DatetimeIndex且带 UTC 时区,按时间升序; side列取值符合规则:price > mid为 1,price < mid为 -1,相等为 0。
按上述数据,第 1 笔(100.02 对 mid 100.01)应为 1,第 4 笔(99.98 对 mid 99.98)应为 0,其余为 1。若换用真实文件,只需把 raw 替换为 pd.read_csv("ticks.csv"),并保证列名一致。