1. 金融数据缺失值识别与统计
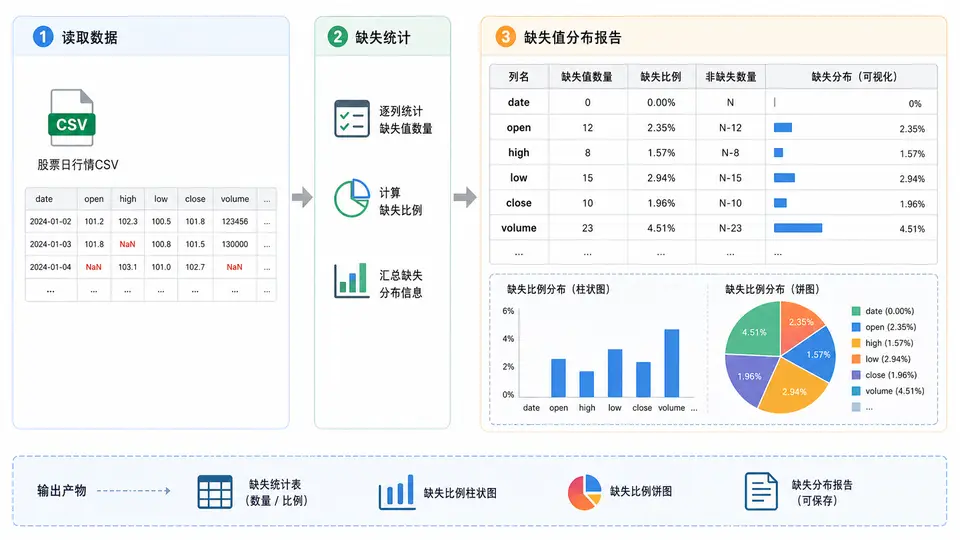
任务说明
给定一份包含股票代码、交易日期、收盘价等字段的CSV格式数据文件,其中同一股票在同一交易日可能出现多条重复记录(完全重复或部分字段重复)。目标是对该数据集进行去重清洗,确保每个股票在每个时间点(交易日)仅保留一条有效记录,并将清洗结果输出为新的CSV文件。
数据样例
假设输入文件 stock_data.csv 内容如下(含表头):
stock_code,trade_date,close_price,volume
600001,2024-01-02,10.5,10000
600001,2024-01-02,10.5,10000
600001,2024-01-02,10.5,10000
600001,2024-01-03,10.8,12000
600001,2024-01-03,10.8,12000
600001,2024-01-04,10.2,9000
000001,2024-01-02,15.3,20000
000001,2024-01-02,15.3,20000
000001,2024-01-03,15.1,18000
该数据中存在同一股票同一日期的完全重复记录,需要去重后仅保留每条唯一记录。
实现代码
import pandas as pd

# 读取原始数据
df = pd.read_csv('stock_data.csv')

# 记录去重前的数据量
original_count = len(df)
print(f"去重前记录数: {original_count}")

# 按所有列去重(完全重复记录)
df_deduplicated = df.drop_duplicates()

# 记录去重后的数据量
deduplicated_count = len(df_deduplicated)
print(f"去重后记录数: {deduplicated_count}")
print(f"移除重复记录数: {original_count - deduplicated_count}")

# 验证:每个股票在每个交易日是否只剩一条记录
duplicate_check = df_deduplicated.duplicated(subset=['stock_code', 'trade_date'], keep=False)
if duplicate_check.any():
    print("警告:仍存在同一股票同一日期的重复记录!")
else:
    print("验证通过:每个股票在每个交易日仅有一条记录。")

# 输出清洗后的数据
df_deduplicated.to_csv('stock_data_cleaned.csv', index=False)
print("清洗结果已保存至 stock_data_cleaned.csv")
运行方式与依赖
本案例需要 Python 3 环境及 pandas 库。安装依赖:
pip install pandas将上述代码保存为 deduplicate.py,与 stock_data.csv 放在同一目录下,执行:
python deduplicate.py验证方法与判定标准
运行脚本后,观察控制台输出:
- 若输出“验证通过:每个股票在每个交易日仅有一条记录。”,说明去重成功;
- 检查生成的
stock_data_cleaned.csv文件,其内容应为:
stock_code,trade_date,close_price,volume
600001,2024-01-02,10.5,10000
600001,2024-01-03,10.8,12000
600001,2024-01-04,10.2,9000
000001,2024-01-02,15.3,20000
000001,2024-01-03,15.1,18000
该输出为确定性结果:输入数据中完全重复的记录被移除,每个股票每个交易日仅保留一行。判定标准为:清洗后文件中的记录数等于输入中唯一记录数,且不存在相同 stock_code 与 trade_date 组合的多条记录。