1. 课程导入
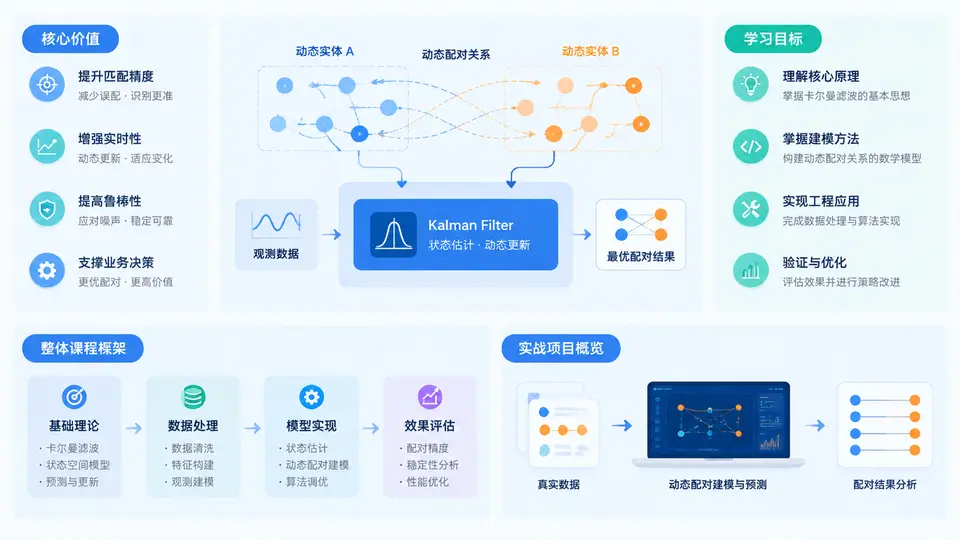
在真实业务系统中,“配对关系”几乎无处不在:乘客与司机、订单与骑手、用户与设备、商品与货架、传感器与目标、广告与流量位。很多初学者会把配对理解成一次性的匹配问题,例如用匈牙利算法或贪心策略求一个最优分配。但在工程现场,配对关系往往不是静态的,而是随时间连续演化的:司机在移动,乘客可能取消,设备会切换网络,目标会遮挡,观测会丢失。此时,真正困难的不再是“如何配一次”,而是“如何在噪声、延迟和不确定性中持续维护一组可信的配对关系”。这正是卡尔曼滤波发挥核心价值的场景。
卡尔曼滤波的本质,是在线性高斯假设下,对动态系统的状态进行递归贝叶斯估计。它把“预测”和“更新”交替执行:先用运动模型预测下一时刻状态,再用观测对预测进行校正。对于动态配对关系建模,卡尔曼滤波提供的不是简单的相似度打分,而是一套可解释、可递推、可融合多源信息的概率框架。它能够回答三个关键问题:当前配对关系有多可信?下一时刻关系会如何变化?当观测缺失或冲突时,应该相信模型还是相信数据?
核心观点:动态配对关系建模的目标不是追求单帧最优匹配,而是在时间维度上维护一组稳定的、可更新的、带不确定性的关系状态。卡尔曼滤波把“配对”从离散决策问题提升为连续状态估计问题。
核心原理:从“匹配分数”到“状态估计”
传统配对方法通常输出一个相似度矩阵,然后通过阈值或分配算法得到配对结果。这种方式在单帧内有效,但缺乏时间一致性。卡尔曼滤波的引入改变了建模对象:我们不再只估计“A 是否与 B 配对”,而是估计一个关系状态向量。例如,对于目标跟踪中的数据关联,可以定义状态为“目标与观测之间的相对位置、相对速度、关联置信度”;对于出行派单,可以定义状态为“司机与乘客的预计接驾时间、距离变化率、匹配概率”。
设关系状态为 x_k,观测为 z_k,则标准卡尔曼滤波包含两个步骤:
预测:
x_k|k-1 = F * x_k-1|k-1
P_k|k-1 = F * P_k-1|k-1 * F^T + Q

更新:
K_k = P_k|k-1 * H^T * (H * P_k|k-1 * H^T + R)^-1
x_k|k = x_k|k-1 + K_k * (z_k - H * x_k|k-1)
P_k|k = (I - K_k * H) * P_k|k-1其中,F 是状态转移矩阵,描述关系如何随时间演化;H 是观测矩阵,描述关系状态如何映射为可观测值;Q 是过程噪声,反映模型不确定性;R 是观测噪声,反映传感器或业务数据的可信度。对于动态配对,P 矩阵尤其重要,因为它不仅给出估计值,还给出“这次配对有多不确定”。当 P 增大时,系统更依赖新观测;当 P 减小时,系统更相信历史趋势。
方法流程:动态配对建模的完整闭环
将卡尔曼滤波用于动态配对关系建模,通常遵循以下流程。这个流程不是一次性执行,而是每个时间步循环运行。
- 关系定义:明确配对单元,例如“车辆-订单”“用户-设备”“目标-观测”。确定关系状态包含哪些维度,如距离、速度、方向、置信度。
- 状态初始化:为每个候选配对建立初始状态和协方差矩阵。初始协方差可以设得较大,表示对初始关系不确定。
- 预测阶段:利用运动模型或业务规则预测下一时刻关系状态。例如,根据司机当前位置和速度预测其与乘客的距离变化。
- 观测获取:收集当前时刻的观测数据,如 GPS 距离、点击率、信号强度、匹配得分。
- 更新阶段:计算卡尔曼增益,融合预测与观测,得到后验状态估计和更新后的协方差。
- 关系判定:根据后验状态和协方差进行配对决策。常用方法包括最大后验概率、马氏距离门限、置信区间重叠度等。
- 生命周期管理:对长期低置信度的配对进行降权、冻结或删除;对新出现的候选配对进行初始化。
实战提示:在动态配对中,Q 和 R 的调参比 F 更关键。Q 过大,关系状态会剧烈跳动;Q 过小,系统无法适应真实变化。R 过大,观测被忽视;R 过小,异常值会污染配对结果。
案例/场景:多目标跟踪中的数据关联
以多目标跟踪为例。假设有多个运动目标,每个时刻传感器返回一组观测点。我们需要判断哪个观测属于哪个目标。传统最近邻方法只看当前距离,容易在目标交叉或遮挡时发生身份切换。引入卡尔曼滤波后,可以为每个“目标-观测”候选配对维护一个滤波器:预测目标下一位置,计算观测与预测之间的马氏距离,并用该距离作为关联代价。马氏距离同时考虑了位置偏差和协方差,因此比欧氏距离更稳健。
下表对比了静态匹配与卡尔曼动态配对在几个关键维度上的差异:
| 维度 | 静态匹配 | 卡尔曼动态配对 |
|---|---|---|
| 时间一致性 | 无,每帧独立 | 有,状态递推 |
| 不确定性表达 | 通常只有分数 | 协方差矩阵 |
| 观测缺失处理 | 容易失败 | 可仅预测维持 |
| 多源融合 | 需手工加权 | 通过 R 自然融合 |
| 异常值鲁棒性 | 较弱 | 可通过门限和增益调节 |
误区/复盘:初学者最容易踩的坑
第一个误区是把卡尔曼滤波当成“更高级的匹配算法”。实际上,它不直接输出配对结果,而是输出关系状态的后验分布。配对决策仍然需要额外的判定逻辑。第二个误区是忽略协方差初始化。如果初始 P 设得过小,滤波器会过度自信,导致后续观测难以纠正错误关系。第三个误区是混淆过程噪声和观测噪声的物理含义。Q 描述模型未建模的动态,R 描述观测误差,两者不能随意互换。
第四个误区是认为卡尔曼滤波只能处理线性高斯问题。标准卡尔曼滤波确实要求线性高斯,但工程中可以通过扩展卡尔曼滤波、无迹卡尔曼滤波或粒子滤波处理非线性关系。本课程会先夯实标准卡尔曼滤波在配对建模中的核心思想,再逐步扩展到非线性场景。
复盘要点:动态配对关系建模的失败,往往不是卡尔曼滤波公式写错,而是关系状态定义不清、噪声参数与实际业务不匹配、缺少生命周期管理。建模前先问:关系状态是什么?观测是什么?不确定性来自哪里?
学习目标与整体课程框架
通过本课程,你将掌握以下能力:能够把业务中的动态配对问题转化为状态空间模型;能够独立实现卡尔曼滤波的预测与更新;能够设计关系状态、观测模型和噪声参数;能够处理观测丢失、异常值和多源融合;能够将算法落地到多目标跟踪、出行派单、设备关联等真实场景。
整体课程分为六个模块:第一模块建立动态配对与卡尔曼滤波的基础认知;第二模块深入状态空间建模与参数估计;第三模块讲解数据关联、门限与生命周期管理;第四模块扩展到非线性卡尔曼滤波;第五模块进行工程优化与性能调优;第六模块完成一个完整的实战项目。每章都会围绕“原理—流程—案例—复盘”展开,确保你不仅理解公式,更能写出可运行的代码。
实战项目概览
课程实战项目将构建一个“动态目标配对与跟踪系统”。系统输入为多帧观测数据,输出为每个目标的持续配对关系和轨迹估计。项目包含数据模拟、状态定义、滤波器实现、关联决策、可视化评估五个阶段。你将亲手调整 Q、R、P0 等参数,观察它们对配对稳定性和跟踪精度的影响。最终,你会得到一个可复用的动态配对建模框架,并能将其迁移到自己的业务场景中。
项目目录建议:
dynamic_pairing_kf/
├── data/           # 模拟观测与真实轨迹
├── models/         # 状态转移、观测模型
├── filters/        # 卡尔曼滤波实现
├── association/    # 配对判定与门限
├── evaluation/     # 精度与稳定性指标
└── main.py         # 主流程入口
现在,你已经了解了卡尔曼滤波在动态配对关系建模中的价值、核心流程和课程全貌。接下来的章节将从最基础的状态空间表达开始,逐步带你进入可落地、可调优、可扩展的动态配对建模实战。