3. Optuna核心概念
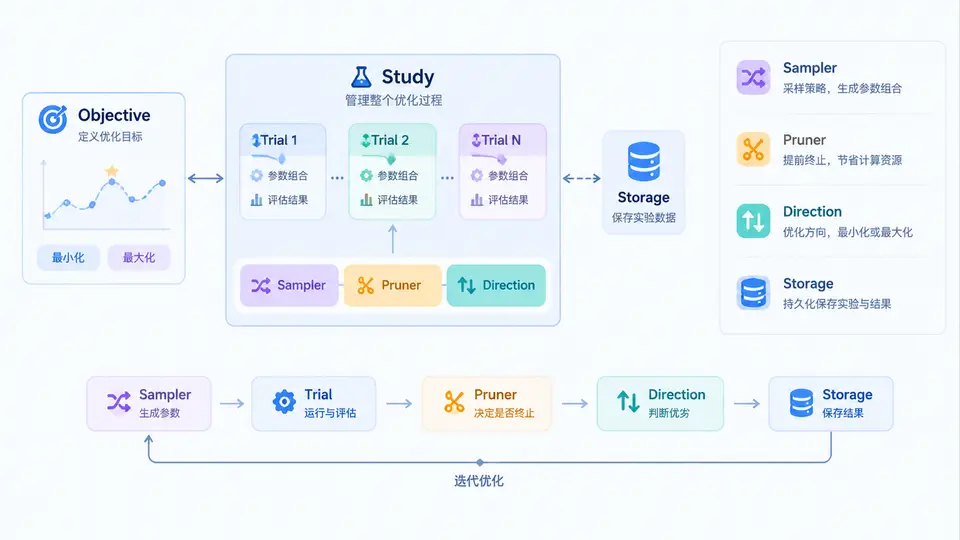
在上一节中,我们已经理解了超参数搜索为什么需要自动化框架。本节将进入 Optuna 的“骨架层”:把 Study、Trial、Sampler、Pruner、Objective、Direction 与 Storage 这七个核心概念一次讲清楚。它们不是孤立 API,而是一条完整的优化流水线:Objective 定义要优化什么,Direction 定义优化方向,Study 承载整个搜索任务,Trial 是单次尝试,Sampler 决定下一次试什么,Pruner 决定哪些 Trial 提前终止,Storage 负责持久化与共享。理解这条链路,后续做策略参数搜索与稳健优化时,才不会把“调参”写成“随机碰运气”。
一、核心原理:一次优化任务如何被拆解
Optuna 的抽象非常接近人类做实验的过程。假设你要为一条交易策略寻找最优参数组合,你不会只跑一次,而是会做很多次实验。每一次实验,就是一次 Trial;所有实验的集合,就是 Study。每次实验里,你告诉 Optuna “我要调哪些参数、范围是多少”,这由 Objective 函数中的 trial.suggest_* 完成。实验结束后返回一个分数,Optuna 根据 Direction 判断这个分数是越大越好还是越小越好。
接下来,Sampler 根据历史 Trial 的结果,决定下一个 Trial 的参数建议值。它决定了搜索效率:随机采样只是基线,TPE、CMA-ES 等会利用历史信息做更聪明的选择。Pruner 则负责“中途止损”:如果一个 Trial 在早期表现明显很差,就没必要跑完,直接剪枝,把算力留给更有希望的 Trial。Storage 决定这些 Trial 记录存在哪里:内存、SQLite、PostgreSQL 或 MySQL。没有 Storage,Study 只存在于当前进程;有了 Storage,才能断点续跑、多进程并行和结果复现。
一句话记忆:Study 是项目,Trial 是实验,Objective 是实验方法,Direction 是评分方向,Sampler 是下一步策略,Pruner 是早期淘汰机制,Storage 是实验记录本。
二、方法流程:从创建 Study 到拿到最优参数
下面用一个最小但完整的例子,把七个概念串起来。假设我们要优化一个策略的 fast_window 与 slow_window,目标是最大化夏普比率。
import optuna

def objective(trial):
    fast = trial.suggest_int("fast_window", 5, 30)
    slow = trial.suggest_int("slow_window", 31, 120)
    if fast >= slow:
        raise optuna.TrialPruned()
    score = backtest_strategy(fast, slow)
    return score

study = optuna.create_study(
    study_name="strategy_search",
    direction="maximize",
    sampler=optuna.samplers.TPESampler(seed=42),
    pruner=optuna.pruners.MedianPruner(n_startup_trials=5),
    storage="sqlite:///optuna_strategy.db",
    load_if_exists=True,
)

study.optimize(objective, n_trials=100, n_jobs=4)

print(study.best_trial.params)
print(study.best_value)
这段代码的执行流程可以拆成六步:
- 创建 Study:指定名称、方向、采样器、剪枝器和存储地址。
- 定义 Objective:在函数内部用
trial.suggest_*声明搜索空间。 - 运行 Trial:
study.optimize按n_trials反复调用 Objective。 - 采样决策:Sampler 根据已有 Trial 结果给出下一组参数。
- 剪枝判断:Pruner 根据中间报告值决定是否提前终止。
- 持久化与汇总:Storage 保存每次 Trial,最终通过
best_trial获取最优结果。
如果要做稳健优化,通常不会只看 best_value,而是会结合 study.trials_dataframe() 分析参数稳定性、回撤分布和不同市场阶段的表现。这时 Storage 的价值就非常明显:你可以把多次 Study 的结果统一存入数据库,再做横向对比。
三、案例/场景:策略参数搜索中的典型配置
在量化策略中,参数搜索往往面临三个现实问题:搜索空间大、单次回测慢、结果容易过拟合。Optuna 的七个概念正好对应这三类问题。下面给出一个更贴近实战的配置清单。
| 概念 | 作用 | 策略搜索中的典型用法 |
|---|---|---|
| Study | 承载一次完整优化任务 | 按策略品种或周期创建独立 Study,如 btc_1h_momentum |
| Trial | 单次参数组合实验 | 每次 Trial 对应一组均线、止损、仓位参数 |
| Objective | 定义参数空间与目标函数 | 内部调用回测引擎,返回夏普、Calmar 或自定义稳健分数 |
| Direction | 优化方向 | 最大化夏普用 maximize,最小化最大回撤用 minimize |
| Sampler | 决定下一组参数 | TPE 适合中小规模,CMA-ES 适合连续参数,GridSampler 用于小范围穷举 |
| Pruner | 提前终止差 Trial | MedianPruner 或 SuccessiveHalvingPruner 加速慢回测 |
| Storage | 持久化与共享 | SQLite 用于本地,PostgreSQL 用于团队并行与长期实验管理 |
例如,当单次回测需要 30 秒、搜索 500 组参数时,串行需要约 4 小时。使用 n_jobs=4 并行、配合 MedianPruner,通常可以把有效计算量降低 30% 到 60%。如果再使用 TPE 替代随机采样,在相同 Trial 数下往往能更快逼近较优区域。这就是 Sampler 与 Pruner 组合带来的工程收益。
四、误区与复盘:不要把它们当成孤立参数
误区一:只设置 direction,不设置 storage。很多人第一次使用 Optuna 时只写 direction="maximize",结果程序中断后所有 Trial 丢失。对于策略研究,建议从一开始就使用 SQLite 或 PostgreSQL,并设置 load_if_exists=True,这样可以随时续跑和复查。
误区二:把 Pruner 当成万能加速器。Pruner 依赖中间报告值。如果你的 Objective 只在最后返回一个分数,Pruner 无法工作。正确做法是在回测过程中按时间步或按折调用 trial.report() 与 trial.should_prune()。否则 Pruner 只是摆设。
误区三:Sampler 选得越复杂越好。TPE 并非在所有场景都优于随机采样。当搜索空间很小、参数高度离散,或 Trial 数很少时,随机采样反而更稳。建议先用 RandomSampler 建立基线,再切换到 TPE 或 CMA-ES 做对比。
误区四:忽略 Direction 与目标函数的一致性。如果 Objective 返回的是最大回撤,但 Direction 设为 maximize,Optuna 会努力寻找“最大回撤最大”的参数,结果完全相反。每次创建 Study 前,务必确认目标语义与方向一致。
复盘建议:每次完成一轮 Study 后,至少检查三件事:第一,study.trials_dataframe() 中是否存在大量被剪枝的 Trial;第二,最优 Trial 的参数是否落在搜索边界附近;第三,不同 Sampler 或随机种子下最优值是否稳定。这三点能帮你判断结果是真实稳健,还是过拟合噪声。