1. 课程导入
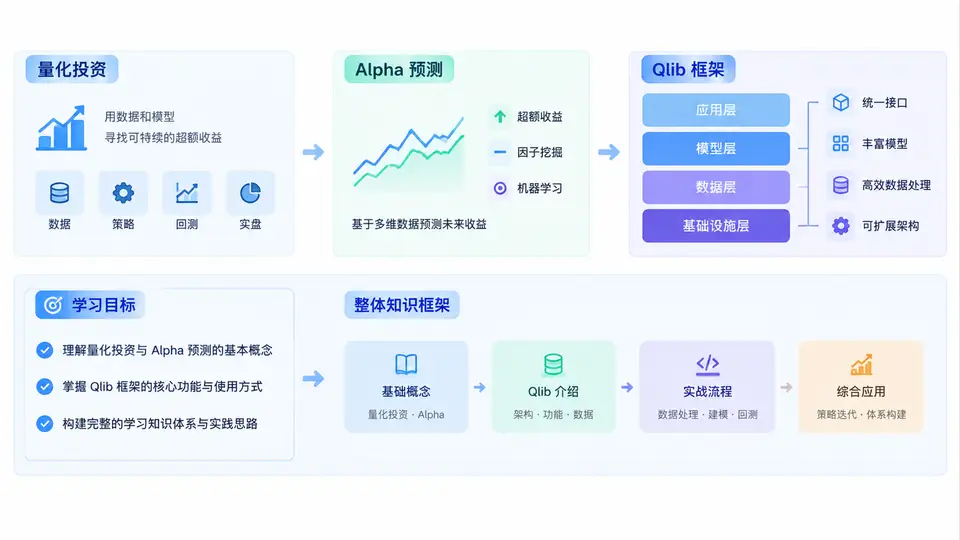
欢迎进入《Qlib机器学习Alpha预测实战》。在动手写第一行因子代码之前,我们需要先建立一张“认知地图”:量化投资到底在解决什么问题,Alpha预测在整条链路中处于什么位置,Qlib又为我们提供了哪些基础设施。本章不涉及复杂公式,但会决定你后续29章的学习效率——因为很多初学者失败,不是模型不会调,而是从一开始就把问题定义错了。
一、量化投资与Alpha预测的基本概念
量化投资的核心,是用可复现的规则和模型替代主观判断,在风险可控的前提下获取超额收益。这里有两个关键词:可复现与超额收益。可复现意味着你的决策逻辑必须能被数据、代码和参数完整描述;超额收益则指向一个专业术语——Alpha。
在资产定价语境中,收益通常被拆成两部分:一部分来自市场整体涨跌或风格暴露,称为Beta;另一部分来自选股、择时或另类信息带来的、与市场无关的收益,称为Alpha。用一句通俗的话说:Beta是“水涨船高”,Alpha是“船自己会划”。量化投资的目标,就是系统性地寻找并捕获Alpha。
Alpha预测,则是把“未来某只股票相对基准的超额收益”转化为一个可学习的监督问题。典型形式是:给定截至T日的历史量价、财务、舆情等特征,预测T+1到T+N日的收益或收益排序。它可以是回归问题(预测收益率数值),也可以是分类问题(预测涨跌),还可以是排序问题(预测横截面排名)。Qlib中的机器学习Alpha预测,主要围绕横截面排序展开:不要求预测绝对涨跌幅,而是要求把未来表现更好的股票排到前面。
核心认知:Alpha预测不是“猜涨跌”,而是在横截面上做相对排序。一个模型即使预测的所有股票都下跌,只要它把跌得少的股票排在前面,依然可能产生正Alpha。
二、从数据到交易:Alpha预测在量化链路中的位置
很多初学者一上来就研究LSTM、Transformer,却忽略了Alpha预测只是量化链路中的一环。完整链路通常包括:数据获取与清洗、因子构建、标签定义、模型训练、预测合成、组合优化、风险控制、交易执行与归因分析。Alpha预测位于“因子”与“组合”之间,它把原始特征转化为对未来收益的预测信号,再交给组合优化器决定买什么、买多少。
这意味着:模型精度不是唯一目标。一个IC很高但换手率爆炸的模型,扣除交易成本后可能亏损;一个IC一般但稳定性强、与现有因子低相关的模型,反而可能更有价值。因此,本课程会反复强调“预测—组合—成本”的联动视角。
下面这张图展示了从原始数据到最终持仓的典型流程,以及Qlib在其中的覆盖范围。请先建立整体印象,后续章节会逐层展开。
三、Qlib框架简介:为什么选择Qlib
Qlib是微软开源的AI量化投资平台,定位不是“帮你赚钱的策略库”,而是面向机器学习工作流的量化研究基础设施。它解决的是量化研究中大量重复、易错、难复现的工程问题:数据对齐、时间序列切分、因子表达式计算、模型训练与回测的统一接口。
Qlib的核心能力可以概括为以下几层:
- 数据层:支持本地二进制格式(.bin)高效存储,提供统一的数据查询接口,避免每次训练都从CSV重新读取。
- 表达式引擎:用类似公式的表达式定义因子,例如
Ref($close, 1)/$close - 1表示昨日收益率,自动处理横截面与时间序列运算。 - 工作流(qrun):通过YAML配置文件串联数据、模型、训练、回测,一条命令完成实验。
- 模型库:内置LightGBM、MLP、LSTM、Transformer、GAT等模型,也支持自定义PyTorch模型。
- 回测与评估:提供IC、ICIR、Rank IC、年化收益、最大回撤、换手率等指标,支持基于预测信号的简单策略回测。
与从零搭建相比,Qlib最大的价值在于标准化。它让“数据—因子—模型—回测”的接口统一,使实验可复现、可对比。对于学习者而言,这意味着你可以把精力集中在Alpha逻辑本身,而不是反复处理数据泄漏和日期对齐。
学习建议:本课程后续所有实验都基于Qlib。请先确保你能运行qrun完成一次内置工作流,再深入模型细节。环境配置问题越早解决,后续学习越顺畅。
四、课程学习目标与整体知识框架
本课程共30章,目标是让你具备独立完成一个机器学习Alpha预测实验的能力,并能正确评估结果、识别常见陷阱。具体目标包括:
- 理解量化投资与Alpha预测的基本概念,能区分Beta与Alpha、回归与排序任务。
- 掌握Qlib的数据组织、表达式引擎与工作流配置,能独立编写YAML实验配置。
- 掌握因子构建与标签定义方法,理解时间序列切分与数据泄漏的防范。
- 掌握LightGBM、MLP、LSTM、Transformer等模型在Alpha预测中的使用与调参。
- 能读懂IC、Rank IC、回测曲线与换手率,并对实验结果进行归因分析。
- 能识别过拟合、未来函数、幸存者偏差等常见误区,并知道如何复盘修正。
整体知识框架可以按“四层递进”理解:
| 层次 | 核心内容 | 对应章节范围 | 学习产出 |
|---|---|---|---|
| 基础层 | 量化概念、Qlib环境、数据与表达式 | 第1–8章 | 能跑通内置工作流,理解数据格式 |
| 特征层 | 因子构建、标签设计、预处理与切分 | 第9–15章 | 能自定义因子与标签,避免数据泄漏 |
| 模型层 | 树模型、神经网络、序列模型与调参 | 第16–24章 | 能训练并对比多种Alpha模型 |
| 评估与实战层 | 回测指标、组合构建、归因与复盘 | 第25–30章 | 能独立完成端到端实验并撰写报告 |
五、常见误区与学习心态
在正式开始之前,先列出几个高频误区,它们会贯穿整个课程:
- 误区一:把回测收益当成真实收益。回测中的高收益可能来自过拟合、未来函数或忽略交易成本。后续章节会教你如何识别。
- 误区二:只关注模型,不关注数据与标签。在Alpha预测中,特征和标签的质量往往比模型结构更重要。
- 误区三:用随机切分处理时间序列。金融数据必须按时间切分,否则未来信息会泄漏到训练集,导致回测虚高。
- 误区四:追求单一高IC,忽略稳定性与换手。IC的均值和方差同样重要,换手率直接影响净收益。
重要提醒:本课程所有内容仅用于教学与研究,不构成任何投资建议。量化策略在实盘中面临流动性、冲击成本、监管变化等复杂因素,请勿直接将课程实验用于真实资金交易。