3. 实验管理核心概念
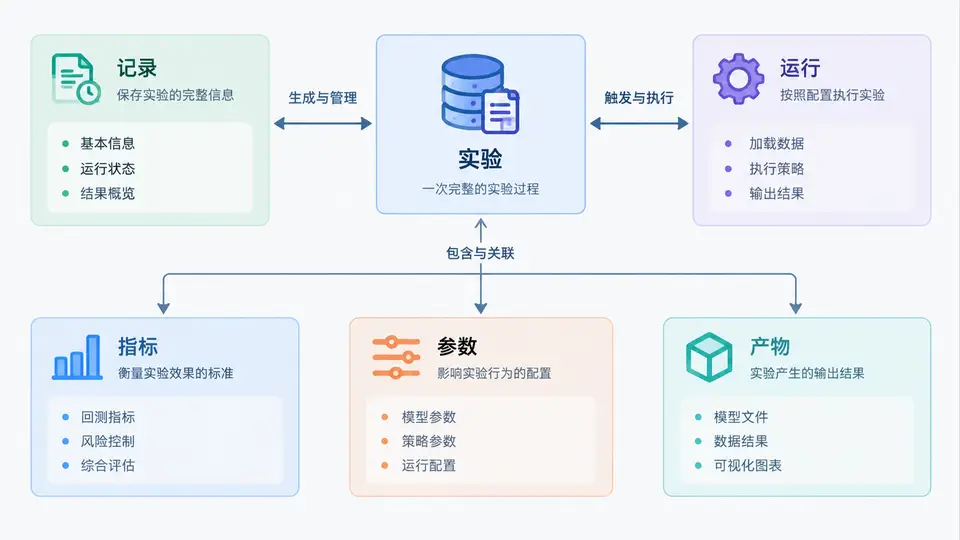
在量化研究中,真正拖慢团队效率的往往不是模型本身,而是“这次结果到底是怎么跑出来的”说不清楚。Qlib 的实验管理模块(基于 MLflow 的封装)正是为了解决这个问题:它把一次研究活动拆解为可追踪、可比较、可复现的结构化对象。理解这些对象的定义与关系,是后续做信号评估、模型对比和回滚复现的前提。
一、核心原理:六个概念的分层结构
Qlib 实验管理中的六个核心概念并非平级,而是存在明确的“容器—归属—度量”三层关系。可以先用一句话概括:实验是容器,运行是执行单元,记录是运行的元数据快照,参数与指标是记录的输入与输出,产物是运行留下的文件资产。
- 实验(Experiment):最高层组织单位,通常对应一个研究主题,例如“Alpha158 因子集在 CSI300 上的验证”。它本身不产生结果,只负责聚合多次运行,便于横向比较。
- 运行(Run):一次具体的执行实例,例如“用 LightGBM 训练 2020-2022 数据”。每次运行有唯一 ID,是参数、指标、产物的实际挂载点。
- 记录(Record):运行过程中写入的元数据条目,包括参数、指标、标签、时间戳等。它是“运行”的可查询视图,也是 MLflow UI 中展示的最小信息单元。
- 参数(Param):运行开始前确定的输入配置,如学习率、最大深度、因子列表版本。参数一旦写入,原则上不应在运行中修改。
- 指标(Metric):运行过程中或结束后产生的数值结果,如 IC、ICIR、年化收益、最大回撤。指标可随时间步记录,形成曲线。
- 产物(Artifact):运行输出的文件,如模型权重、预测分数 CSV、因子重要性图、回测净值曲线。产物体积大,通常存于对象存储或本地目录。
二、方法流程:一次标准实验的生命周期
下面以 Qlib 中一次典型的模型训练与评估为例,展示这些概念如何在实际代码中落地。Qlib 提供了 R 记录器接口,底层对接 MLflow。
from qlib.workflow import R
from qlib.workflow.record_temp import SignalRecord, PortAnaRecord

# 1. 创建/获取实验(容器)
with R.start(experiment_name="alpha158_lgb_csi300"):
    # 2. 启动一次运行(执行单元)
    R.log_params(
        model="LightGBM",
        learning_rate=0.05,
        num_leaves=64,
        factor_set="Alpha158",
        train_period="2020-01-01~2022-12-31"
    )

    # 3. 训练模型并记录指标
    model.fit(dataset)
    pred = model.predict(dataset)
    R.log_metrics(ic=0.042, icir=0.31, rank_ic=0.038)

    # 4. 保存产物
    R.save_objects(model=model, prediction=pred)
    R.log_artifact("feature_importance.png")

    # 5. 生成标准记录(SignalRecord / PortAnaRecord)
    sr = SignalRecord(model, dataset, recorder=R)
    sr.generate()
    par = PortAnaRecord(recorder=R, config=backtest_config)
    par.generate()
执行后,MLflow 中会形成如下结构:实验 alpha158_lgb_csi300 下挂载一次运行,运行内包含 5 个参数、3 个标量指标、2 个对象产物和 1 个图片产物。若再跑一次不同学习率的配置,则新增一次运行,两次运行共享同一实验,可直接在 UI 中对比指标。
| 概念 | 典型示例 | 存储位置 | 是否可比较 |
|---|---|---|---|
| 实验 | alpha158_lgb_csi300 | MLflow backend | 否(容器) |
| 运行 | run_id=a1b2c3 | MLflow backend | 是(跨运行) |
| 参数 | learning_rate=0.05 | 运行元数据 | 是 |
| 指标 | IC=0.042 | 运行元数据 | 是 |
| 产物 | model.pkl / pred.csv | artifact store | 否(需下载) |
三、案例场景:用实验管理定位“信号衰减”问题
假设团队发现某因子上周 IC 为 0.05,本周骤降到 0.01。若没有实验管理,只能凭记忆猜测。有了结构化记录后,排查路径如下:
- 在实验
alpha158_lgb_csi300中筛选最近两周的运行。 - 对比两次运行的参数:发现本周运行将
train_period延长到了最新数据,但factor_set未更新版本。 - 查看指标曲线:IC 在训练集内正常,在验证集上衰减,说明是因子失效而非代码 bug。
- 下载产物中的
feature_importance.png,确认原核心因子权重被新数据稀释。 - 基于历史运行回滚到旧参数组合,快速验证假设。
R.set_tags(stage="validation", owner="quant_a")。标签虽不属于六大核心概念,但能显著提升实验的可检索性。
四、误区与复盘
误区一:把实验当运行。 有人每跑一次就新建一个实验,导致实验数量爆炸,无法横向对比。正确做法是一个研究主题一个实验,多次调参对应多次运行。
误区二:指标与产物混用。 把预测分数 CSV 当作指标记录,导致 MLflow 元数据膨胀。指标应是标量或时间序列数值,大文件必须走产物通道。
误区三:参数记录不全。 只记录模型超参,却漏掉数据版本、因子集版本、随机种子。复现时“差之毫厘,谬以千里”。建议将数据快照 ID 也作为参数写入。
误区四:忽略记录(Record)的中间态。 只记录最终 IC,不记录训练过程中的 loss 曲线,导致无法判断过拟合发生的 epoch。Qlib 的 log_metrics(step=...) 支持逐步记录。