3. 数据基础与获取
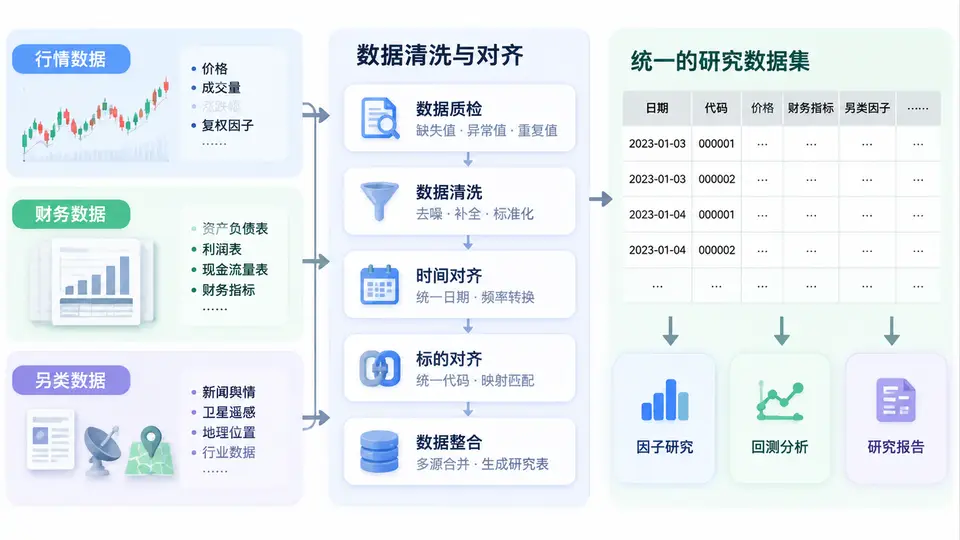
多因子研究的上限,往往不是模型不够复杂,而是数据基础不够扎实。因子计算的每一步都建立在“数据是否正确、是否可比、是否对齐”的前提上。本章聚焦三件事:数据从哪里来、数据如何清洗、不同频率与不同主体的数据如何对齐。掌握这三件事,后续的因子构建与回测才有可信的起点。
一、核心原理:三类数据与三种对齐维度
多因子研究常用的数据可分为三大类。第一类是行情数据,包括日频的开高低收、成交量、成交额、复权因子、换手率、涨跌停状态等,它决定了价格类与技术类因子的计算基础。第二类是财务数据,包括利润表、资产负债表、现金流量表及衍生指标,它决定了估值、质量、成长类因子的计算基础。第三类是另类数据,包括分析师预期、股东户数、舆情、供应链、卫星与消费数据等,它用于构建差异化因子,但获取成本与稳定性差异极大。
数据对齐的本质是解决三个维度的问题:时间对齐(不同频率的数据如何映射到同一交易日)、主体对齐(股票代码变更、退市、并购后如何保持实体一致)、口径对齐(同一指标在不同来源下定义是否一致)。任何一类对齐出错,都会在因子暴露中引入系统性偏差。
二、方法流程:从获取到可用的五步链路
- 数据获取:行情数据可通过交易所公开接口、行情商API或本地数据库获取;财务数据优先使用带公告日字段的结构化数据库;另类数据需评估覆盖率、更新频率与历史回溯长度。
- 字段校验:检查缺失率、异常值、单位一致性(如万元与元)、重复记录与主键冲突。
- 清洗处理:处理停牌、涨跌停、ST状态、极端值;对财务数据做同比与环比的口径统一。
- 频率对齐:将低频数据(如季度财务)按公告日映射到日频;将高频数据(如分钟行情)聚合为日频。
- 实体对齐:维护股票代码与实体ID的映射表,处理代码变更、退市与重组。
下面是一个典型的财务数据按公告日对齐到交易日的处理片段,使用Python与pandas表达:
import pandas as pd

# fin: 财务数据,含 code, report_date, announce_date, roe
# trade: 交易日历,含 trade_date
fin = fin.sort_values(["code", "announce_date"])
trade = trade.sort_values("trade_date")

# 对每只股票,将公告日之后最近的交易日作为生效日
merged = pd.merge_asof(
    trade.assign(code=trade["code"]),
    fin,
    left_on="trade_date",
    right_on="announce_date",
    by="code",
    direction="forward"
)

# 仅保留公告日已发生的记录,避免未来函数
merged = merged[merged["announce_date"] <= merged["trade_date"]]
这段代码的核心是merge_asof的direction="forward",它保证每个交易日只使用当日或之前已公告的财务数据。若省略这一步,回测中会出现“用未来财报预测过去价格”的严重错误。
三、案例场景:一条多因子流水线的数据准备
假设我们要构建一个包含价值、动量、质量三类因子的日频选股模型。数据准备可以按以下清单推进:
| 数据类别 | 关键字段 | 频率 | 对齐方式 | 常见问题 |
|---|---|---|---|---|
| 行情数据 | 收盘价、复权因子、成交额 | 日频 | 直接按交易日对齐 | 复权方式不统一 |
| 财务数据 | 净利润、净资产、ROE | 季度 | 按公告日映射到日频 | 公告日缺失或滞后 |
| 分析师预期 | 一致预期EPS、目标价 | 不定期 | 按发布日映射 | 覆盖率低、更新稀疏 |
| 股东数据 | 股东户数、机构持股 | 季度/不定期 | 按公告日映射 | 披露频率低 |
在这个场景中,最容易被忽视的是分析师预期数据。它的发布日不固定,且同一股票在同一天可能有多家机构更新。正确做法是先按股票与日期聚合为一致预期,再按发布日对齐到交易日,而不是简单按报告期填充。
四、误区与复盘:数据清洗中的四个高频陷阱
- 陷阱二:复权处理不一致。前复权与后复权在计算动量因子时结果不同,必须在全流程中统一复权方式,并在文档中明确记录。
- 陷阱三:停牌与涨跌停未处理。停牌期间价格不变,会人为压低波动率;涨跌停日无法成交,若纳入调仓会高估策略容量。
- 陷阱四:实体对齐缺失。股票代码变更或退市后,若未维护实体映射,因子面板会出现断裂,导致横截面排序错误。
复盘时建议做一次“数据可用性审计”:对每个字段统计历史覆盖率、缺失率、异常值比例,并抽样检查公告日与报告期的对应关系。审计通过后,再进入因子计算环节。数据基础的质量,直接决定了多因子研究报告的可信度。