1. 课程导入
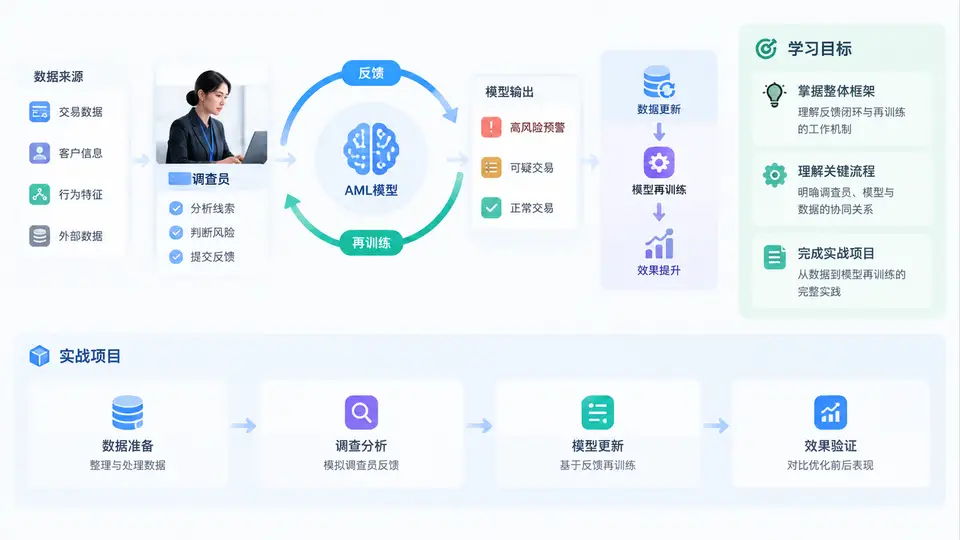
欢迎进入《AML调查员反馈闭环与模型再训练实战》。在反洗钱(AML)工作中,很多团队已经部署了交易监控系统与可疑活动识别模型,但真正困扰一线调查员和模型负责人的,往往不是“有没有模型”,而是模型报警是否精准、调查结论是否被系统吸收、模型能否持续进化。本课程的核心,就是帮助你把调查员的专业判断转化为可复用的数据资产,并驱动模型再训练,形成可持续的反馈闭环。
一、学习目标
完成本课程后,你应当能够独立设计并运行一个最小可行的AML反馈闭环,具体目标包括:
- 理解闭环本质:掌握“报警—调查—反馈—再训练—评估—上线”的完整链路,明确每个环节的输入、输出与责任人。
- 掌握反馈数据化方法:能够将调查员的定性结论(如“误报”“可疑”“需持续观察”)转化为结构化标签、置信度和原因码。
- 具备再训练实战能力:能够基于反馈数据构造训练集、选择再训练策略、设置评估指标,并识别数据漂移与标签偏差。
- 规避常见误区:理解“反馈即真相”“再训练越频繁越好”“模型指标高就等于业务有效”等典型陷阱。
- 完成一个端到端项目:以真实场景为蓝本,交付一份可运行的反馈闭环方案与再训练报告。
二、AML调查员反馈闭环与模型再训练的整体框架
AML反馈闭环不是简单的“调查员填个表”,而是一个数据流、决策流与治理流三流合一的系统工程。整体框架可以概括为五个阶段:
- 报警生成:模型基于规则、特征或机器学习输出报警,附带风险评分、触发原因和优先级。
- 调查处置:调查员结合客户背景、交易上下文、名单筛查结果进行研判,形成结论与证据。
- 反馈采集:将调查结论结构化为标签(如确认可疑、误报、无法判断)、原因码、置信度和备注。
- 再训练准备与执行:对反馈数据清洗、采样、标注一致性校验,构造训练集并触发再训练。
- 评估与上线:通过离线指标与业务指标双重评估,决定是否上线、灰度或回滚,并记录模型版本。
这五个阶段首尾相连,形成闭环。其中,反馈采集是最容易被忽视却最关键的环节:如果反馈字段设计粗糙,后续再训练就会“垃圾进、垃圾出”。
从工程视角看,闭环的落地依赖三类数据表:报警表(记录模型输出)、调查表(记录人工结论)、模型版本表(记录每次再训练的数据快照与指标)。三者通过报警ID和模型版本号关联,才能实现可追溯。
三、核心原理:反馈为什么能驱动模型进化
机器学习模型在AML场景中面临两个天然难题:标签稀缺和概念漂移。可疑交易本身占比极低,且犯罪手法不断变化,模型上线时的决策边界很快会过时。调查员的反馈恰好提供了两类关键信息:
- 真实标签的近似:调查结论虽然不是绝对真相,但它是当前可获得的最接近业务判断的标签来源。
- 错误模式的定位:误报集中的特征区间、漏报暴露的规则盲区,都是再训练的重点方向。
因此,反馈闭环的本质是:用人工判断持续修正模型的经验风险,使模型逼近当前业务环境下的真实风险分布。但要注意,反馈数据存在选择偏差——只有被报警的样本才会被调查,未被报警的样本没有反馈。这要求再训练时结合主动学习或抽样调查来补充盲区。
四、方法流程:一个可落地的最小闭环
为了让理论可操作,下面给出一个最小闭环的流程清单。你可以把它当作项目启动的检查表:
| 阶段 | 关键动作 | 产出物 | 责任人 |
|---|---|---|---|
| 报警生成 | 模型打分、生成报警ID、记录特征快照 | 报警明细表 | 模型工程师 |
| 调查处置 | 研判、取证、填写结论与原因码 | 调查记录表 | AML调查员 |
| 反馈采集 | 结构化标签、置信度、复核抽样 | 反馈标签集 | 调查主管/数据专员 |
| 再训练 | 数据清洗、采样、特征对齐、训练 | 新模型版本 | 模型工程师 |
| 评估上线 | 离线指标、业务指标、灰度验证 | 评估报告与上线决策 | 模型负责人/合规 |
在技术实现上,反馈采集通常以结构化表单或API写入方式完成。例如,调查员提交反馈时,系统可记录如下JSON结构:
{
  "alert_id": "AML-2024-000871",
  "investigator_id": "INV-0231",
  "conclusion": "false_positive",
  "reason_code": "customer_verified_income",
  "confidence": 0.85,
  "evidence_ref": "KYC-2024-0456",
  "feedback_time": "2024-06-12T10:32:00Z"
}
再训练触发可以采用定时批处理或反馈量阈值触发。例如,当新增有效反馈样本超过500条,或距上次训练超过30天时,自动启动再训练流水线:
# 伪代码:反馈量阈值触发再训练
if new_feedback_count >= 500 or days_since_last_train >= 30:
    build_training_set(feedback_data, baseline_data)
    train_model(config="aml_xgb_v2.yaml")
    evaluate_and_register()
五、案例与场景:从误报风暴到精准报警
某银行交易监控团队曾面临典型困境:每月产生约1.2万条报警,调查员人均每日处理超过40条,其中约92%被标记为误报。模型团队每季度再训练一次,但误报率没有明显下降。问题出在哪里?
复盘发现三个断点:第一,调查员的结论只写在自由文本备注中,没有结构化标签,再训练时无法使用;第二,误报原因没有分类,模型团队不知道是规则阈值过严还是特征缺失;第三,再训练仍使用旧标签,没有纳入新反馈。改进后,团队引入原因码体系,将误报归为“客户行为合理解释”“规则阈值过严”“名单误匹配”等八类,并按月触发再训练。三个月后,报警量下降约35%,确认可疑的命中率提升近一倍。
六、常见误区与复盘要点
在启动闭环项目前,先认清以下误区,可以少走大量弯路:
- 误区一:反馈越多越好。低质量、重复或矛盾的反馈会污染训练集。应设置复核机制与置信度过滤。
- 误区二:再训练越频繁越好。频繁再训练可能导致模型不稳定、版本管理混乱。应结合反馈积累量和业务节奏设定触发条件。
- 误区三:只看AUC或准确率。AML场景中正样本极少,应重点关注召回率、误报率、报警量和调查员工作量。
- 误区四:忽略概念漂移。即使反馈闭环运行良好,也要监控特征分布和业务环境变化,必要时引入漂移检测。
- 误区五:调查员不参与评估。模型上线后应收集调查员对新报警的反馈,形成二次闭环。
复盘时建议回答四个问题:反馈覆盖率是多少?标签一致性如何?再训练后业务指标是否改善?调查员负担是否下降?只有这四个问题都有正向答案,闭环才算真正跑通。
七、课程实战项目介绍
本课程将围绕一个贯穿始终的实战项目展开:为一家中型银行的AML监控团队搭建反馈闭环与再训练流水线。项目分为四个里程碑:
- 里程碑一:反馈体系设计。设计调查反馈表单、原因码字典、置信度规则与数据表结构。
- 里程碑二:反馈数据治理。完成数据清洗、一致性校验、样本采样与训练集构造。
- 里程碑三:模型再训练与评估。基于反馈数据训练新模型,对比新旧版本在离线与业务指标上的表现。
- 里程碑四:上线与监控。设计灰度方案、回滚策略与持续监控看板,形成可运营的闭环。
项目数据将提供脱敏样本与模拟反馈,你也可以替换为自己机构的真实数据。每个里程碑都配有可运行的代码模板、配置示例和检查清单,确保你不仅听懂,更能动手做出来。