1. 课程导入
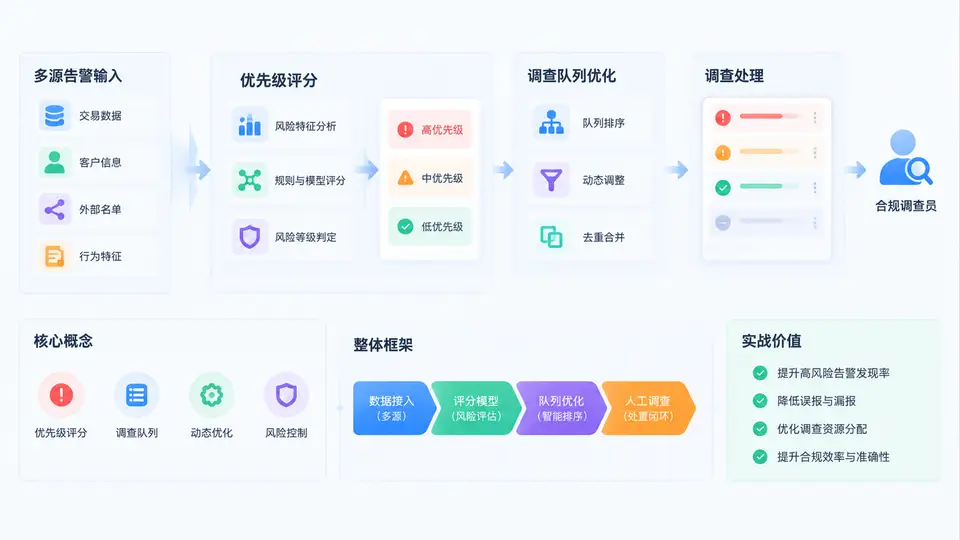
欢迎进入《AML告警优先级评分与调查队列优化实战》。在反洗钱(Anti-Money Laundering, AML)日常运营中,真正稀缺的往往不是告警数量,而是调查人员的注意力与时间。一个中等规模的金融机构,每天可能产生数千条交易监控告警,其中绝大多数最终被判定为“无实质风险”,但调查人员仍必须逐条查看、记录、升级或关闭。若没有合理的优先级评分与队列管理机制,高风险案件会被淹没在低风险告警中,监管处罚、声誉损失与客户流失风险随之上升。本课程的目标,不是教大家“多抓几个坏人”,而是建立一套可解释、可落地、可迭代的告警优先级评分与调查队列优化体系,让正确的人在正确的时间处理正确的告警。
学习目标
完成本课程后,学员应能够:
- 理解AML告警优先级评分的核心逻辑:风险信号、客户背景、交易行为、监管关注与历史处置结果的综合加权。
- 掌握从原始告警到调查队列的完整流程:数据接入、特征工程、评分模型、队列排序、动态分配与反馈闭环。
- 能够设计或优化一套可解释的评分卡,并针对不同业务场景(零售银行、对公业务、跨境支付、虚拟资产)调整权重与阈值。
- 识别常见误区,例如“高分即高风险”“模型替代调查”“队列只看分数不看容量”等,并掌握复盘方法。
- 通过实战案例,理解如何用有限人力将高价值告警的首次响应时间缩短30%以上,同时降低误报积压。
核心概念:从告警到队列的五个关键对象
在进入具体方法之前,先统一语言。AML告警优先级评分与调查队列优化涉及五个核心对象:
| 概念 | 定义 | 在优化中的作用 |
|---|---|---|
| 告警(Alert) | 由交易监控规则、模型或名单命中产生的待调查事件。 | 队列的基本输入单元,数量大、噪声高。 |
| 优先级评分(Priority Score) | 对告警潜在风险与紧急程度的量化表达,通常为0-100或0-1。 | 决定告警在队列中的相对位置,而非最终结论。 |
| 调查队列(Investigation Queue) | 按优先级、容量、技能与时效要求排序后的待处理告警集合。 | 连接评分与人力调度的执行载体。 |
| 处置反馈(Disposition Feedback) | 调查人员对告警的最终判定:可疑、不可疑、需升级、需补充信息等。 | 用于校准评分模型与队列策略,形成闭环。 |
| 服务等级目标(SLO) | 对不同优先级告警设定的首次响应与完成时限。 | 约束队列优化方向,避免只追求分数而忽略时效。 |
关键认知:优先级评分不是风险结论,而是“注意力分配器”。它的价值在于让高价值告警更早被看到,而不是替代调查判断。
整体框架:四层闭环
本课程将围绕一个四层闭环展开,每一层都对应后续章节的实战模块:
- 数据与特征层:整合客户静态信息、交易行为、名单命中、地域风险、渠道特征与历史告警处置结果。特征质量直接决定评分上限。
- 评分与排序层:采用规则加权、评分卡或轻量机器学习模型,输出可解释的优先级分数,并结合业务规则进行队列排序。
- 队列与调度层:考虑调查人员技能、容量、班次、SLO与告警类型,将排序结果转化为可执行的任务分配。
- 反馈与迭代层:收集处置结果、调查时长、升级率与误报率,定期校准权重、阈值与队列策略。
实战价值:为什么值得投入
很多团队在AML调查上投入大量人力,却仍然面临“高优先级告警响应慢、低风险告警积压、监管检查时无法证明资源分配合理”的问题。优先级评分与队列优化的实战价值体现在三个层面:
- 效率层面:通过排序将高价值告警前置,减少调查人员在低风险告警上的无效耗时。典型场景下,首次响应时间可缩短30%-50%。
- 合规层面:可解释的评分与队列策略能够向监管展示“资源分配有依据、高风险优先处理”,降低因流程缺陷被处罚的风险。
- 团队层面:调查人员从“被队列推着走”转变为“按优先级主动处理”,工作满意度与留存率提升。
提示:不要一开始就追求复杂模型。一个由5-8个特征组成的透明评分卡,往往比黑箱模型更容易落地、更容易被调查人员信任,也更容易通过监管解释。
案例场景:从“先到先得”到“风险优先”
假设某银行反洗钱团队每天收到1200条告警,现有8名调查员,每人每天可处理约20条,总容量160条。这意味着每天有1040条告警积压。原队列采用“先到先得”,导致一条涉及跨境高风险地区、金额巨大且客户历史有可疑记录的告警,可能因为产生时间较晚而被排在数百条低风险告警之后。引入优先级评分后,该告警得分92分,被排入队列前5%,调查员在2小时内完成首次响应,并最终上报可疑交易报告。而大量得分低于20分的告警则进入批量处理或自动关闭流程。这个转变的核心不是增加人力,而是改变注意力分配方式。
示例:简化优先级评分卡(0-100分)
客户风险等级:高=25,中=15,低=5
交易金额偏离度:>3倍均值=20,1-3倍=10,其他=0
跨境/高风险地区:是=20,否=0
名单命中:强命中=30,弱命中=15,无=0
历史告警处置:曾上报=15,曾升级=10,无=0
渠道风险:虚拟资产/第三方支付=10,其他=0

某告警得分:25+20+20+0+10+0 = 75分 → 高优先级
常见误区与复盘
在课程开始前,先列出几个高频误区,后续章节会逐一拆解:
- 误区一:高分等于高风险。评分高只代表“值得优先看”,不代表一定可疑。调查结论仍需人工判断。
- 误区二:模型上线即结束。没有反馈闭环的评分模型会在数月内失效,因为犯罪手法与客户行为都在变化。
- 误区三:队列只看分数。忽略调查员技能、容量与SLO,会导致高分告警堆积在少数人手中,整体时效反而下降。
- 误区四:追求100%自动化。AML调查需要专业判断,自动化应聚焦于排序、分配与低风险批量处置,而非替代调查。
警告:任何优先级评分体系都必须保留人工覆盖机制。当调查人员认为某条告警被低估时,应能手动提升优先级并记录原因,这些记录是后续校准的宝贵输入。
本章作为课程导入,已经勾勒出学习目标、核心概念、四层闭环框架与实战价值。接下来的章节将逐层深入,从特征工程到评分卡设计,从队列调度到反馈迭代,最终形成一套可在真实AML运营中落地的优先级评分与调查队列优化方案。