1. 课程导入
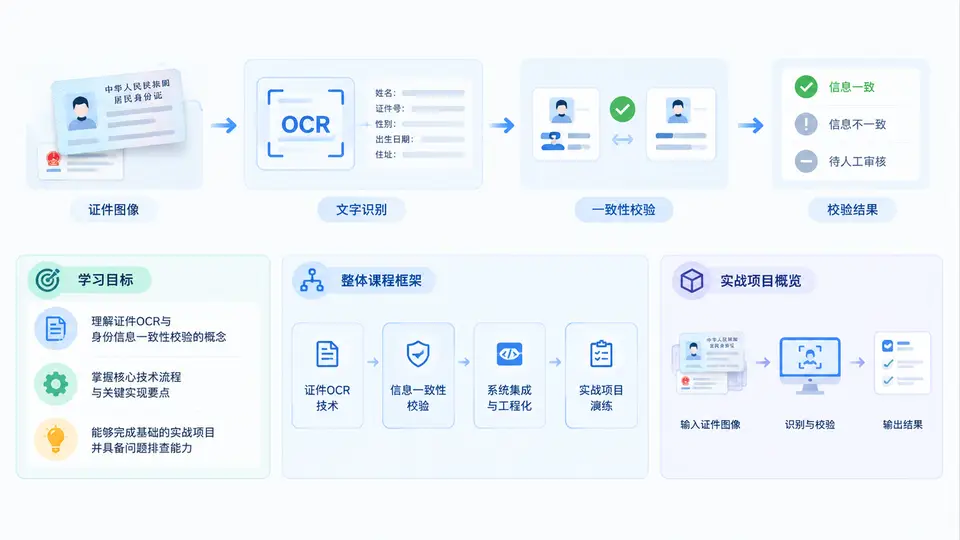
1.1 什么是证件OCR与身份信息一致性校验
证件OCR(Optical Character Recognition,光学字符识别)是指从身份证、护照、驾驶证、港澳通行证等证件图像中,自动定位并识别姓名、证件号码、有效期、签发机关等关键字段的技术过程。它并不是简单的“图片转文字”,而是包含图像预处理、版面分析、字段检测、字符识别、结构化输出等多个环节的工程流水线。
身份信息一致性校验,则是在OCR提取字段之后,进一步判断“证件上的信息”与“用户提交的信息”或“权威数据源中的信息”是否一致。例如:用户上传身份证照片,同时填写姓名和身份证号,系统需要判断照片中的姓名与填写姓名是否一致、号码是否合法且匹配、证件是否在有效期内、头像是否为本人等。
两者结合,构成了金融开户、酒店入住、网约车司机注册、政务一网通办、跨境电商KYC等场景的核心风控与体验环节。本课程不局限于“调一个OCR接口”,而是带你从工程视角构建可落地、可评估、可迭代的完整系统。
1.2 学习目标:学完你能做什么
本课程面向有一定Python基础、希望进入身份认证与风控领域的开发者、测试工程师和产品技术负责人。完成全部30章后,你应达到以下目标:
- 理解证件OCR的完整技术链路,能独立完成图像质量评估、字段定位与结构化提取。
- 掌握身份证号、姓名、有效期等字段的校验规则,包括校验位算法、日期逻辑与行政区划编码。
- 能够设计并实现“OCR结果 + 用户填写 + 权威库”三方一致性比对流程。
- 掌握常见异常处理:模糊、反光、遮挡、翻拍、PS篡改、边缘裁切等。
- 能够搭建可量化的评测集,使用字段级准确率、召回率、误识率等指标评估系统。
- 完成一个端到端实战项目:从上传证件到输出一致性结论与风险标签。
1.3 整体课程框架与实战项目概览
课程共30章,按“基础—识别—校验—工程—实战”五段式推进。前6章建立概念与开发环境;第7至14章深入OCR识别与图像处理;第15至22章聚焦一致性校验规则与算法;第23至27章讲解服务化、性能优化与安全合规;最后3章完成综合项目与复盘。
| 阶段 | 章节范围 | 核心内容 | 产出 |
|---|---|---|---|
| 基础导入 | 第1-6章 | 定义、场景、环境、数据、评测指标 | 可运行的最小OCR demo |
| 识别进阶 | 第7-14章 | 预处理、检测、识别、后处理、多证件适配 | 字段级结构化提取模块 |
| 一致性校验 | 第15-22章 | 规则引擎、校验位、模糊匹配、权威库比对 | 一致性判定服务 |
| 工程化 | 第23-27章 | API设计、并发、缓存、日志、安全合规 | 可部署的微服务 |
| 综合实战 | 第28-30章 | 端到端项目、压测、复盘与优化 | 完整项目报告 |
贯穿课程的唯一实战项目是“身份信息核验服务”:用户上传一张身份证正面照片,并填写姓名与身份证号,系统返回OCR字段、校验结果、一致性结论和风险等级。项目会随着章节推进不断叠加能力,最终形成一个可演示、可测试、可扩展的完整系统。
1.4 核心原理:从像素到可信结论
理解整体数据流,是避免“只会调包”的关键。下图展示了证件OCR与一致性校验的核心链路:
这条链路中,任何一环出错都会影响最终结论。例如预处理过度导致字符断裂,字段检测漏掉号码区域,或者校验规则把合法号码误判为非法。因此课程会反复强调可观测性:每一步都要有中间结果、日志和评测指标。
1.5 典型场景与常见误区
先看一个真实场景:某平台要求用户上传身份证并填写姓名、号码。用户照片清晰,OCR识别出姓名“张伟”、号码“110101199001011234”,但用户填写号码为“110101199001011235”。此时系统应如何判断?
- 第一步:校验号码校验位,发现填写号码校验位错误,直接判定为无效输入。
- 第二步:若填写号码合法但与OCR结果不一致,进入人工复核或要求重新上传。
- 第三步:若OCR结果本身置信度低,则不应直接拒绝用户,而应提示“照片不清晰,请重新拍摄”。
常见误区二:忽略图像质量。大量线上问题并非模型不行,而是用户拍摄时反光、遮挡、倾斜导致。
常见误区三:直接用字符串相等做一致性判断。姓名可能存在空格、生僻字、繁简体差异,号码可能存在空格或大小写X。
因此,一致性校验需要引入归一化、模糊匹配、置信度加权等策略。例如姓名比对时,先去除空格、统一繁简,再计算编辑距离;号码比对时,先去除空格、统一大写,再逐位比较并给出差异位置。
1.6 开发环境与最小可运行示例
课程使用Python 3.10+,主要依赖OpenCV、PaddleOCR或Tesseract、FastAPI、Pydantic。下面是一个最小示例,展示如何读取图像并调用OCR得到文本,再提取身份证号候选:
import re
import cv2
from paddleocr import PaddleOCR

ocr = PaddleOCR(use_angle_cls=True, lang="ch")
img = cv2.imread("id_card.jpg")
result = ocr.ocr(img, cls=True)

texts = [line[1][0] for line in result[0]]
full_text = " ".join(texts)

# 简单提取18位身份证号候选
id_pattern = re.compile(r"\d{17}[\dXx]")
candidates = id_pattern.findall(full_text)
print("OCR文本:", full_text)
print("身份证号候选:", candidates)
1.7 本章小结与实战任务
本章建立了三个关键认知:第一,证件OCR是包含多个环节的工程流水线,不是单一接口;第二,一致性校验的核心是“规则+比对+置信度”,而非简单字符串相等;第三,课程将以“身份信息核验服务”为主线,逐章叠加能力。