1. 课程导入
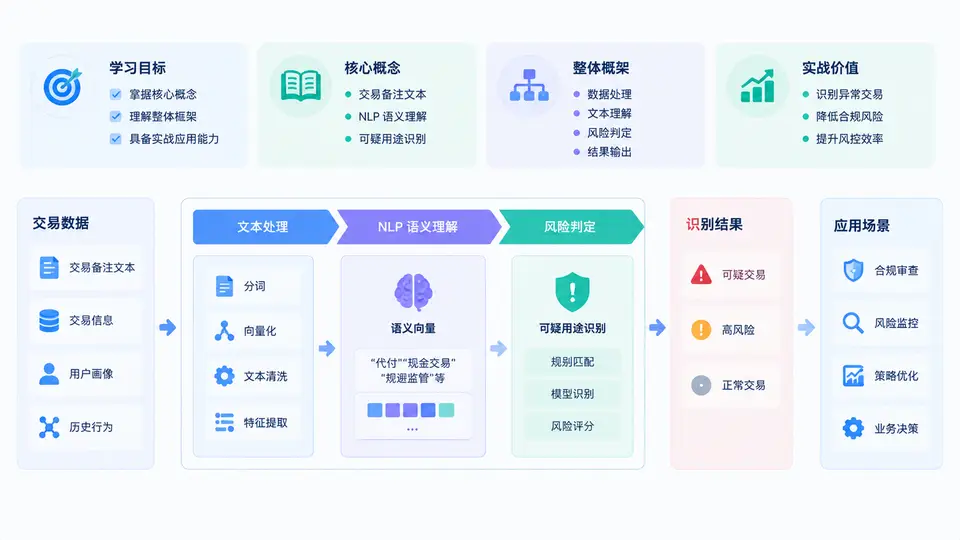
在反洗钱、反欺诈与交易合规的实际工作中,结构化字段往往只能回答“谁在什么时间转了多少钱”,而真正解释“这笔钱为什么转、用途是什么、是否合理”的信息,常常藏在客户填写的交易备注、附言、摘要、汇款用途说明等自由文本里。这些文本短、噪声大、语言混杂、缩写与错别字频繁,却承载着极高的风险信号密度。本课程的目标,就是帮助你把交易备注从“难以利用的附属信息”转化为“可建模、可解释、可落地的风险识别资产”。
一、学习目标:从文本到风险判断的完整能力链
本课程不是单纯讲NLP算法,也不是只讲合规规则,而是围绕“交易备注”这一高价值但难处理的文本对象,构建一条从数据到决策的完整能力链。学完本课程,你应当具备以下五类能力:
- 理解业务语义:能够区分交易备注中的正常用途表达、模糊表达、规避性表达与可疑用途暗示,理解其在反洗钱、反欺诈、贸易融资、跨境支付等场景中的风险含义。
- 掌握文本预处理:能够针对短文本、多语言、错别字、拼音缩写、符号混排等特点,设计清洗、归一化、分词与特征提取流程。
- 构建识别模型:能够根据数据规模与标注条件,选择规则引擎、传统机器学习、深度模型或大模型辅助方案,并完成训练、评估与调优。
- 落地可疑用途识别:能够把模型输出转化为可解释的风险标签、评分与预警信号,并与现有交易监控系统对接。
- 持续复盘与治理:能够识别误报、漏报、概念漂移与对抗性规避,建立样本回流、规则迭代与模型监控机制。
核心判断:交易备注NLP的价值不在于“把文本分类做得更准”,而在于把原本不可用的自由文本,转化为可审计、可解释、可行动的风险证据。模型只是中间环节,业务闭环才是终点。
二、核心概念:交易备注、可疑用途与NLP识别
在进入实战之前,需要先统一三个核心概念。第一,交易备注是指交易发起方或参与方在交易指令、汇款报文、支付订单、内部转账等环节填写的自由文本字段,例如“货款”“借款”“咨询费”“家庭生活费”“投资款”“还款”等。第二,可疑用途并不是一个法律定性,而是指在特定业务场景下,备注所表达的用途与客户身份、交易金额、交易频率、对手方特征、地域风险等不匹配,或存在明显的规避、掩饰、模糊化倾向。第三,NLP识别是指利用自然语言处理技术,对备注文本进行语义理解、分类、抽取与异常检测,从而辅助风险判断。
三者之间的关系可以用一个简单的逻辑链表达:备注文本提供“声称的用途”,交易上下文提供“实际的行为特征”,NLP模型负责把两者对齐并发现矛盾。真正有价值的可疑用途识别,往往不是单看一句话,而是看“这句话在这个客户、这笔交易、这个时间点上是否合理”。
| 备注类型 | 典型示例 | 风险含义 | 处理优先级 |
|---|---|---|---|
| 明确正常用途 | 工资、货款、房租、学费 | 语义清晰,与上下文匹配时风险较低 | 低 |
| 模糊用途 | 往来、周转、其他、备用 | 信息不足,可能掩盖真实目的 | 中 |
| 规避性表达 | 咨询费、服务费、信息费(无真实服务背景) | 常见于虚假贸易、洗钱分层 | 高 |
| 敏感用途暗示 | 投资、换汇、代付、刷单 | 可能涉及非法集资、地下钱庄、欺诈 | 高 |
| 噪声与无效文本 | 符号、乱码、单字、重复字符 | 本身信息量低,但异常模式可作为特征 | 视上下文 |
三、整体框架:从数据接入到风险决策的六层结构
为了让课程内容可落地,我们采用一个六层框架来组织交易备注NLP与可疑用途识别的完整流程。这个框架贯穿后续所有章节,也是你实际项目中搭建系统的参考蓝图。
- 数据接入层:对接交易流水、汇款报文、客户信息、对手方信息与历史预警记录,抽取备注字段及其上下文。
- 预处理与归一化层:完成编码统一、繁简转换、全半角转换、去噪、分词、词性标注与实体识别。
- 特征与表示层:构建关键词、TF-IDF、词向量、句向量、主题特征与规则特征,形成模型输入。
- 模型与规则层:结合规则引擎、机器学习分类器、深度模型与大模型辅助判断,输出用途标签与风险评分。
- 决策与解释层:将模型输出与交易上下文、客户画像、名单命中结果融合,生成可解释的预警理由。
- 运营与治理层:支持人工复核、样本回流、模型监控、规则迭代与合规审计。
实战提示:很多项目失败不是因为模型不够强,而是因为预处理阶段丢失了关键符号、缩写或语言变体,或者决策层没有把模型分数转化为调查人员能理解的证据。框架中的每一层都需要为下一层保留可追溯信息。
四、案例与场景:一句话如何触发风险预警
假设某客户在短时间内向多个不同对手方转账,金额均为接近但低于报告阈值的数值,备注分别填写“货款”“咨询费”“服务费”“往来款”。单看每一条备注,似乎都常见;但结合上下文,会发现三个异常:第一,客户身份是个人,却频繁出现“货款”“咨询费”等经营性用途;第二,对手方分散且无关联,交易时间集中;第三,金额刻意规避阈值。此时,NLP模型不仅需要识别备注的用途类别,还需要输出“用途与客户身份不匹配”“用途模糊度较高”“规避性表达概率”等信号。
再比如,某跨境汇款备注为“family support”,但汇款金额巨大、频率异常、收款地区属于高风险辖区。文本本身是正常的家庭支持表达,但与上下文矛盾,风险评分应显著上升。这说明可疑用途识别不能只做文本分类,而要做“文本—上下文—行为”的一致性校验。
示例:一条交易备注的结构化输出
{
  "remark_raw": "咨询费-项目尾款",
  "remark_norm": "咨询费 项目 尾款",
  "purpose_label": "咨询服务",
  "risk_flags": ["用途与个人身份不匹配", "金额接近阈值", "对手方分散"],
  "risk_score": 0.87,
  "explanation": "个人客户频繁以咨询费名义向多个无关联对手方转账,且金额接近报告阈值"
}
五、常见误区与复盘:避免“为了NLP而NLP”
在真实项目中,交易备注NLP最容易陷入以下误区。第一,把备注当成独立文本处理,忽略交易金额、频率、对手方、客户职业等上下文,导致模型在离线指标上表现不错,上线后误报率极高。第二,过度依赖关键词规则,虽然可解释性强,但面对拼音缩写、谐音、错别字、多语言混写时迅速失效。第三,盲目追求深度模型,在标注样本不足、类别不平衡、业务定义模糊的情况下,复杂模型往往不如“规则+轻量模型”稳定。第四,忽视可解释性,调查人员无法理解模型为什么预警,最终导致系统被弃用。第五,没有样本回流机制,可疑用途的表达方式会随监管和对抗行为变化,模型很快过期。
复盘要点:可疑用途识别的核心不是“文本分类准确率”,而是“风险发现效率”与“调查可解释性”。在项目初期,宁可接受一定误报,也要保证高风险样本不被漏掉,并让每一条预警都有可追溯的理由。
本章作为课程导入,已经明确了学习目标、核心概念、整体框架与实战价值。接下来你将进入具体技术环节,从交易备注的数据特征与业务语义开始,逐步构建一套可落地、可解释、可持续迭代的可疑用途识别体系。