1. 课程导入
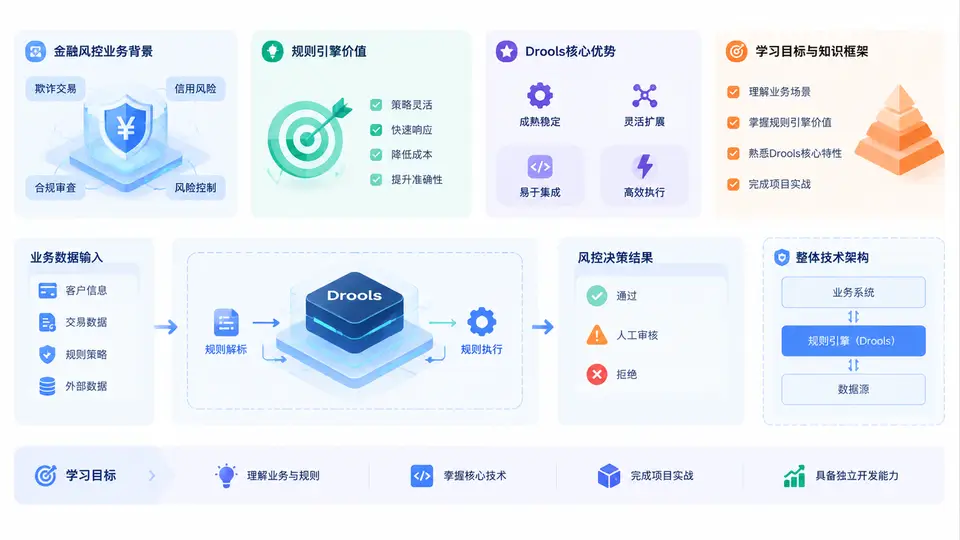
在金融业务中,风控不是某一个部门的“审核动作”,而是一套贯穿贷前、贷中、贷后的实时决策体系。无论是消费信贷、信用卡交易、供应链金融,还是反欺诈与反洗钱,系统都需要在毫秒级时间内回答三个问题:这笔业务能不能做、以什么条件做、后续如何持续监控。当业务规则从几十条增长到几千条,并且频繁调整时,硬编码的 if-else 会迅速成为交付瓶颈。规则引擎的价值,正是在业务变化与技术实现之间建立一层可管理、可验证、可热更新的决策基础设施。
一、金融风控业务背景:规则为什么必须“可运营”
典型信贷风控决策链路通常包含身份核验、反欺诈、信用评估、额度定价、放款拦截与贷后预警。每个环节都依赖大量规则:年龄与地域准入、多头借贷次数、征信逾期等级、设备指纹异常、交易频次与金额阈值、黑名单命中、关联关系图谱等。业务人员关心的是“规则是否有效、能否快速上线、能否解释拒绝原因”,而研发人员关心的是“规则如何与现有系统解耦、如何保证性能与一致性”。
如果规则全部写在 Java 代码中,会面临几个现实问题:
- 变更成本高:一条阈值调整需要改代码、走测试、重新发布,无法满足风控策略日级甚至小时级迭代。
- 可解释性弱:拒绝原因散落在多层调用中,难以向监管、客户或内部审计清晰说明。
- 复用性差:同一套“多头借贷”规则在贷前、贷中、贷后重复实现,口径容易不一致。
- 测试困难:规则与业务代码耦合,难以对单条规则做回归与仿真。
规则引擎将“条件—动作”从代码中抽离为可配置的规则资产,使业务专家能够参与规则维护,研发聚焦于事实模型、执行流程与系统集成。这不仅是技术选型,更是风控组织协作方式的升级。
二、规则引擎的核心原理与 Drools 的定位
规则引擎的基本工作模型可以概括为:事实(Fact)进入工作内存,规则(Rule)对事实进行模式匹配,匹配成功后触发动作(Action),动作可能修改事实并再次触发其他规则。这一过程由推理引擎驱动,而不是由开发者显式编写调用顺序。Drools 是 Java 生态中成熟的业务规则管理系统(BRMS)核心组件,采用 Rete 系列算法进行高效模式匹配,支持声明式规则、复杂事件处理与决策表。
与简单脚本或表达式引擎相比,Drools 的关键差异在于:
- 声明式与顺序解耦:规则只描述“什么条件下做什么”,执行顺序由引擎根据优先级、冲突策略和事实变化决定。
- Rete 网络与增量匹配:当事实变化时,只重新计算受影响的部分,适合高频、多规则的决策场景。
- 规则资产化:DRL、决策表、DSL 等格式可由业务人员维护,并纳入版本管理与审批流程。
- 可解释与可追溯:通过 Agenda、Working Memory 与日志,可以还原命中路径与拒绝原因。
核心理解:Drools 不是“更快的 if-else”,而是把规则从流程代码中剥离出来,形成可独立编辑、测试、部署和审计的决策层。它的性能优势来自 Rete 网络,但它的业务价值来自规则的可运营性。
三、方法流程:从业务规则到可执行决策
在金融风控场景中,引入 Drools 通常遵循以下流程:
- 事实建模:定义申请件、客户、设备、交易、征信报告等 Fact 对象,明确字段与类型。
- 规则梳理:将风控策略拆解为原子规则,标注优先级、生效范围、互斥关系与拒绝码。
- 规则编写:使用 DRL 或决策表实现条件与动作,必要时引入 DSL 降低业务人员编写门槛。
- 会话设计:选择无状态或有状态会话,确定事实插入、规则触发与结果回收方式。
- 测试与仿真:对单规则、规则集和全链路进行回归,使用历史样本验证通过率与坏账率变化。
- 部署与监控:将规则包纳入 CI/CD,监控命中率、执行耗时、异常规则与决策分布。
下面是一个最小化的 DRL 规则示例,用于说明“命中黑名单则拒绝”的声明式写法:
package com.risk.rules

import com.risk.model.Applicant;

rule "R001 黑名单直接拒绝"
    salience 100
    when
        $a : Applicant( blacklisted == true )
    then
        $a.setDecision("REJECT");
        $a.setReason("BLACKLIST_HIT");
        System.out.println("拒绝申请: " + $a.getApplyId());
end
这段规则没有显式调用顺序,也没有在 Java 中写 if。引擎会在事实插入后自动匹配,并根据 salience 决定优先级。对于风控系统而言,这种结构让“规则变更”从代码发布问题转化为规则包更新问题。
四、案例与场景:规则引擎在风控中的典型落点
以一笔线上消费贷款申请为例,系统在收到申请后插入 Applicant、DeviceInfo、CreditReport 等事实。规则可能依次完成:反欺诈规则识别设备异常,准入规则检查年龄与地域,信用规则计算风险等级,定价规则给出利率与额度,最终由决策汇总规则输出通过、拒绝或人工复核。整个过程在同一个会话中完成,规则之间通过事实状态间接协作。
| 风控环节 | 典型规则 | Drools 价值 |
|---|---|---|
| 反欺诈 | 设备指纹异常、IP 聚集、联系人黑名单 | 多规则并行匹配,快速拦截团伙欺诈 |
| 信用准入 | 年龄、地域、征信逾期、负债收入比 | 规则可配置,策略调整无需改代码 |
| 额度定价 | 风险等级映射利率、额度上限 | 决策表维护,业务人员可直接编辑 |
| 贷后预警 | 交易频次、还款行为、关联风险 | 有状态会话持续监控事实变化 |
五、常见误区与复盘
误区一:把所有逻辑都塞进规则。规则引擎适合决策逻辑,不适合复杂计算、远程调用和事务控制。把 HTTP 调用、数据库写入大量放入 RHS 会导致性能与一致性问题。
误区二:忽视事实模型设计。规则写得再优雅,如果 Fact 字段缺失或语义模糊,规则也无法正确执行。事实模型是规则引擎的地基。
误区三:没有优先级与冲突策略。多条规则同时命中时,若 salience 和 agenda-group 设计混乱,决策结果可能不可预测。
误区四:缺少回归与仿真。规则变更后只做单元测试不够,必须用历史样本验证通过率、拒绝率和风险指标是否发生非预期偏移。
复盘这些误区可以发现,Drools 项目的成败往往不在语法,而在规则治理:谁负责编写、谁负责审批、如何版本化、如何监控、如何回滚。技术团队需要把规则当作生产资产来管理,而不是当作配置文件随意修改。
六、课程学习目标与整体知识框架
本课程围绕“能落地、能调优、能治理”三个目标展开。学习完成后,你应当能够:
- 理解规则引擎与 Rete 算法的核心机制,能够解释规则匹配与冲突解决过程。
- 熟练编写 DRL、决策表与 DSL,并完成事实建模、会话管理与结果回收。
- 将 Drools 集成到 Spring Boot 风控服务中,实现规则热更新与性能监控。
- 针对金融风控场景设计规则集、优先级、拒绝码与可解释输出。
- 建立规则测试、仿真、版本管理与上线回滚的工程化流程。
整体知识框架分为四层:基础层覆盖 Drools 架构、Fact、Rule、Session 与 Rete;开发层覆盖 DRL 语法、决策表、DSL、全局变量与函数;集成层覆盖 Spring Boot、KIE 容器、规则包部署与动态加载;治理层覆盖测试仿真、性能调优、监控审计与风控策略运营。后续章节将沿着这四层逐步展开,并以一个完整的金融风控决策服务作为贯穿案例。
学习建议:每学完一个语法点,立即在风控场景中找一个对应规则进行实现;每完成一个模块,用历史样本做一次回归。规则引擎的掌握程度,最终体现在你能否把业务策略稳定、可解释地转化为可执行规则。