1. 课程导入
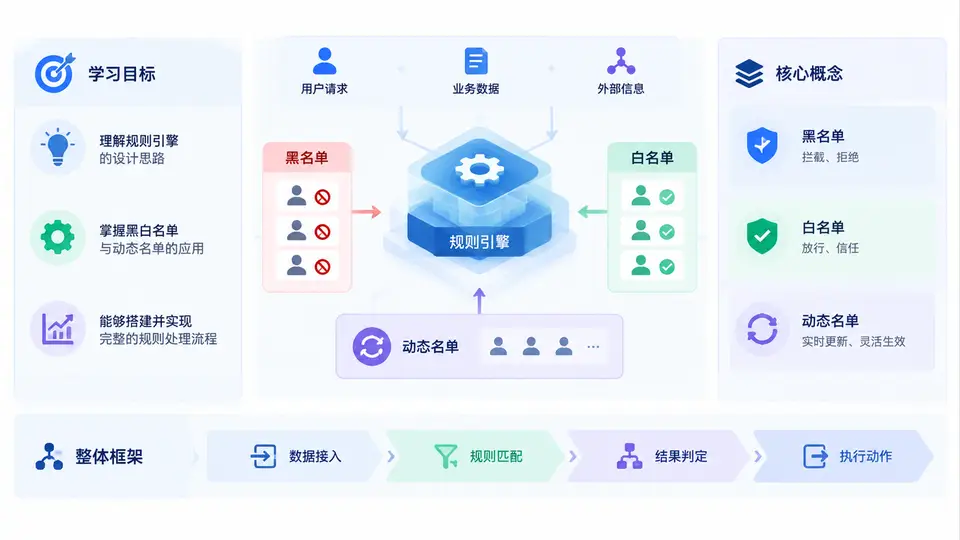
在风控、反欺诈、内容安全、账号治理、支付拦截等系统中,黑白名单往往是最早落地、也最容易被低估的一类能力。很多团队一开始只是用一张表加几个查询接口完成“命中即拦截”,但随着业务增长,名单来源变多、规则频繁调整、命中逻辑需要组合、灰度与回溯要求提高,简单查询就会迅速演变为难以维护的“规则泥潭”。本课程的目标,是带你从零散名单管理走向可配置、可解释、可扩展的动态名单规则引擎。
学习目标
完成本章后,你应当能够建立三个层面的认知:第一,理解黑白名单、灰名单、动态名单与规则引擎之间的边界和关系;第二,掌握名单规则引擎的核心组成,包括数据接入、规则建模、匹配执行、决策输出与治理闭环;第三,能够判断一个业务问题是否适合用名单规则引擎解决,以及初期应避免哪些过度设计。
- 能区分静态名单、动态名单、策略规则与模型评分在决策链路中的不同职责。
- 能描述一条名单规则从配置、发布、命中到审计的完整生命周期。
- 能识别常见误区,例如把名单当规则、把规则当模型、把缓存当数据源。
- 能画出最小可用的规则引擎处理流程,并为后续章节的实战打下结构基础。
核心概念:名单不是一张表,而是决策系统的一部分
黑名单通常表示明确拒绝或高风险对象,白名单表示可信或允许放行对象。灰名单则处于中间态,往往需要结合其他条件进一步判断。静态名单由人工维护或离线批量导入,变化频率低;动态名单则由实时行为、离线计算、外部情报或模型输出持续更新,具有时效性和衰减特征。
规则引擎并不是“更复杂的 if-else”,它强调将业务判断从代码中抽离为可配置、可版本化、可测试的规则资产。一个典型规则可以表达为:当对象命中黑名单且来源可信度大于阈值,并且发生在高风险场景时,输出拒绝;当对象命中白名单但行为异常时,输出二次验证而不是直接放行。这里的关键是:名单提供事实,规则提供判断,引擎负责执行与治理。
一句话理解:名单是“谁”,规则是“在什么条件下如何处理谁”,引擎是“稳定、可解释、可运营地完成这件事”。
整体框架:一条规则从进入到生效的旅程
为了避免一开始陷入实现细节,我们先建立整体框架。动态名单规则引擎通常包含五层:数据源层、名单管理层、规则建模层、执行决策层、治理运营层。数据源层接入人工名单、离线标签、实时事件、外部情报;名单管理层负责标准化、去重、过期、优先级和来源标记;规则建模层把业务语言转成可执行条件;执行决策层完成匹配、聚合、短路、打分和输出;治理运营层负责发布、灰度、监控、审计与回滚。
| 层级 | 核心职责 | 典型输入 | 典型输出 |
|---|---|---|---|
| 数据源层 | 接入与清洗名单数据 | 人工导入、离线表、实时事件、外部情报 | 标准化名单记录 |
| 名单管理层 | 去重、过期、优先级、来源标记 | 标准化名单记录 | 可查询名单视图 |
| 规则建模层 | 将业务策略表达为规则 | 业务策略、名单视图、上下文 | 可执行规则配置 |
| 执行决策层 | 匹配、聚合、短路、打分 | 请求上下文、规则配置 | 决策结果与命中解释 |
| 治理运营层 | 发布、灰度、监控、审计、回滚 | 决策日志、规则版本 | 可运营的规则资产 |
方法流程:最小可用规则引擎的处理链路
下面用一个简化流程说明一次请求如何被处理。假设我们要判断一个登录请求是否放行,系统需要先提取对象标识,例如用户ID、设备指纹、IP;然后并行查询黑白名单;接着执行规则匹配;最后输出决策并记录命中解释。
输入:login_request
  userId = "u_1024"
  deviceId = "d_9f3a"
  ip = "203.0.113.7"
  scene = "login"

步骤:
1. 标准化对象标识
2. 查询名单:
   - 黑名单:userId 未命中
   - 白名单:deviceId 命中,来源=人工,置信度=0.95
   - 灰名单:ip 命中,来源=情报,风险分=72
3. 执行规则:
   - 若白名单命中且置信度>=0.9,则基础决策=放行
   - 若灰名单命中且风险分>=70,则叠加二次验证
4. 输出:
   decision = "challenge"
   reason = "white_device_but_risky_ip"
这个例子说明,名单命中并不等于最终决策。白名单可以降低风险,但灰名单或实时上下文可能提升风险,最终输出需要规则引擎聚合判断。后续章节会逐步实现名单存储、规则 DSL、匹配算法、优先级、短路策略、灰度发布与审计。
案例/场景:为什么需要动态名单规则引擎
以电商促销风控为例。运营人员维护一批恶意退款用户黑名单,安全团队接入外部欺诈IP情报,算法团队输出高风险设备分,客服团队维护白名单商户。若没有规则引擎,这些逻辑会散落在多个服务中,导致三个问题:第一,策略变更需要发版;第二,命中原因无法统一解释;第三,名单过期和优先级冲突难以治理。
引入规则引擎后,可以将“恶意退款用户+高风险设备”组合为拒绝规则,将“白名单商户+异常IP”组合为二次验证规则,将“外部情报IP+低风险场景”组合为观察规则。这样,业务人员可以在控制台调整条件,研发人员关注执行性能与稳定性,运营人员查看命中率和误杀率。
实践提示:初期不要追求大而全的规则语言。先支持“与、或、非、比较、集合命中、优先级、过期时间”六类能力,通常就能覆盖大部分名单决策场景。
误区与复盘:新手最容易踩的五个坑
- 把名单当规则:名单只回答“是否在集合中”,规则还要回答“在什么场景、以什么优先级、输出什么动作”。
- 忽略来源与置信度:人工名单、情报名单、模型名单的可信度不同,不能简单合并为布尔值。
- 没有过期与衰减:动态名单如果永不过期,会不断累积误杀,最终导致业务不可用。
- 缺少命中解释:只返回拒绝,不返回命中了哪条规则、哪个名单、什么来源,排查成本极高。
- 过早引入复杂 DSL:规则语言越灵活,测试、审计和性能优化越难。应从最小可用集合开始演进。
复盘这些误区,可以发现一个共同点:把名单规则引擎当成纯技术组件,而忽略了它同时是业务策略资产。好的引擎不仅要跑得快,还要让策略可读、可改、可回滚、可追责。本章建立了整体框架,后续将从数据模型、名单存储、规则表达、匹配执行、性能优化、灰度发布和审计监控等角度逐步展开。
边界提醒:名单规则引擎适合处理明确、可解释、可配置的集合与条件判断;对于高度依赖特征组合和概率预测的问题,应将其作为模型评分链路中的一层,而不是替代模型。