3. 高频技术面试题
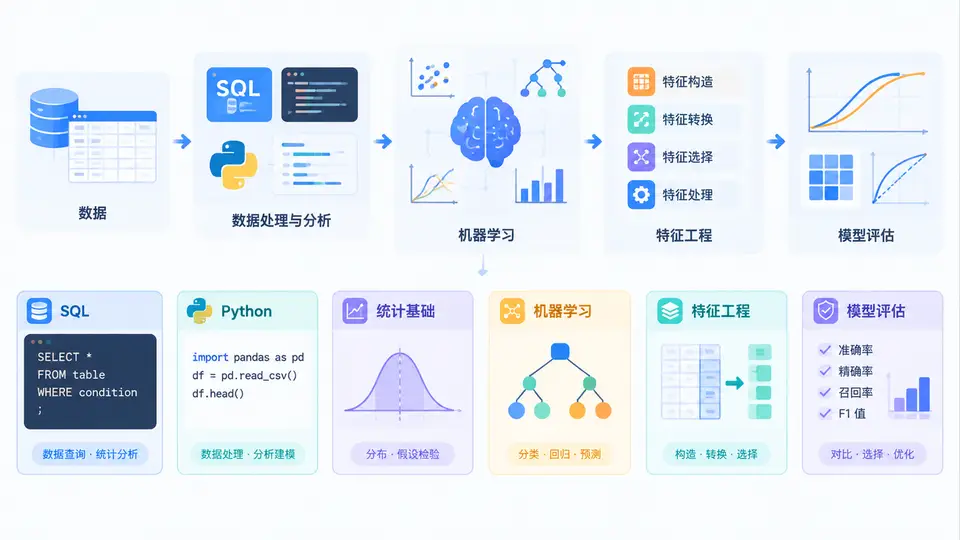
风控策略工程师的技术面,很少单纯考“你会不会写代码”,而是考“你能不能用技术手段把风险问题拆开、验证并落地”。SQL、Python、统计、机器学习、特征工程、模型评估这六块,通常不会孤立出现,而是围绕一个业务场景连环追问。例如面试官先问“怎么找出异常申请”,再追问“SQL 怎么写”“特征怎么构造”“模型怎么评估”“上线后怎么监控”。因此本章的核心不是背题,而是建立一条从业务问题到技术验证的回答主线。
一、核心原理:技术题背后考的是“风险决策链路”
面试官问 SQL,往往不是考语法,而是考你能否从海量行为数据中定义风险口径。比如“怎么识别团伙欺诈”,你需要先定义“同一设备、同一IP、同一联系人短时间多申请”的窗口逻辑,再写窗口函数。问 Python,考的是数据处理、特征计算和可复现性。问统计,考的是显著性、置信区间和抽样偏差。问机器学习,考的是模型选型与业务代价的平衡。问特征工程,考的是风险可解释性与时效性。问模型评估,考的是在样本不均衡下如何选阈值、看KS、AUC、PSI。
二、方法流程:六类高频题的标准拆解
SQL:重点掌握窗口函数、关联聚合、时间窗口、去重与留存。常见题如“计算每个用户申请前30天内的申请次数”。
SELECT user_id, apply_time,
       COUNT(*) OVER (
         PARTITION BY user_id
         ORDER BY apply_time
         RANGE BETWEEN INTERVAL '30' DAY PRECEDING AND CURRENT ROW
       ) AS apply_cnt_30d
FROM apply_log;Python:常考pandas分组、缺失值处理、特征交叉、模型训练流水线。要能说清为什么用fillna而不是dropna,为什么用时间切分而不是随机切分。
统计基础:假设检验、A/B实验、置信区间、样本量估算、辛普森悖论。风控中常用于策略灰度与效果验证。
机器学习:逻辑回归、树模型、XGBoost、LightGBM。要能解释为什么风控偏爱逻辑回归:可解释、稳定、易监控。树模型用于捕捉非线性,但需配合SHAP做解释。
特征工程:包括时间窗口特征、频次特征、金额统计、设备指纹、关系网络、Embedding。核心是“特征在预测时点可获取,且上线后能稳定计算”。
模型评估:不能只看准确率。样本不均衡时看AUC、KS、Recall、Precision、F1,业务上还要看通过率、坏账率、拦截率与人工复核成本。
| 技术模块 | 高频考点 | 风控落地关注点 |
|---|---|---|
| SQL | 窗口函数、时间窗口、去重 | 口径可复现、避免数据泄漏 |
| Python | pandas、特征计算、流水线 | 可复现、可调度、可监控 |
| 统计基础 | 假设检验、A/B、置信区间 | 策略灰度与显著性判断 |
| 机器学习 | LR、XGBoost、LightGBM | 可解释、稳定、低延迟 |
| 特征工程 | 频次、金额、设备、关系网络 | 时效性、覆盖率、稳定性 |
| 模型评估 | AUC、KS、PSI、阈值 | 业务代价与通过率平衡 |
三、案例/场景:从“异常申请”到“策略上线”
假设面试官问:“最近现金贷申请量上涨,但逾期率也上升,你怎么排查?”你可以这样组织:
- 先做数据分层:按渠道、地区、设备、申请时段拆解逾期率,定位是否集中在某类人群。
- 用SQL计算近7天、30天申请频次、设备关联账号数、联系人重复度等特征。
- 用Python做特征分布对比,发现异常群体在“夜间申请占比”和“设备关联数”上显著偏高。
- 用逻辑回归或LightGBM训练模型,时间切分验证,观察KS与AUC提升。
- 设定阈值后做灰度,监控通过率、逾期率、PSI与人工复核量,确认无显著负向再全量。
四、误区/复盘:技术面最容易踩的坑
- 只背概念不接业务:问KS只答公式,不说阈值怎么选、业务代价怎么算。
- 忽略样本不均衡:用准确率评估欺诈模型,导致模型全部预测为“正常”。
- 特征泄漏:用逾期后的还款行为预测逾期,离线AUC虚高,上线失效。
- SQL口径模糊:不定义时间窗口、不去重、不处理NULL,导致结果不可复现。
- 模型评估单一:只看AUC,不看KS、PSI、Recall与人工成本。
总结来说,这六类技术题不是六座孤岛,而是一条链:SQL取数定义口径,Python做特征与建模,统计验证显著性,机器学习产出分数,特征工程保证可上线,模型评估决定阈值与监控。面试时按这条链回答,既能展示技术深度,也能体现风控策略工程师最稀缺的能力——把技术变成可上线的风险决策。