3. 决策流核心概念
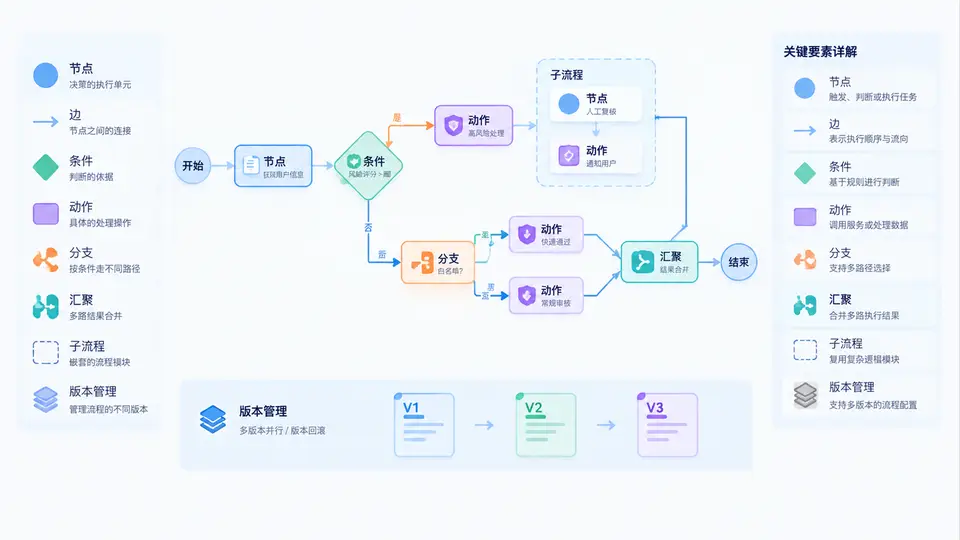
在风控系统中,决策流并不是一张“画着箭头的流程图”,而是一套可执行、可回放、可审计的编排模型。理解它的第一步,是把图中每一个元素都映射为运行时语义:谁在执行、依据什么执行、执行后去哪里、失败如何兜底、变更如何追溯。本节围绕八个核心概念展开,帮助你建立从“画图”到“跑流”的完整认知。
一、核心原理:决策流是一张有向图,但不止于图
决策流本质上是一个有向无环图(DAG)或允许有限循环的有向图。节点代表计算单元,边代表控制流或数据流,条件决定边的通断,动作是节点内的具体行为,分支与汇聚构成图的拓扑结构,子流程用于封装复用,版本管理保证变更可控。它们的关系可以概括为:
- 节点:最小执行单元,如规则集、模型评分、名单查询、脚本、人工审核。
- 边:节点之间的连接,携带条件表达式或默认优先级。
- 条件:布尔表达式,决定走哪条边,通常引用上下文变量。
- 动作:节点被触发后执行的操作,如赋值、拒绝、打标、调用外部服务。
- 分支:一个节点出边多于一条,形成路径选择。
- 汇聚:多条入边汇入同一节点,需定义合并策略。
- 子流程:可被多次调用的独立决策流,拥有自己的入参与出参。
- 版本管理:对决策流定义进行快照、发布、回滚与灰度。
关键认知:节点负责“算什么”,边负责“往哪走”,条件负责“凭什么走”,动作负责“走的时候做什么”。四者分离,才能让风控策略既灵活又可控。
二、方法流程:从建模到执行的六步法
要让决策流真正落地,建议遵循以下流程:
- 定义上下文:明确输入变量(如用户ID、设备指纹、申请金额)和输出变量(如决策结果、风险分、命中规则)。
- 划分节点:按职责拆分,避免一个节点做太多事。例如“查黑名单”和“算评分”应分开。
- 连接边与条件:为每条边设置条件表达式和优先级,确保互斥或可排序。
- 设置动作:节点执行后写入上下文,供后续节点和边使用。
- 处理分支与汇聚:分支要覆盖所有可能路径,汇聚要定义变量合并规则。
- 封装子流程与版本:将通用逻辑抽为子流程,发布时生成版本号并记录变更。
下面是一个简化的决策流配置片段,展示节点、边、条件与动作的声明方式:
{
  "flowId": "risk_loan_apply",
  "version": "v3.2.1",
  "nodes": [
    {
      "id": "n1",
      "type": "ruleSet",
      "name": "基础准入",
      "action": { "set": { "basePass": "true" } }
    },
    {
      "id": "n2",
      "type": "model",
      "name": "欺诈评分",
      "action": { "set": { "fraudScore": "$model.score" } }
    },
    {
      "id": "n3",
      "type": "decision",
      "name": "最终决策",
      "action": { "set": { "result": "REJECT" } }
    }
  ],
  "edges": [
    { "from": "n1", "to": "n2", "condition": "$basePass == true", "priority": 1 },
    { "from": "n1", "to": "n3", "condition": "$basePass == false", "priority": 2 },
    { "from": "n2", "to": "n3", "condition": "$fraudScore >= 0.8", "priority": 1 }
  ]
}
执行时,引擎从入口节点开始,按边优先级和条件求值,逐步推进,直到到达终止节点。每一步都应记录日志,便于回放与审计。
三、案例/场景:分支与汇聚在反欺诈中的应用
假设一个贷款申请场景:先做基础准入,再根据用户类型分流。新用户走“强校验”分支,老用户走“弱校验”分支,最后汇聚到“额度计算”节点。汇聚时,需要合并两条路径产生的变量,例如riskLevel和verifyScore。
| 概念 | 在本场景中的体现 | 注意事项 |
|---|---|---|
| 节点 | 基础准入、强校验、弱校验、额度计算 | 职责单一,便于复用 |
| 边 | 准入→强校验、准入→弱校验、强/弱→额度 | 条件互斥,避免歧义 |
| 条件 | $userType == "NEW" |
变量必须已定义 |
| 动作 | 设置riskLevel、调用外部接口 |
失败要有兜底 |
| 分支 | 新老用户分流 | 覆盖所有枚举值 |
| 汇聚 | 两条路径汇入额度计算 | 定义变量合并优先级 |
| 子流程 | “强校验”封装为可复用子流程 | 入参出参清晰 |
| 版本管理 | v3.2.1 发布,支持回滚 | 记录变更人与时间 |
实践建议:分支节点出边建议设置default边,防止条件未命中导致流程卡死。汇聚节点应明确变量合并策略,如“后到覆盖”或“取最大值”。
四、误区/复盘:常见坑与规避策略
在实际项目中,以下误区最容易导致决策流“看起来对,跑起来错”:
- 条件重叠:多条边条件同时为真,引擎按优先级选择,但业务上可能希望互斥。应通过条件设计或优先级显式控制。
- 汇聚丢变量:两条分支都设置了同名变量,汇聚后不确定用哪个。应在汇聚节点定义合并规则。
- 子流程副作用:子流程修改了全局上下文,导致调用方行为不可预期。应限制子流程只通过出参返回结果。
- 版本混乱:线上运行版本与测试版本不一致,回滚无依据。应强制版本号、变更日志和灰度发布。
- 循环无界:允许循环但未设最大次数,导致死循环。应设置循环上限和超时。
复盘要点:每次决策流变更后,必须用历史样本回放,对比新旧版本的决策差异。差异率超过阈值时,需人工确认后再全量发布。
掌握这八个概念,你就拥有了阅读和设计任何风控决策流的基础语言。下一步,我们将进入编排器的具体实现,看看这些概念如何被引擎解析和执行。