3. 数据预处理
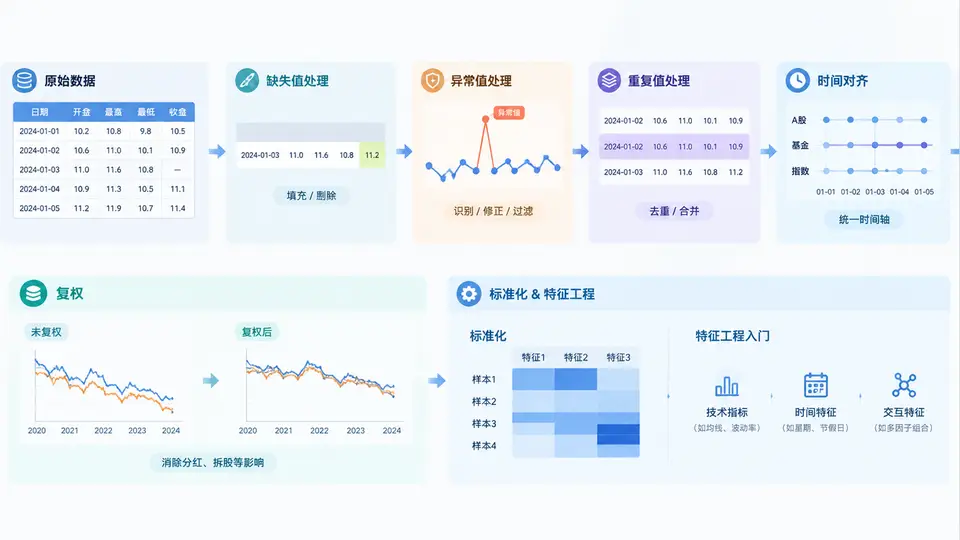
在历史数据回放与规则策略仿真中,数据预处理不是“清洗一下再用”的附属步骤,而是决定回测可信度的第一道关口。原始行情、财务、公告、宏观数据往往来自多个源,存在缺失、异常、重复、时区不一致、复权口径混乱等问题。若跳过预处理直接进入策略逻辑,回放结果可能因“未来函数”“幸存者偏差”或“价格断层”而严重失真。本节围绕六项核心任务展开:缺失值、异常值、重复值处理,时间对齐,复权,标准化与特征工程入门。
一、核心原理:预处理的目标是“让每一根K线可被信任”
回放仿真的本质是按时间顺序重演历史,策略在每一个时间切片上只能看到“当时已知”的信息。预处理的核心原理可归纳为三点:
- 一致性:同一标的、同一时间、同一字段在不同数据源中必须指向同一事实,否则策略信号会漂移。
- 完整性:缺失值不能简单删除,否则会破坏时间序列的连续性,导致回放时“跳帧”。
- 因果性:任何填充、平滑、标准化都只能使用当前及过去信息,禁止引入未来数据。
关键判断:预处理后的数据应满足“在t时刻,策略只能看到t时刻及之前的数据,且这些数据与实盘当时可获取的数据一致”。
二、方法流程:六步预处理流水线
建议将预处理组织为可复用的流水线,每一步输出中间快照,便于回放时审计。典型流程如下:
- 重复值处理:按“标的+时间戳”去重,保留最新或最可信来源。重复记录常来自多源合并或断线重连。
- 缺失值处理:区分“真缺失”与“停牌/非交易时段”。对价格类,优先前向填充;对成交量,停牌期填0;对财务类,按公告日对齐后填充。
- 异常值处理:用涨跌停、价格跳变、成交量突增等规则识别,结合中位数绝对偏差(MAD)或分位数截断。
- 时间对齐:统一时区与频率,将多源数据对齐到策略决策的时间网格上。
- 复权:消除分红、送转、配股造成的价格断层,保证收益率连续。
- 标准化与特征工程:生成量价、波动、动量等特征,并做滚动标准化,避免未来信息泄露。
| 任务 | 常用方法 | 回放风险 |
|---|---|---|
| 重复值 | 按标的+时间戳去重,保留最新 | 重复成交导致仓位翻倍 |
| 缺失值 | 前向填充、停牌填0、插值 | 跳帧或虚假信号 |
| 异常值 | MAD、分位数截断、涨跌停过滤 | 极端值扭曲均线与波动率 |
| 时间对齐 | 重采样、时区统一、asof合并 | 未来函数、错位成交 |
| 复权 | 前复权、后复权、比例因子 | 价格断层误判为趋势 |
| 标准化 | 滚动Z-score、滚动分位数 | 全样本标准化泄露未来 |
三、案例/场景:从原始CSV到可回放特征表
假设我们有一份日频行情CSV,字段为symbol, datetime, open, high, low, close, volume,存在重复行、停牌缺失和未复权价格。下面给出一个可运行的Python预处理片段,重点展示去重、缺失填充、异常截断、时间对齐与滚动标准化。
import pandas as pd
import numpy as np

# 1. 读取并统一时间
df = pd.read_csv("raw_quotes.csv", parse_dates=["datetime"])
df = df.sort_values(["symbol", "datetime"])

# 2. 重复值:按标的+时间戳去重,保留最后一条
df = df.drop_duplicates(subset=["symbol", "datetime"], keep="last")

# 3. 缺失值:价格前向填充,成交量停牌填0
price_cols = ["open", "high", "low", "close"]
df[price_cols] = df.groupby("symbol")[price_cols].ffill()
df["volume"] = df["volume"].fillna(0)

# 4. 异常值:用MAD截断收益率,再还原价格
df["ret"] = df.groupby("symbol")["close"].pct_change()
mad = df.groupby("symbol")["ret"].transform(lambda x: (x - x.median()).abs().median())
df["ret"] = df["ret"].clip(-5 * mad, 5 * mad)

# 5. 时间对齐:重采样到日频,确保每个交易日都有记录
df = df.set_index("datetime").groupby("symbol").resample("1D").last().reset_index()

# 6. 滚动标准化:只用过去252个交易日
df["zscore"] = df.groupby("symbol")["ret"].transform(
    lambda x: (x - x.rolling(252, min_periods=60).mean()) /
              x.rolling(252, min_periods=60).std()
)
print(df[["symbol", "datetime", "close", "zscore"]].tail())
提示:复权通常在缺失值处理之前完成,因为复权因子本身可能缺失。若使用后复权,历史价格会随最新分红调整,回放时需固定复权基准日,避免“未来复权因子”泄露。
四、误区/复盘:预处理中最容易犯的五个错误
- 全样本标准化:用整个历史区间计算均值和标准差,再回放到早期时段,等于提前知道了未来的波动水平。正确做法是滚动窗口或扩展窗口。
- 删除缺失行:直接
dropna()会删掉停牌日,导致时间序列不连续,回放时策略在停牌期“消失”,复牌后仓位错乱。 - 复权口径混用:前复权与后复权混用,或复权因子未按公告日生效,会造成价格断层被误判为趋势信号。
- 时间对齐用错方向:财务数据按报告期合并而非公告日合并,导致策略在公告前就“看到”业绩,形成未来函数。
- 异常值一刀切:把涨跌停、停牌复牌首日的大幅波动全部截断,可能抹掉真实的市场结构变化。
复盘建议:每次预处理后,抽取若干标的和关键日期,人工核对“当时可见数据”与“预处理后数据”是否一致。尤其检查停牌日、除权日、公告日前后三天的记录。
五、特征工程入门:从清洗后的数据到策略输入
预处理完成后,特征工程的目标是把原始字段转化为策略可解释、可比较的输入。入门阶段建议从三类特征开始:
- 量价特征:收益率、振幅、换手率、成交量比率。注意用滚动窗口计算,避免未来信息。
- 动量与波动特征:N日动量、滚动波动率、ATR。波动率可用于仓位管理。
- 时间特征:星期、月份、是否财报季。时间特征本身不泄露未来,但需与交易日历对齐。
特征生成后,务必做一次“时间穿越检查”:对每个特征,确认其在t时刻的取值只依赖t及之前的数据。常用方法是构造一个“延迟一期的特征”与原始特征对比,若两者完全一致,说明该特征没有使用未来信息;若差异过大,则需检查窗口设置。
本节目标:掌握六步预处理流水线,能够独立完成从原始CSV到可回放特征表的转换,并识别至少五种常见预处理误区。下一阶段将进入规则策略的仿真执行与绩效归因。