3. A/B测试入门
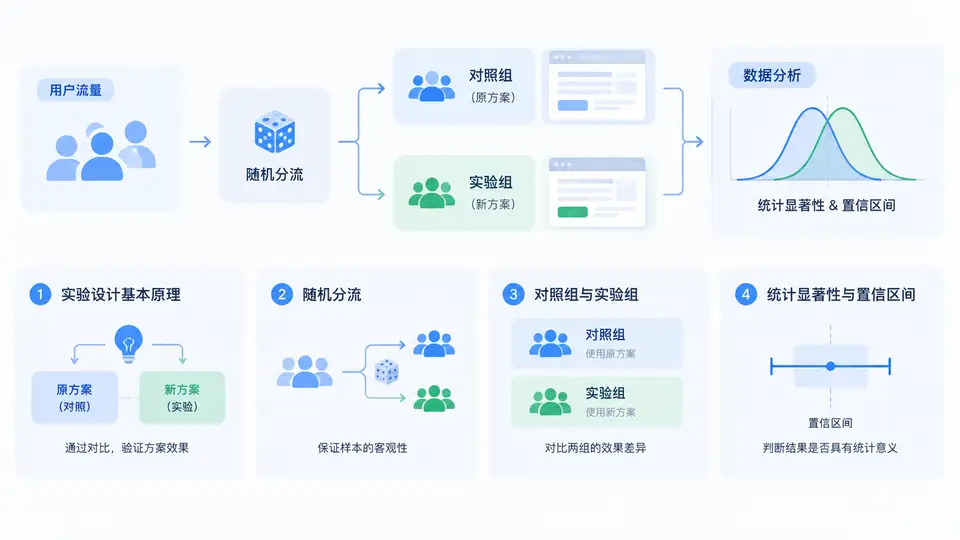
在支付风控场景中,任何策略调整都可能同时影响资损率和误杀率。A/B测试的价值在于:用可控实验把“策略是否真的更好”从经验判断变成可量化结论。它不是简单地把流量一分为二,而是一套从假设、分流、指标到统计推断的完整方法。
一、核心原理:A/B测试到底在比较什么
A/B测试的本质是随机对照实验。我们把同一批用户或交易请求,通过随机分流分成两组:一组走现有策略,称为对照组(A组);另一组走新策略,称为实验组(B组)。在其余条件尽量一致的前提下,比较两组核心指标差异,从而判断新策略是否带来真实提升。
支付风控中常见的实验假设包括:
- 新模型将误杀率从1.2%降到0.9%,同时资损率不上升;
- 新增设备指纹规则使盗刷拦截率提升5%,但人工审核量增加不超过3%;
- 调整阈值后,通过率提升2%,但欺诈投诉率保持稳定。
这里的关键是可比较性。如果实验组和对照组在用户结构、交易金额、渠道分布上存在系统性差异,那么指标差异可能来自分流偏差,而不是策略本身。因此,随机分流和同质性是实验设计的两块基石。
一句话理解:A/B测试不是“看哪个数字高”,而是“在随机分流和统计推断下,判断差异是否由策略引起,并评估这种差异是否稳定”。
二、方法流程:从实验设计到结论输出
一个可落地的支付风控A/B测试通常包含以下步骤:
- 明确实验目标与核心指标。例如主指标为误杀率,护栏指标为资损率、通过率、人工审核量。
- 提出假设与最小可检测效应。例如“新策略可将误杀率相对降低15%”,并确定需要多少样本量。
- 设计随机分流。按用户ID、设备ID或交易请求哈希分流,确保同一用户稳定进入同一组。
- 设置对照组与实验组。对照组保持原策略,实验组启用新策略,其他风控规则保持一致。
- 运行实验并采集数据。监控指标变化、样本比例、异常波动和埋点质量。
- 进行统计检验。计算p值、置信区间和效应量,判断差异是否显著。
- 决策与复盘。显著且业务可接受则全量;不显著或护栏指标恶化则回滚或迭代。
随机分流常用哈希方式实现,例如:
# 以用户ID为例进行稳定分流
import hashlib

def assign_group(user_id, salt="pay_risk_ab_2024"):
    key = f"{salt}:{user_id}".encode("utf-8")
    hash_val = int(hashlib.md5(key).hexdigest(), 16)
    bucket = hash_val % 100
    if bucket < 50:
        return "control"   # 对照组
    else:
        return "treatment" # 实验组

# 同一用户多次请求始终进入同一组
print(assign_group("user_10086"))
print(assign_group("user_10086"))
分流时要注意:同一用户必须稳定分组,否则用户在不同策略间跳变,会污染实验结论。对于支付风控,还建议按“用户+设备”维度分流,避免同一设备下多个账号跨组。
三、统计显著性与置信区间:如何判断“真的有效”
实验跑完后,我们会看到两组指标不同。但差异可能来自随机波动。统计显著性回答的是:如果两组其实没有差异,观察到当前差异或更大差异的概率有多大?这个概率就是p值。通常p值小于0.05,我们认为差异在统计上显著。
但p值不是全部。置信区间能给出效应量的范围,更利于业务决策。例如:
| 指标 | 对照组 | 实验组 | 绝对差异 | 95%置信区间 | 结论 |
|---|---|---|---|---|---|
| 误杀率 | 1.20% | 0.95% | -0.25% | [-0.38%, -0.12%] | 显著下降 |
| 资损率 | 0.08% | 0.09% | +0.01% | [-0.01%, +0.03%] | 不显著 |
| 通过率 | 92.5% | 93.1% | +0.6% | [+0.2%, +1.0%] | 显著上升 |
解读时要注意:置信区间不包含0,通常对应统计显著;区间越窄,估计越精确。如果误杀率下降的置信区间为[-0.38%, -0.12%],说明新策略大概率能降低误杀率,且最差也能降低0.12%。这比单看“下降了0.25%”更有决策价值。
业务提示:统计显著不等于业务显著。误杀率下降0.01%也可能显著,但若样本量极大,业务收益可能微不足道。因此要同时看统计显著性、效应量和业务成本。
四、案例与误区复盘:支付风控A/B测试常见坑
假设某支付团队上线新反欺诈模型,实验组误杀率从1.2%降到0.9%,p值0.03,看起来很好。但复盘发现:实验组中低风险商户占比更高,因为分流时按交易请求随机,导致同一商户的不同交易进入不同组,而低风险商户交易更集中。这就是分流单元选择错误导致的偏差。
常见误区还包括:
- 提前偷看结果:每天看p值,显著就停,导致假阳性率飙升。应预先设定实验周期和样本量。
- 忽略护栏指标:只看误杀率下降,忽略资损率上升,最终业务损失更大。
- 样本量不足:实验组只有几百笔交易,置信区间极宽,结论不可靠。
- 多重比较:同时看十几个指标,总有一个“显著”,需校正或聚焦主指标。
- 实验污染:同一用户跨组、规则缓存未刷新、埋点重复上报,都会破坏随机性。
复盘结论:支付风控A/B测试的第一原则是“先设计,后实验”。分流单元、样本量、主指标、护栏指标和停止规则必须在实验前确定。否则,实验越跑越久,结论越像“事后找理由”。
把A/B测试做扎实,后续的误杀率优化才有可靠依据。随机分流保证可比性,对照组与实验组提供因果对比,统计显著性与置信区间则帮助我们在不确定性中做出更稳健的决策。