1. 课程导入
1.1 什么是支付拒付(Chargeback)
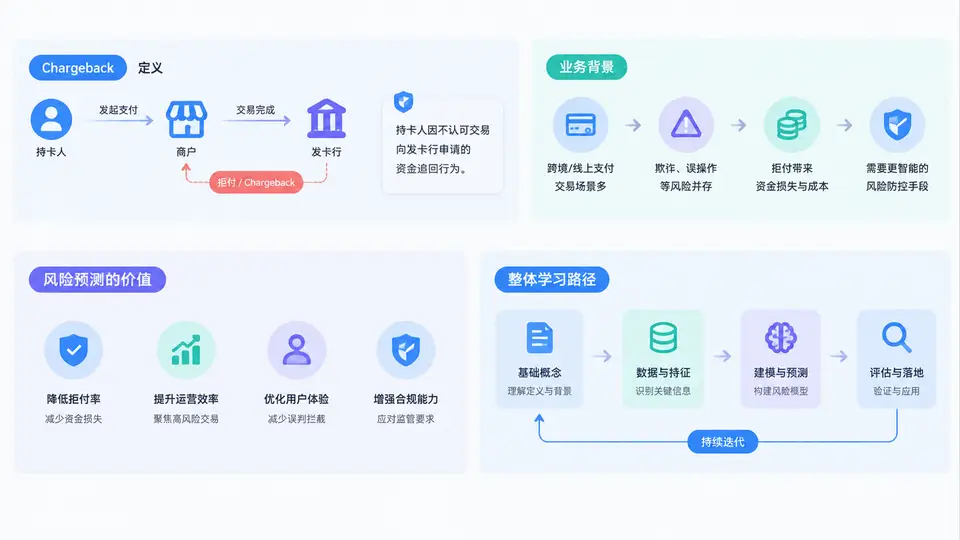
支付拒付(Chargeback)是指持卡人通过发卡行对一笔已完成交易提出争议,要求撤销付款并将资金退回的过程。它不同于退款(Refund):退款是商户主动发起的资金返还,而拒付是持卡人绕过商户、直接向银行体系发起的强制撤回。一旦拒付成立,商户不仅损失交易金额,通常还要承担固定拒付手续费,并可能面临收单机构的罚款与账户审查。
从资金流视角看,拒付是一条逆向链路:持卡人 → 发卡行 → 卡组织(如 Visa、Mastercard)→ 收单行 → 商户。每一层都有时限、举证要求和责任判定规则。理解这条链路,是后续做风险预测的基础。
1.2 业务背景:为什么拒付越来越关键
在跨境电商、订阅制服务、数字内容和虚拟商品等场景中,拒付率已成为比交易量更敏感的生存指标。原因有三:
- 卡组织监控阈值收紧:Visa 的 VDMP、Mastercard 的 ECP 等监控项目对商户拒付率设有明确红线,超标会进入高风险管理流程。
- 拒付成本远高于交易金额:一笔 100 美元的交易发生拒付,商户实际损失可能达到 115~130 美元,包含手续费、物流成本和罚款。
- 欺诈与友好欺诈并存:真实盗卡拒付与持卡人“收到货仍发起拒付”的友好欺诈(Friendly Fraud)混合出现,人工审核难以规模化。
因此,业务方需要的不只是“事后申诉”,而是“事前预测”——在交易授权或发货前判断该笔订单未来发生拒付的概率。
1.3 风险预测的价值:从被动申诉到主动拦截
拒付风险预测的本质,是把拒付从“事后成本”转化为“事前决策”。其价值体现在三个层面:
| 层面 | 传统做法 | 预测驱动做法 | 业务收益 |
|---|---|---|---|
| 交易决策 | 全部放行,事后申诉 | 高风险订单拦截或二次验证 | 降低拒付率与罚款 |
| 运营效率 | 人工抽检,覆盖率低 | 模型排序,优先审核高风险 | 审核人力下降 40%+ |
| 客户体验 | 误伤正常用户 | 分层策略,低风险免打扰 | 通过率与满意度提升 |
需要强调的是,预测模型的目标不是“零拒付”,而是在通过率、拒付率和运营成本之间找到可解释、可运营的平衡点。
1.4 核心原理:拒付风险预测在解决什么问题
从机器学习视角看,拒付风险预测是一个典型的二分类问题:给定一笔交易的特征向量,预测其未来是否会发生拒付。但它的特殊性在于:
- 标签延迟:拒付可能在交易后 30~120 天才发生,训练集存在标签滞后。
- 极端不平衡:拒付样本通常只占 0.1%~2%,准确率不是有效指标。
- 成本不对称:漏判一笔拒付的代价远高于误拦一笔正常交易。
- 特征时效:设备指纹、IP 信誉、历史拒付率等特征必须在毫秒级内可用。
因此,评估指标应优先选择 PR-AUC、Recall@K 和基于成本的期望损失,而不是简单的 Accuracy。
1.5 方法流程:一个可落地的预测闭环
完整的拒付风险预测不是单一模型,而是一个闭环系统。典型流程如下:
- 数据采集:交易、用户、设备、物流、历史拒付与申诉记录。
- 标签构建:定义观察窗口与表现窗口,处理标签延迟与样本权重。
- 特征工程:构造用户行为、交易上下文、时序聚合与图谱特征。
- 模型训练:采用 LightGBM、XGBoost 或逻辑回归基线,处理不平衡。
- 评估校准:使用 PR-AUC、KS、概率校准与成本曲线。
- 策略部署:输出风险分,映射到放行、验证、拦截三档策略。
- 监控迭代:跟踪拒付率、拦截率、模型漂移与申诉结果。
# 示例:拒付预测标签定义(伪代码)
observation_window = 7 days    # 交易后观察期
performance_window = 90 days   # 拒付表现期
label = 1 if chargeback_within(performance_window) else 0

# 样本权重:拒付样本加权,缓解不平衡
sample_weight = 1.0 if label == 0 else 20.0
1.6 案例场景:订阅制业务的拒付预测
某订阅制 SaaS 业务月交易 50 万笔,拒付率 1.2%,接近卡组织监控阈值。引入预测模型后,对风险分前 5% 的订单触发二次验证,对前 1% 直接拦截。运行三个月后:
- 拒付率从 1.2% 降至 0.6%;
- 整体通过率仅下降 0.8 个百分点;
- 人工审核量减少 35%,申诉成功率提升。
该案例说明:预测的价值不在于“抓出所有拒付”,而在于用可控的通过率代价换取显著的拒付下降。
1.7 常见误区与复盘
误区二:忽略标签延迟。用近期未发生拒付的交易作为负样本,会引入大量“尚未成熟”的假负例。
误区三:只做模型不做策略。没有阈值、分层和人工复核流程,模型分数无法落地。
误区四:忽视友好欺诈。只防盗卡,会漏掉占比更高的持卡人恶意拒付。
复盘建议:每个季度回看被拦截订单的最终结果,区分“正确拦截”“误拦”和“漏判”,并据此调整特征与阈值。
1.8 整体学习路径
本课程将围绕“数据—特征—模型—策略—监控”主线展开,共 30 章。你将依次掌握:拒付业务规则与卡组织监控、标签与样本构建、特征工程、不平衡学习、模型训练与校准、策略阈值与成本优化、上线部署与漂移监控,以及真实业务案例的完整复盘。第 1 章的目标是建立全局认知:拒付预测不是一次建模,而是一套可持续运营的风险决策系统。