3. 基于Pandas的欺诈数据质量探查
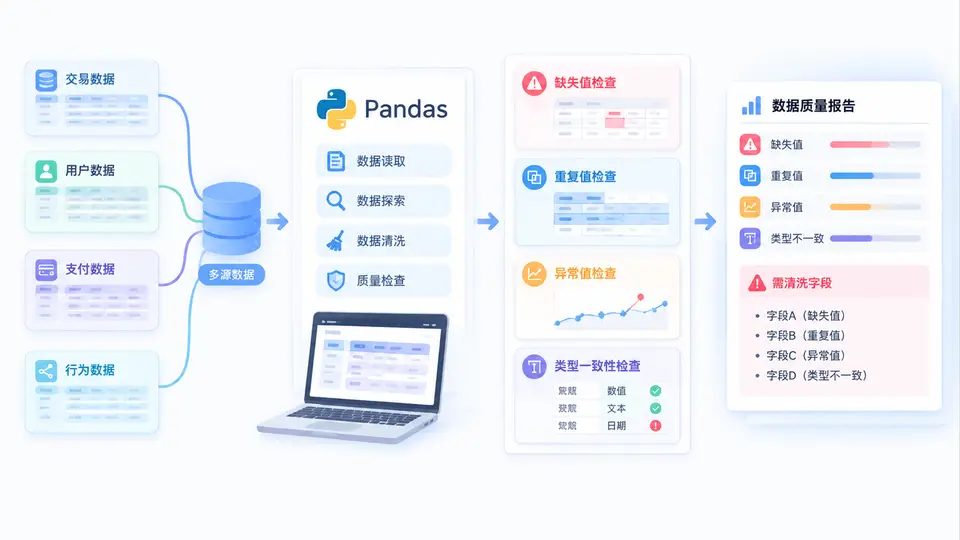
任务说明
本案例对多源欺诈数据(交易流水、用户信息、设备日志)做质量探查:统计缺失值、重复值、异常值、类型一致性,输出质量报告并标记需清洗字段。使用 Pandas 完成,无需外部文件,数据在代码内构造。
环境依赖
pip install pandas numpy完整实现
import pandas as pd
import numpy as np

# 构造多源欺诈数据(含缺失、重复、异常、类型不一致)
tx = pd.DataFrame({
    "tx_id":   [1001, 1002, 1003, 1004, 1004, 1006],
    "user_id": ["U01", "U02", "U03", None, "U04", "U05"],
    "amount":  [120.5, -30.0, 99999.0, 88.0, 88.0, np.nan],
    "ts":      ["2024-01-01", "2024-01-02", "bad_date", "2024-01-04", "2024-01-04", "2024-01-06"],
})
user = pd.DataFrame({
    "user_id": ["U01", "U02", "U03", "U04", "U05"],
    "age":     [25, 200, -5, 40, 33],          # 200、-5 为异常
    "city":    ["BJ", "SH", "GZ", "SZ", "BJ"],
})
device = pd.DataFrame({
    "user_id": ["U01", "U02", "U02", "U03", "U05"],
    "device":  ["ios", "android", "android", "web", "ios"],
})

sources = {"tx": tx, "user": user, "device": device}

# 各源字段类型期望
expected_types = {
    "tx":     {"tx_id": "int", "user_id": "str", "amount": "float", "ts": "datetime"},
    "user":   {"user_id": "str", "age": "int", "city": "str"},
    "device": {"user_id": "str", "device": "str"},
}

# 数值字段合理区间(用于异常值检测)
ranges = {"tx": {"amount": (0, 50000)}, "user": {"age": (0, 120)}}

def check_missing(df):
    return df.isna().sum().to_dict()

def check_duplicates(df):
    return int(df.duplicated().sum())

def check_outliers(df, spec):
    out = {}
    for col, (lo, hi) in spec.items():
        if col in df.columns:
            s = pd.to_numeric(df[col], errors="coerce")
            out[col] = int(((s < lo) | (s > hi)).sum())
    return out

def check_types(df, spec):
    bad = {}
    for col, want in spec.items():
        if col not in df.columns:
            bad[col] = "missing_column"
            continue
        s = df[col]
        if want == "int":
            ok = pd.api.types.is_integer_dtype(s)
        elif want == "float":
            ok = pd.api.types.is_numeric_dtype(s)
        elif want == "str":
            ok = pd.api.types.is_object_dtype(s) or pd.api.types.is_string_dtype(s)
        elif want == "datetime":
            ok = pd.api.types.is_datetime64_any_dtype(s)
        else:
            ok = True
        if not ok:
            bad[col] = f"expected {want}, got {s.dtype}"
    return bad

# 生成质量报告
report = {}
for name, df in sources.items():
    report[name] = {
        "rows": len(df),
        "missing": check_missing(df),
        "duplicates": check_duplicates(df),
        "outliers": check_outliers(df, ranges.get(name, {})),
        "type_issues": check_types(df, expected_types[name]),
    }

# 标记需清洗字段
need_clean = {}
for name, r in report.items():
    fields = set()
    fields |= {c for c, n in r["missing"].items() if n > 0}
    fields |= set(r["outliers"].keys()) if any(r["outliers"].values()) else set()
    fields |= set(r["type_issues"].keys())
    if r["duplicates"] > 0:
        fields.add("<duplicate_rows>")
    need_clean[name] = sorted(fields)

# 打印报告
for name, r in report.items():
    print(f"=== {name} ===")
    print(f"rows={r['rows']}  duplicates={r['duplicates']}")
    print(f"missing   : {r['missing']}")
    print(f"outliers  : {r['outliers']}")
    print(f"type_issues: {r['type_issues']}")
    print(f"need_clean : {need_clean[name]}")
    print()
运行方式
python quality_check.py验证方法与通过条件
- 运行后每个数据源打印一段报告,包含 rows、duplicates、missing、outliers、type_issues、need_clean 六项。
- tx 源应报告:user_id 缺失 1、amount 缺失 1、重复行 1、amount 异常 1(-30)、ts 类型问题 1(bad_date 非日期)。
- user 源应报告:age 异常 2(200、-5)。
- device 源应报告:重复行 1。
- need_clean 中应包含上述所有问题字段,重复行以
<duplicate_rows>标记。 - 若输出与上述一致,说明缺失、重复、异常、类型一致性四类检查均生效,报告与标记逻辑正确。
关键点说明
- 类型检查用
pd.api.types系列函数,避免直接比较 dtype 字符串带来的兼容问题。 - 异常值检测先
pd.to_numeric(errors="coerce"),把无法转数值的项视为 NaN 不参与区间判断,避免抛错。 - 需清洗字段由四类检查结果合并去重得到,重复行单独用占位标记,便于后续清洗流程识别。