3. 社区发现概述
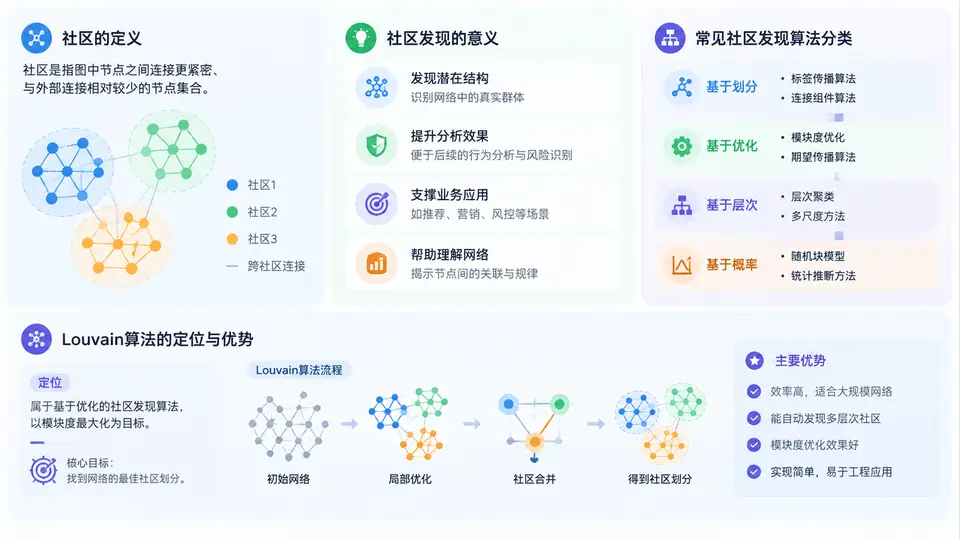
在欺诈团伙识别中,我们面对的不是孤立账户,而是一张由转账、登录、设备共用、IP 关联等行为构成的复杂网络。社区发现(Community Detection)要回答的核心问题是:在这张网络中,哪些节点彼此连接得更紧密,从而自然形成一个个“群体”?这些群体就是社区,在业务语境下,它们往往对应着可疑团伙、资金归集小组或黑产协作单元。
一、社区的定义:结构紧密 + 业务同质
从图论角度看,社区是网络中的一个节点子集,其内部连接密度显著高于该子集与外部节点之间的连接密度。形式化地说,若把网络划分为若干社区,理想状态下“社区内边数多、社区间边数少”。这一定义不依赖具体算法,而是描述了一种局部聚集现象。
在欺诈识别场景中,社区还有一层业务含义:同一社区内的账户往往共享相似的行为模式,例如共用设备、频繁小额互转、集中向同一收款账户归集资金。因此,社区不仅是拓扑结构,更是风险传播的载体。一个账户被判定为欺诈,其所在社区的其他成员风险评分也应相应提升。
关键理解:社区发现不是“把图切成若干块”这么简单,而是寻找网络中连接相对紧密、边界相对清晰的节点集合。社区之间允许存在少量边,这些边往往是跨团伙协作或资金外溢的线索。
二、社区发现的意义:为什么欺诈识别需要它
传统风控模型多基于单点特征,如账户年龄、交易金额、登录频率等。这类方法擅长识别“异常个体”,却难以捕捉“异常群体”。欺诈团伙的典型特征是分工协作:有人负责养号,有人负责收款,有人负责洗钱。单看每个账户可能都“正常”,但把它们放在关系网络中,团伙轮廓就会浮现。
社区发现的意义可以归纳为三点:
- 从个体到群体:将风险识别粒度从单账户扩展到团伙,提升召回率,减少“打单点、漏团伙”的情况。
- 风险传播与推理:社区内节点风险相互影响,已知黑样本可以通过社区结构向未知节点传播风险标签。
- 可解释性与调查效率:社区为调查人员提供清晰的团伙边界和成员列表,便于集中取证、批量处置,降低人工排查成本。
例如,某支付平台发现一批账户在深夜频繁互转,单账户金额都不大,但社区发现算法将这些账户聚成一个约 40 个节点的社区,进一步核查发现它们共用 3 台设备、2 个 IP 段,最终确认是一个刷单团伙。若仅靠单点规则,这些账户很可能被漏掉。
三、常见社区发现算法分类
社区发现算法种类繁多,按核心思想大致可分为以下几类。理解分类有助于我们在不同业务场景下选择合适的工具。
| 算法类别 | 代表算法 | 核心思想 | 适用场景 |
|---|---|---|---|
| 模块度优化 | Louvain、Leiden | 最大化模块度 Q,层次聚合 | 大规模网络、欺诈团伙识别 |
| 标签传播 | LPA | 节点标签随邻居传播 | 超大规模、快速近似 |
| 谱聚类 | Normalized Cut | 基于拉普拉斯矩阵特征向量切分 | 中小规模、结构清晰 |
| 层次聚类 | GN 算法 | 不断删除介数最高的边 | 小规模、需要层次结构 |
| 随机游走 | Walktrap、Infomap | 利用游走概率发现密集区域 | 有向图、信息流场景 |
其中,模块度优化类算法因兼顾效果与效率,在工业界应用最广。模块度 Q 衡量的是“社区内实际边数与随机情况下期望边数的差异”,Q 越大,社区结构越明显。Louvain 正是这一类算法的代表。
四、Louvain 算法的定位与优势
Louvain 算法由 Blondel 等人于 2008 年提出,是一种基于模块度优化的层次化社区发现算法。它的定位非常明确:在大型网络上快速、稳定地发现高质量社区。对于欺诈团伙识别这类动辄百万节点、千万边的场景,Louvain 几乎是首选基线。
其核心流程分为两个阶段,反复迭代:
- 局部优化:将每个节点初始化为独立社区,依次尝试将节点移动到邻居社区,使模块度增益最大;若无法增益则保持原社区。
- 社区聚合:将第一阶段形成的社区压缩为超级节点,构建新图,边权为社区间连接权重之和,然后重复第一阶段。
直到模块度不再提升,算法收敛。整个过程可以用如下伪代码概括:
输入:图 G = (V, E, w)
初始化:每个节点为一个社区
repeat:
    # 阶段一:局部移动
    for each node u in V:
        计算将 u 移入各邻居社区的模块度增益 ΔQ
        若 max(ΔQ) > 0:
            将 u 移入增益最大的社区
    # 阶段二:图聚合
    将当前社区压缩为超级节点,构建新图 G'
    G = G'
until 模块度不再提升
输出:最终社区划分
Louvain 的优势主要体现在:
- 效率高:时间复杂度近似 O(n log n),可处理亿级边的大图。
- 无需预设社区数量:算法自动确定社区个数,避免人工指定 K 值。
- 层次结构:输出多粒度社区,既能看到大团伙,也能下钻到小分组。
- 易于工程实现:支持加权图、有向图扩展,便于融合业务权重。
实战提示:在欺诈场景中,边权往往比边本身更重要。例如,转账金额、通话时长、共用设备次数都可以作为权重。Louvain 支持加权图,合理设计权重能显著提升团伙划分的业务准确性。
常见误区:模块度存在“分辨率极限”,当社区较小时可能被合并。若业务上需要发现小型高密度团伙,可考虑 Leiden 算法或对模块度进行分辨率参数调整。此外,Louvain 结果对节点遍历顺序有一定敏感性,多次运行取稳定划分是常见做法。
五、案例复盘:从交易网络到团伙清单
假设我们有一张某月交易网络,节点为账户,边为转账关系,边权为转账次数。使用 Louvain 后得到若干社区。我们重点关注其中两个:
- 社区 A:32 个节点,内部边密度 0.78,多数节点在凌晨 1-4 点互转,共用 2 个设备指纹。
- 社区 B:15 个节点,内部边密度 0.91,呈星型结构,中心节点向 14 个节点小额转入后集中转出。
进一步核查发现,社区 A 是刷单团伙,社区 B 是洗钱中转小组。若没有社区发现,这些账户分散在数百万节点中,很难被人工注意到。这个案例说明:社区发现的价值不在于替代风控规则,而在于为规则和模型提供“群体视角”的输入。
复盘时需要注意:社区发现结果必须结合业务特征二次验证。高密度社区不一定是欺诈团伙,也可能是正常商户与老客之间的高频交易。因此,实践中通常将社区特征(如内部边密度、平均交易金额、设备共用率)作为风控模型的输入特征,而非直接判定。
本节小结:社区是网络中内部连接紧密的节点集合;社区发现将风控视角从个体扩展到群体;常见算法分为模块度优化、标签传播、谱聚类等类别;Louvain 以高效、自动定社区数、支持加权图等优势,成为欺诈团伙识别的首选基线算法。理解其定位与边界,是后续实战调参与业务落地的前提。