1. 课程导入
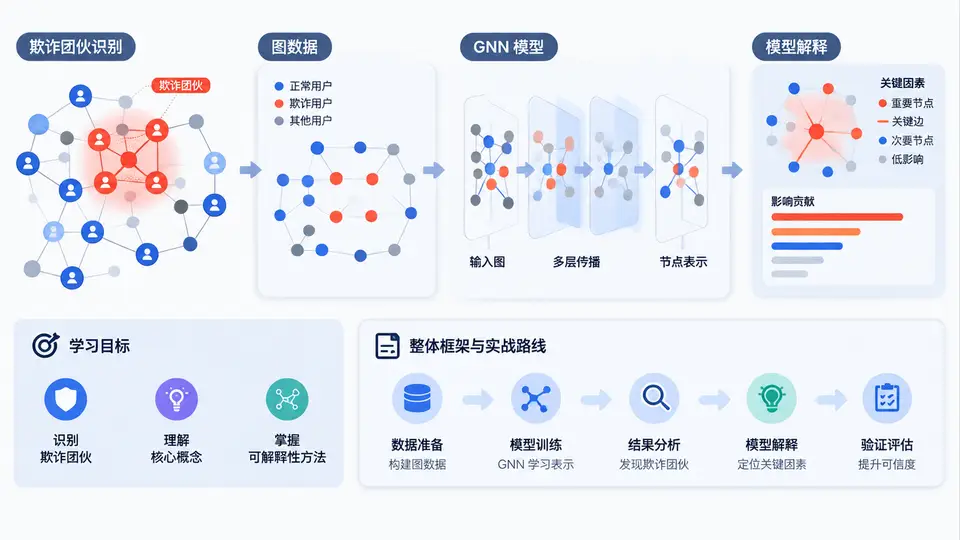
在真实风控与反欺诈业务中,单点欺诈账户往往只是冰山一角,真正造成规模化损失的,通常是彼此关联、分工协作的欺诈团伙。团伙成员会共享设备、IP、银行卡、手机号、收货地址,甚至形成多层级的资金转移链路。传统基于单条样本的评分模型,很难捕捉这种“关系型异常”。图神经网络(GNN)把账户、设备、交易等实体建成图,通过消息传递聚合邻居信息,天然适合识别团伙结构。但随之而来的问题是:模型给出高风险评分时,业务方和审核人员往往追问——为什么这个账户被判为团伙成员?哪些邻居、哪些边、哪些特征起了决定作用?这正是本课程要解决的核心矛盾:既要识别得准,又要解释得清。
一、学习目标:从“能跑通”到“能交付解释”
本课程不是单纯讲解 GNNExplainer 的论文公式,而是围绕欺诈团伙识别这一具体场景,构建可落地的解释能力。完成学习后,你应当能够达到以下目标:
- 理解层面:说清 GNN 在欺诈团伙识别中的建模逻辑,以及“可解释性”在风控合规、审核提效、模型迭代中的实际价值。
- 方法层面:掌握 GNNExplainer 的核心思想——通过优化边掩码和特征掩码,寻找对目标节点预测最重要的子图与特征子集。
- 工程层面:能够基于 PyTorch Geometric 构建图数据、训练 GNN 模型,并调用或复现 GNNExplainer 生成解释结果。
- 业务层面:能够把解释结果转化为审核人员可读的“团伙证据链”,例如关键关联边、关键邻居节点、关键特征。
- 评估层面:能够识别解释结果的常见误区,如解释不稳定、掩码稀疏性失控、把相关性误读为因果性。
二、核心概念:欺诈团伙、图建模与可解释性
要理解后续内容,先要统一几个关键概念。欺诈团伙在数据上表现为稠密子图或多跳关联簇:团伙内部连接紧密,团伙与正常用户之间连接稀疏。图建模时,通常把账户、设备、IP、银行卡等作为节点,把登录、转账、共享设备等行为作为边。节点特征可以包括注册时长、交易频次、历史投诉率等;边特征可以包括交易金额、时间间隔、设备指纹相似度等。
GNN 的核心机制是消息传递:每个节点聚合邻居的特征,更新自身表示。经过多层传播后,目标节点的表示中混入了多跳邻居的信息。对于欺诈团伙识别,这意味着模型能够“看到”目标账户周围的团伙结构。但这也带来黑盒问题:预测结果依赖于大量邻居和边,人类无法直接理解。
GNNExplainer 的切入点非常直观:既然预测依赖子图,那就学习一个掩码,把不重要的边和特征“遮住”,观察预测结果是否保持稳定。具体来说,它为目标节点优化两个掩码:边掩码 \(M_e\) 和特征掩码 \(M_f\)。优化目标是最大化预测标签的互信息,同时约束掩码尽量稀疏。最终保留下来的边和特征,就是模型认为最重要的解释子图。
| 概念 | 含义 | 在欺诈团伙场景中的对应 |
|---|---|---|
| 目标节点 | 需要解释预测结果的节点 | 被模型判为高风险的嫌疑账户 |
| 计算图 | 目标节点多跳邻居构成的子图 | 嫌疑账户周围的设备、IP、交易对手 |
| 边掩码 | 控制每条边是否保留的权重 | 哪些关联关系对团伙判定最关键 |
| 特征掩码 | 控制每个特征维度是否保留的权重 | 交易频次、投诉率等哪些特征最重要 |
| 解释子图 | 掩码筛选后保留的边与节点集合 | 可呈现给审核人员的团伙证据链 |
三、整体框架:从图构建到解释交付的完整链路
本课程的整体框架可以概括为“数据—模型—解释—业务”四层链路。第一层是图数据构建:从原始交易、登录、设备日志中抽取实体和关系,生成节点特征、边索引和标签。第二层是 GNN 模型训练:选择 GraphSAGE、GCN 或 GAT 等骨干网络,完成团伙识别任务,并保存训练好的模型与计算图。第三层是 GNNExplainer 解释:针对高风险节点,生成边掩码和特征掩码,提取解释子图。第四层是业务交付:把解释子图转化为可视化证据链、审核话术或规则沉淀。
为了让这条链路可运行,课程会使用统一的工程结构。下面是一个典型的配置示例,后续章节会在此基础上逐步扩展:
config = {
    "data": {
        "node_file": "nodes.csv",
        "edge_file": "edges.csv",
        "label_file": "labels.csv",
        "feature_dim": 32
    },
    "model": {
        "backbone": "GraphSAGE",
        "hidden_dim": 64,
        "num_layers": 2,
        "dropout": 0.3
    },
    "explainer": {
        "epochs": 200,
        "lr": 0.01,
        "edge_size": 0.05,
        "feature_size": 0.1
    }
}
其中 edge_size 和 feature_size 是解释器的关键参数,分别控制保留边和特征的比例。比例过大会导致解释子图过于稠密,失去可读性;比例过小则可能丢失关键证据。后续实战章节会通过实验对比不同参数下的解释效果。
四、实战路线:30 章如何一步步推进
整个课程按“由浅入深、由通用到场景”组织。前段解决图数据与模型基础,中段深入 GNNExplainer 原理与实现,后段聚焦欺诈团伙场景的解释交付与复盘。具体路线如下:
- 基础准备:图数据构建、PyTorch Geometric 环境、GNN 骨干网络训练。
- 解释入门:GNNExplainer 核心思想、掩码优化目标、解释结果读取。
- 实战调优:边掩码与特征掩码参数调节、解释稳定性分析、多节点批量解释。
- 团伙场景:团伙子图提取、关键边排序、证据链生成、审核界面集成。
- 评估复盘:解释指标、常见误区、失败案例分析与改进策略。
五、常见误区:先建立正确预期
在正式进入实战前,有必要先澄清几个高频误区。第一,解释不等于因果。GNNExplainer 找到的是模型预测所依赖的重要子图,而不是欺诈行为的真实因果链。第二,解释结果不稳定。由于掩码优化存在随机性,同一节点多次解释可能得到不同子图,需要通过多次采样和一致性分析来增强可信度。第三,解释子图不等于团伙全貌。它只反映模型视角下的关键证据,可能遗漏业务上重要但模型未利用的关系。第四,稀疏性不是越低越好。过度稀疏的解释可能丢失关键边,导致审核人员误判。
本章作为课程导入,已经明确了学习目标、核心概念、整体框架与实战路线。接下来,课程将进入图数据构建环节,从原始日志中抽取节点、边和特征,为后续 GNN 建模与解释打下数据基础。