3. 欺诈关系识别背景
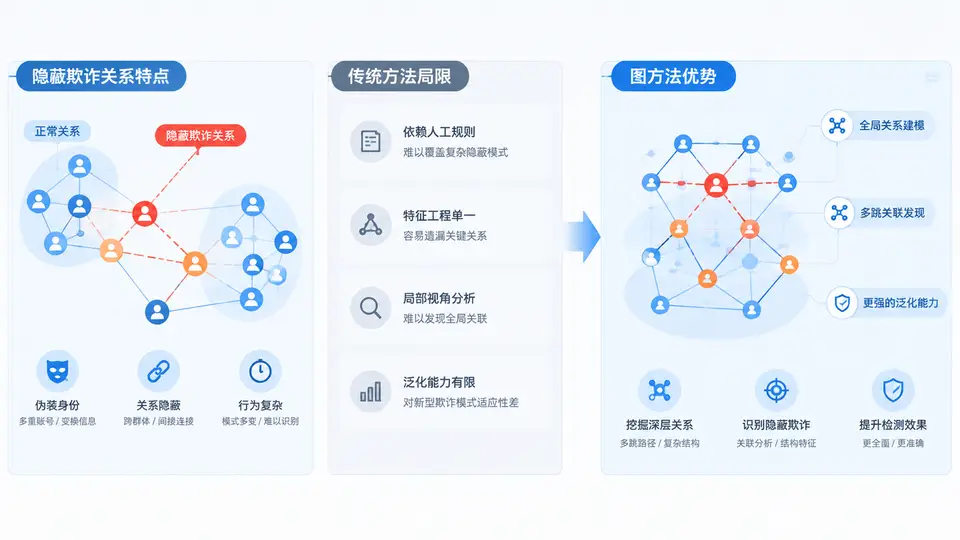
在进入链路预测建模之前,必须先回答一个更基础的问题:我们究竟要识别什么样的欺诈关系?如果对问题本身的形态认识不清,后续无论选择多复杂的模型,都容易陷入“指标好看、业务无效”的困境。欺诈关系识别与常规推荐、社交好友预测有本质差异,它的核心难点不在于“关系是否存在”,而在于“关系是否被刻意隐藏”。本节从隐蔽欺诈关系的形态特征出发,分析传统方法为何失效,并说明图方法为何天然适配这一问题。
一、核心原理:隐蔽欺诈关系到底“隐蔽”在哪里
欺诈关系通常指账户、设备、商户、银行卡、IP、代理节点等实体之间,为了实施套现、刷单、洗钱、薅羊毛、虚假交易等目的而建立的关联。与正常业务关系相比,它具有三个显著特征。
- 稀疏性:欺诈关系在整体关系总量中占比极低,往往低于千分之一甚至万分之一。正负样本极度不平衡,使模型容易偏向“全部预测为正常”。
- 伪装性:欺诈团伙会主动规避规则,例如分散转账金额、拉长交易时间间隔、使用多层代理、频繁更换设备指纹,使单条边看起来与正常边无异。
- 结构性:欺诈行为很少孤立发生。一个账户可能同时与多个可疑设备、多个收款方、多个IP产生关联,这些关联单独看都“正常”,但组合起来形成异常稠密的子图或异常路径。
这三点决定了欺诈关系识别不是简单的二分类问题,而是在极稀疏、强对抗、弱标签条件下,从图结构中挖掘异常连接模式的问题。换句话说,欺诈者可以伪装单条边,却很难同时伪装整个局部结构。
二、传统方法的局限:为什么规则和单点模型不够用
在引入图神经网络之前,工业界主要依赖三类方法:专家规则、传统机器学习评分、以及基于统计的关联分析。它们在早期有效,但面对有组织的隐蔽欺诈时逐渐暴露出系统性缺陷。
| 方法类型 | 典型做法 | 主要局限 |
|---|---|---|
| 专家规则 | 同设备多账号、短时间高频转账、黑名单命中 | 易被绕过,规则维护成本高,误伤正常用户 |
| 单点机器学习 | 对账户或交易提取特征后训练分类器 | 忽略实体间关联,无法捕捉团伙结构 |
| 统计关联分析 | 共同IP、共同设备、二度邻居计数 | 对多层跳转、稀疏连接不敏感,噪声大 |
更具体地说,传统方法存在三个难以逾越的瓶颈。第一,特征工程依赖人工经验,而欺诈模式变化快,人工规则永远滞后于对抗。第二,单点模型把每个样本独立看待,但欺诈团伙的关键证据往往在“关系”里,而不是在“节点”里。第三,统计关联无法区分强弱信号,共同IP可能只是同一写字楼,二度邻居可能只是正常社交,缺乏可学习的权重分配机制。
三、图方法优势:把“关系”作为一等公民
图方法的核心思想,是将账户、设备、IP、商户等实体建模为节点,将交易、登录、绑定等行为建模为边,从而在一个统一的异构图中同时表达属性和结构。链路预测任务则进一步聚焦:给定部分已知的欺诈边,预测图中尚未观察到或尚未确认的可疑连接。
相比传统方法,图方法有三个不可替代的优势。
- 结构感知:GNN通过消息传递聚合邻居信息,使节点表示天然包含局部子图模式。欺诈团伙即使单点伪装,其邻居组合仍会形成异常表示。
- 多跳传播:欺诈关系常通过多层中介隐藏,例如A→B→C→D。图模型可以通过多层聚合捕捉这种远距离依赖,而规则方法通常只能覆盖一到两跳。
- 端到端学习:无需手工设计所有关联规则,模型可以从标注数据中自动学习哪些连接模式更可疑,并随着新数据持续更新。
下面的伪代码展示了链路预测在图上的基本训练流程,帮助理解图方法如何把关系识别转化为可学习任务。
输入:异构图 G = (V, E),已知欺诈边集合 E_fraud,负采样边集合 E_neg
输出:链路预测模型 f,用于对候选边打分

1. 构建节点特征矩阵 X,边类型集合 R
2. 对每个节点进行多层邻居聚合:
   h_v^(k) = AGGREGATE({ h_u^(k-1) : u ∈ N(v) })
3. 对候选边 (u, v) 计算得分:
   score(u, v) = MLP( CONCAT(h_u, h_v, h_u * h_v) )
4. 使用带权重的交叉熵损失训练:
   L = -Σ [ y * log(score) + (1-y) * log(1-score) ]
5. 输出候选边分数,按阈值或Top-K生成可疑关系列表
需要注意的是,图方法并非万能。它依赖足够的图规模和可用的标签边,同时对异构图中的边类型设计、负采样策略和时序切分非常敏感。如果负采样过于简单,模型会学到“明显不相关”的捷径;如果忽略时间信息,模型可能用未来边预测过去边,造成数据泄漏。
四、案例与复盘:从“单点封禁”到“关系挖掘”
假设某支付平台发现一批账户存在套现嫌疑。传统做法是对每个账户计算风险分,超过阈值即封禁。但欺诈团伙将资金分散到50个账户,每个账户单日交易额都不高,单点模型全部判为正常。引入图方法后,将这50个账户、关联设备、收款方和IP构建成图,链路预测模型发现它们通过少数几个中介账户形成紧密子图,且与已知欺诈账户存在多跳路径。最终模型输出一批高可疑边,人工复核确认其中大部分属于同一团伙。
这个案例的复盘结论是:欺诈识别的关键不是把每个点看得更清楚,而是把点与点之间的关系看得更清楚。传统方法在单点维度上已经接近极限,而图方法打开了结构维度。后续章节将围绕如何构建这样的图、如何设计链路预测模型、以及如何评估隐蔽关系识别效果逐步展开。