1. 课程导入
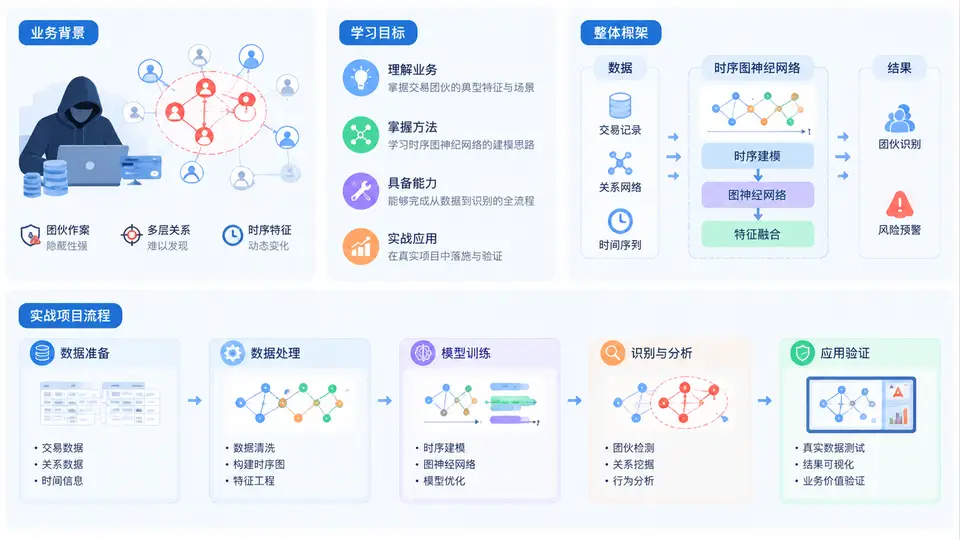
一、业务背景:为什么交易团伙识别越来越重要
在支付、电商、银行、证券、虚拟货币等场景中,欺诈行为早已从“单点作案”演变为“团伙协作”。典型团伙会批量注册账号、共享设备与IP、交叉转账、集中提现,并通过多层账户拆分资金链路,规避传统规则引擎的阈值检测。单笔交易看似正常,但把时间维度拉开、把账户关系连起来看,异常模式就会浮现。
传统风控依赖专家规则与静态画像,例如“单日转账超过N笔”“同一设备登录超过M个账号”。这些方法可解释性强,但存在三个明显短板:其一,团伙会快速调整策略,规则滞后;其二,规则难以刻画账户之间随时间演化的交互关系;其三,误杀率与漏杀率难以同时控制。于是,业界开始引入图神经网络(GNN),把账户、设备、商户、IP等实体作为节点,把交易、登录、绑定等行为作为边,在图上做团伙发现。
然而,静态图忽略了交易的时间顺序。团伙的形成、资金归集、拆分转移都带有明显的时间节奏。时序图神经网络(Temporal Graph Neural Network,TGNN)同时建模“结构关系”和“时间演化”,更贴近真实交易网络。本课程要解决的,正是如何把TGNN落到交易团伙识别的工程实战中。
二、学习目标:学完你能做到什么
本课程不是纯理论讲解,而是以“可运行、可评估、可复盘”为标准设计。完成学习后,你应当具备以下能力:
- 理解交易团伙识别的业务逻辑,能够把风控问题转化为图学习问题;
- 掌握时序图数据的构建方法,包括节点、边、时间戳、特征与标签设计;
- 能够实现并训练主流TGNN模型,如TGN、TGAT、EvolveGCN等思路;
- 能够设计团伙识别任务:节点分类、链路预测、社区发现与异常检测;
- 能够使用AUC、AP、Recall@K、团伙纯度等指标评估模型;
- 能够完成从数据预处理、模型训练、离线评估到在线推理的完整链路;
- 能够识别常见误区,如时间泄漏、标签泄漏、负采样偏差与评估口径不一致。
三、课程整体框架:30章如何组织
课程按“业务—数据—模型—实战—复盘”的主线推进,共30章。前段建立认知与数据基础,中段深入模型与训练技巧,后段完成端到端项目并做工程优化。
| 阶段 | 章节范围 | 核心内容 | 产出 |
|---|---|---|---|
| 导入与业务 | 第1–4章 | 业务背景、团伙模式、风控指标、问题定义 | 问题说明书与指标口径 |
| 数据与图构建 | 第5–10章 | 交易数据清洗、实体对齐、时序图构建、特征工程 | 可训练的时序图数据集 |
| 模型与训练 | 第11–20章 | GNN基础、TGAT、TGN、EvolveGCN、负采样与损失设计 | 基线模型与训练脚本 |
| 实战项目 | 第21–27章 | 团伙识别、社区发现、可解释性、离线评估与调优 | 团伙识别系统原型 |
| 工程与复盘 | 第28–30章 | 在线推理、性能优化、误区复盘与方案总结 | 可落地的工程方案 |
四、实战项目介绍:一个可复现的交易团伙识别系统
课程贯穿一个实战项目:基于某支付平台的脱敏交易流水,构建时序交易图,识别其中的欺诈团伙。数据包含账户、设备、IP、商户四类节点,以及转账、登录、绑定三类边。每条边带有时间戳与金额、频次等属性。标签为账户是否属于已确认团伙。
项目流程如下:
- 数据清洗与实体对齐:统一账户ID、设备指纹与IP映射,处理缺失与重复;
- 时序图构建:按时间窗口切分,生成带时间戳的边表与节点特征表;
- 特征工程:统计窗口内交易频次、金额均值、对手方数量、设备共享度等;
- 模型训练:以TGAT/TGN为基线,加入时间编码与邻居采样;
- 团伙识别:对节点嵌入聚类,结合连通分量与风险评分输出团伙;
- 评估与调优:使用AUC、AP、Recall@K与团伙纯度,分析误报漏报;
- 推理与部署:导出模型,模拟在线增量更新与批量打分。
# 示例:时序图边表结构
# src_account, dst_account, timestamp, amount, edge_type
A1001, A2003, 2024-03-01 10:12:00, 5800.00, transfer
A1001, A2003, 2024-03-01 10:15:30, 1200.00, transfer
A2003, A3007, 2024-03-01 11:02:10, 6900.00, transfer
A3007, D001,  2024-03-01 11:20:45, 0.00,    login
五、核心原理速览:时序图神经网络在做什么
时序图神经网络的核心思想是:节点表示不是固定不变的,而是随时间与邻居交互不断更新。以TGN为例,每个节点维护一个记忆向量,当新边到来时,通过消息函数计算消息,再用记忆更新函数刷新节点记忆。这样,模型既能记住历史行为,又能对近期交互更敏感。
与静态GNN相比,TGNN多了三个关键设计:时间编码、邻居采样与记忆机制。时间编码把时间差映射为向量,让模型感知“多久之前发生”;邻居采样控制计算量,避免全图聚合;记忆机制则让节点状态跨时间步传递。三者结合,才能在千万级交易边上做到可扩展。
六、常见误区与复盘:新手最容易踩的坑
- 误区二:标签泄漏。把团伙ID或人工规则结果作为特征输入,模型学到的是“答案”而非模式。
- 误区三:负采样偏差。只采样简单负例,导致模型无法区分难负例,线上误报高。
- 误区四:评估口径不一致。离线用AUC,线上用召回率,两者不可直接比较。
- 误区五:忽视业务成本。误杀一个正常商户的代价可能远高于漏杀一个小团伙,需引入代价敏感评估。
复盘方法:每次实验记录数据版本、时间切分、负采样策略、模型参数与评估指标。只有可复现,才能定位问题是出在数据、模型还是评估。
七、本章小结与行动清单
本章建立了交易团伙识别的业务认知,明确了学习目标与课程框架,并介绍了贯穿全课的实战项目。接下来,你需要完成三件事:第一,理解团伙识别与单点欺诈的区别;第二,确认本地环境与数据准备;第三,带着“时间+结构”的双重视角进入后续章节。
行动清单:
1. 安装 Python 3.9+、PyTorch、PyG、pandas、numpy
2. 准备一份脱敏交易流水样例数据
3. 画出你理解的“账户-设备-IP-商户”关系草图
4. 记录你当前业务中的团伙识别指标口径
当你完成以上准备,就已经具备进入第2章业务场景拆解的基础。后续每一章都会围绕实战项目逐步叠加能力,最终形成一个可运行、可评估、可解释的交易团伙识别系统。