3. 图数据建模与Schema设计面试题
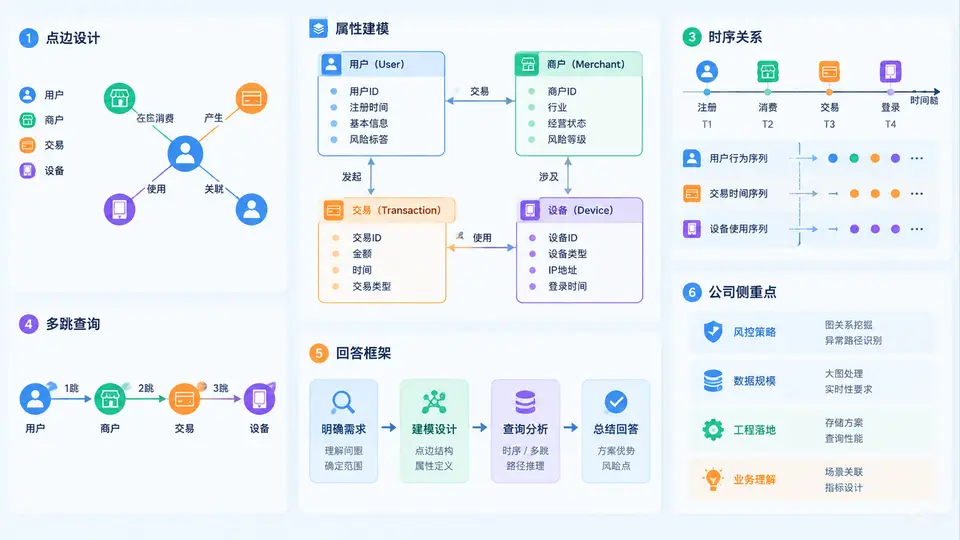
反欺诈图谱工程师的面试中,图数据建模与Schema设计是区分“会用图数据库”和“能设计反欺诈图谱”的关键分水岭。面试官通常不会直接问“什么是点边”,而是给出一个业务场景,观察你能否把欺诈风险抽象成可查询、可演化、可治理的图结构。本章围绕点边设计、属性建模、时序关系、多跳查询四条主线,给出回答框架与公司侧重点。
一、核心原理:反欺诈图谱的Schema不是“画关系图”
很多候选人把Schema设计理解为“把用户、设备、银行卡画成点,把登录、转账画成边”。这在面试中只能拿到及格分。反欺诈图谱的Schema设计本质是风险假设的可计算化:每一个点边类型都应对应一类可验证的欺诈模式,每一个属性都应服务于风险评分或调查取证。
点边设计要回答三个问题:谁是风险主体(用户、设备、商户、IP、银行卡、手机号)、什么行为构成关系(登录、注册、转账、收货、改绑)、关系是否有时序和方向。属性建模则要区分静态属性(注册地、设备型号)、动态属性(近7天登录次数、历史最大转账额)和派生属性(社区标签、风险分)。时序关系是反欺诈图谱区别于普通知识图谱的核心:同一对点之间可能有多条边,必须用时间戳、版本号或快照机制区分“何时发生”。
面试加分点:主动提出“Schema设计要预留反事实查询能力”,例如“如果这个设备在案发前30天被其他高风险账号使用过,能否快速查出”。这体现你理解图谱最终服务于调查和策略迭代,而不是静态存储。
二、方法流程:从业务问题到可落地Schema
建议按以下五步回答,面试官会认为你有工程化思维:
- 风险场景拆解:先问清是信贷反欺诈、交易反欺诈还是营销反作弊。不同场景的点边优先级不同。
- 定义点边类型:用“主体—行为—客体”三元组列出核心关系,例如“用户—使用—设备”“用户—转账—银行卡”。
- 属性分层:点属性放主体画像,边属性放行为上下文(金额、IP、时间、渠道),派生属性放风险标签。
- 时序建模:为边增加
event_time、ingest_time、version,必要时按天分区或使用时间窗索引。 - 多跳查询验证:用2跳、3跳查询验证Schema能否支撑团伙发现、资金链路追踪和设备关联。
// 以Neo4j为例的Schema约束与索引设计
CREATE CONSTRAINT user_id IF NOT EXISTS FOR (u:User) REQUIRE u.userId IS UNIQUE;
CREATE CONSTRAINT device_id IF NOT EXISTS FOR (d:Device) REQUIRE d.deviceId IS UNIQUE;
CREATE INDEX event_time_index IF NOT EXISTS FOR ()-[r:TRANSFER]-() ON (r.eventTime);
CREATE INDEX risk_score_index IF NOT EXISTS FOR (u:User) ON (u.riskScore);

// 多跳查询示例:查找与高风险用户共享设备且3跳内有过转账的账号
MATCH (u:User {riskLevel:'high'})-[:USED_DEVICE]->(d:Device)<-[:USED_DEVICE]-(other:User)
MATCH path=(other)-[:TRANSFER*1..3]->(target:User)
WHERE all(r IN relationships(path) WHERE r.eventTime > datetime().epochMillis - 2592000000)
RETURN other.userId, target.userId, length(path) AS hops
LIMIT 50;
三、案例/场景:团伙欺诈Schema设计实战
假设面试官给出场景:“某信贷平台发现一批新注册用户逾期率异常,怀疑是中介包装团伙。”你可以这样设计Schema:
| 类型 | 名称 | 关键属性 | 风险用途 |
|---|---|---|---|
| 点 | User | userId、注册时间、风险分、职业 | 风险主体 |
| 点 | Device | deviceId、型号、首次出现时间 | 设备关联 |
| 点 | BankCard | cardNo哈希、开户行、绑定时间 | 资金归集 |
| 边 | USED_DEVICE | 首次使用时间、使用次数、IP | 设备共用发现 |
| 边 | TRANSFER | 金额、时间、渠道、对手方 | 资金链路 |
| 边 | EMERGENCY_CONTACT | 关系类型、填写时间 | 团伙关联 |
在此基础上,你可以指出:设备共用是团伙发现的高价值边,但必须结合时间窗过滤,否则会把家庭共用设备误判为团伙。紧急联系人边看似弱,但在多头借贷和中介包装中常形成密集子图。面试官如果追问“如何区分正常家庭共用和欺诈团伙”,你可以回答:引入设备—用户—银行卡三角闭合度、注册时间聚集度、以及资金是否在短时间内向同一账户归集。
表达技巧:回答时用“我会先定义……再验证……最后预留……”的句式,把Schema设计讲成一个可迭代过程,而不是一次性画图。面试官更看重你能否在信息不全时做出合理假设并说明验证方式。
四、误区/复盘:Schema设计常见失分点
- 点边粒度太粗:把“登录”和“转账”都做成同一种边,导致多跳查询无法区分行为语义。
- 忽略时序:同一对用户之间多次转账只保留一条边,丢失时间序列,无法做“案发前30天”类查询。
- 属性堆砌:把所有字段塞进点属性,导致热点写放大,查询时反而需要全表扫描。
- 没有索引意识:面试中不提索引和约束,会被认为缺乏生产落地经验。
- 多跳查询不设边界:直接写
*1..10,没有时间窗和方向限制,生产环境容易拖垮集群。
复盘建议:面试后立刻用“点边类型—属性—时序—查询—治理”五栏表格复盘自己的回答。如果某一栏空白,说明该维度准备不足。下次练习时,强制自己在每个Schema设计题中至少说出一个索引优化点和一个多跳查询边界条件。
公司侧重点方面,电商与支付类公司更关注设备指纹、资金链路和实时多跳;信贷类公司更关注多头借贷、紧急联系人网络和时序快照;社交与内容平台则更关注账号关联、行为序列和社区发现。回答时若能主动对齐目标公司的业务场景,会显著提升匹配度。