3. 实时决策系统架构
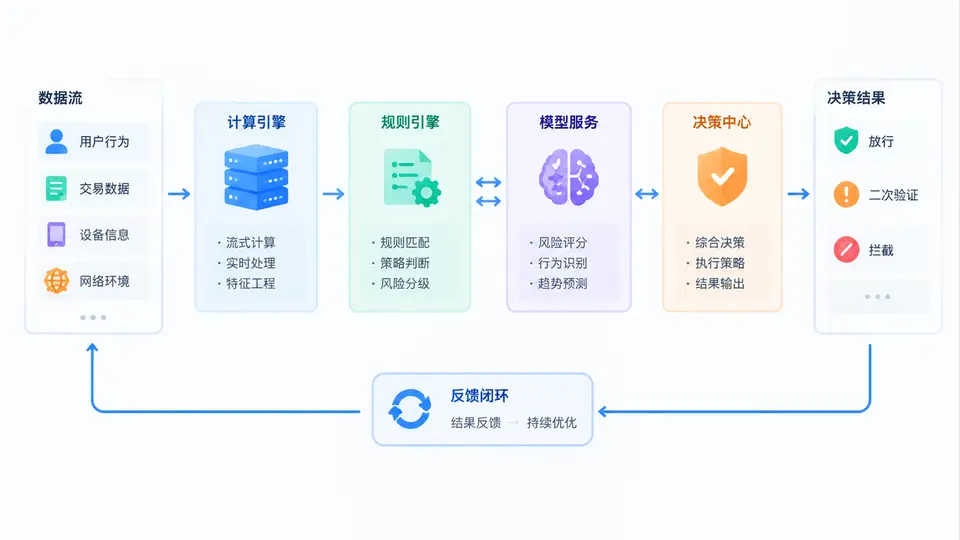
实时反欺诈决策系统不是单一模型或单一规则库,而是一条从事件产生到决策执行、再到结果回流的完整链路。理解这条链路的关键,是把它拆成六个相互协作的层次:数据流负责把原始行为变成可计算的事件与特征;计算引擎负责在毫秒级完成窗口聚合与特征拼接;规则引擎负责承载专家经验与硬性约束;模型服务负责输出风险概率与可解释分数;决策中心负责融合多路信号并给出最终动作;反馈闭环负责把处置结果转化为新的样本与策略迭代。六者缺一不可,任何一层断裂都会导致“离线很准、线上失效”。
核心原理:分层解耦与异步协同
实时决策的第一原则是分层解耦。数据流、计算、规则、模型、决策各自独立部署、独立扩缩容,通过标准消息协议通信。这样做的原因是:规则变更频率高但逻辑轻,模型更新频率低但计算重,若混在一个进程里,任何一方抖动都会拖垮整条链路。第二原则是异步协同:事件进入后先落消息队列,计算引擎并行消费,规则与模型服务可同时被调用,决策中心等待所有必需信号后做超时兜底。第三原则是可回放:每个决策必须记录输入特征、规则命中、模型分数与最终动作,否则无法复盘。
方法流程:从事件到动作的六步链路
- 事件接入:客户端或网关产生登录、下单、支付、改绑等事件,携带设备指纹、IP、账号、时间戳,写入 Kafka 等消息队列。
- 流式计算:Flink/Spark Streaming 消费事件,按用户、设备、IP 等维度做滑动窗口聚合,生成“近5分钟同设备登录次数”“近1小时同IP下单金额”等特征。
- 特征拼接:将实时窗口特征与 Redis/Feature Store 中的离线画像特征拼接成完整特征向量,写入特征缓存。
- 规则引擎:执行黑白名单、频次阈值、地理围栏、名单碰撞等硬规则,输出命中标签与风险等级。
- 模型服务:调用在线模型(如 GBDT、深度网络或集成模型),输出风险概率与 Top 贡献特征。
- 决策中心:按策略融合规则与模型结果,输出通过、挑战、人工审核、拒绝等动作,并写入决策日志。
下面是一个简化的决策中心伪代码,展示规则与模型的融合逻辑:
def decide(event, rule_result, model_score):
    # 硬规则优先,直接拒绝
    if rule_result.hit_blacklist:
        return Action.REJECT, "blacklist"
    # 高置信模型拒绝
    if model_score >= 0.95:
        return Action.REJECT, "model_high"
    # 规则与模型冲突时进入人工审核
    if rule_result.risk_level == "high" and model_score < 0.5:
        return Action.REVIEW, "conflict"
    # 中等风险挑战验证
    if model_score >= 0.7 or rule_result.hit_frequency:
        return Action.CHALLENGE, "step_up_auth"
    return Action.PASS, "normal"
案例/场景:支付盗刷的实时拦截
某支付平台在凌晨 2 点收到一笔 8000 元订单。事件进入后,流式计算在 30ms 内发现:该设备近 10 分钟登录了 5 个不同账号,该 IP 近 1 小时关联了 12 张银行卡。规则引擎命中“同设备多账号登录”与“同 IP 多卡关联”两条高频规则,风险等级置为高。模型服务同时返回 0.91 的盗刷概率,Top 特征为“设备异常度”和“交易时间偏离度”。决策中心综合后输出“拒绝并冻结”,同时触发反馈闭环:将该设备、IP、账号写入临时黑名单,并将样本回流至训练集。整个过程 P99 耗时 142ms,用户侧无感知。
这个案例说明:规则负责“已知的坏”,模型负责“未知的坏”,决策中心负责“冲突时的取舍”,反馈闭环负责“让下一次更准”。
关键组件对比与清单
| 组件 | 核心职责 | 典型技术 | 延迟目标 | 常见故障 |
|---|---|---|---|---|
| 数据流 | 事件采集与传输 | Kafka、Pulsar | ≤20ms | 消息积压、乱序 |
| 计算引擎 | 窗口聚合与特征计算 | Flink、Spark Streaming | ≤50ms | 状态膨胀、反压 |
| 规则引擎 | 硬规则与名单碰撞 | Drools、自研 DSL | ≤10ms | 规则冲突、热更新失败 |
| 模型服务 | 风险概率与解释 | TensorFlow Serving、Triton | ≤80ms | 版本错配、特征漂移 |
| 决策中心 | 融合与动作输出 | 自研策略引擎 | ≤10ms | 超时无兜底、日志缺失 |
| 反馈闭环 | 样本回流与迭代 | 数据湖、特征平台 | 小时级 | 标签延迟、样本偏差 |
误区与复盘
复盘时建议按“输入—计算—规则—模型—决策—反馈”六段逐段检查:输入是否完整、计算是否准确、规则是否冲突、模型是否漂移、决策是否可解释、反馈是否及时。只有每一段都可观测、可回放、可迭代,实时反欺诈系统才能真正稳定运行。