3. 机器学习基础与反欺诈场景结合
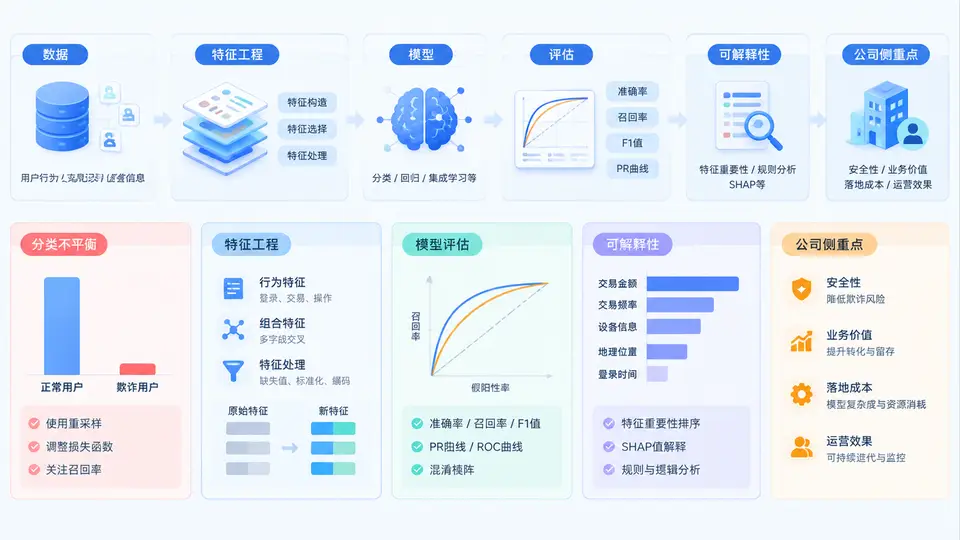
反欺诈算法工程师的面试,很少单独考“什么是AUC”或“怎么处理不平衡”。面试官更常见的问法是:“我们线上欺诈样本只有千分之三,你从建模到上线会怎么做?”这一章的核心,就是把机器学习基础能力放进反欺诈业务语境中考察。你需要同时证明三件事:懂原理、懂场景、懂取舍。
本章回答主线:先判断业务目标与代价,再处理不平衡与特征,接着选择评估口径,最后用可解释性打通风控、运营与合规的协作链路。任何一步脱离反欺诈场景,都会被追问到细节。
一、核心原理:不平衡不是“调参问题”,而是“代价问题”
反欺诈场景中,正样本极少,且正负样本的错分代价高度不对称。漏放一个欺诈用户,可能带来直接资金损失和后续团伙扩散;误杀一个正常用户,则影响转化、客诉和用户体验。因此,面试中不要一上来就说“用SMOTE过采样”,而要先问清楚:当前业务更怕漏放还是更怕误杀?
常见处理手段分为数据层、算法层和决策层。数据层包括欠采样、过采样、SMOTE及其变体;算法层包括类别权重、Focal Loss、代价敏感学习;决策层则是调整阈值、分群策略和人工审核兜底。真正成熟的回答会强调:采样比例不是越平衡越好,验证集必须保持真实分布,否则评估会严重失真。
加分表达:“我会把不平衡处理拆成训练分布和评估分布两件事。训练时可以重采样或加权,但验证和测试必须回到真实先验,否则AUC看起来漂亮,上线阈值却完全不可用。”
二、方法流程:从特征到上线的反欺诈建模链路
反欺诈特征工程通常围绕用户、设备、行为、关系和时间五个维度展开。用户维度包括注册时长、历史订单、实名状态;设备维度包括设备指纹、IP、模拟器识别;行为维度包括点击频率、页面停留、操作序列;关系维度包括同设备多账号、同IP多账号、社交图谱;时间维度包括深夜活跃、短时间高频申请等。
需要特别警惕特征穿越。例如用“未来7天是否被投诉”构造特征,离线AUC会虚高,上线后直接失效。正确做法是明确每个特征在预测时刻是否可得,并用时间切分做离线验证。
# 反欺诈特征可用性检查示例
feature_available_time = {
    "device_age_days": "申请时刻可得",
    "ip_risk_score": "申请时刻可得",
    "order_cnt_7d": "申请时刻前7天可得",
    "complaint_7d": "申请后7天,禁止用于实时模型"
}

# 时间切分,避免随机切分导致穿越
train = df[df["apply_date"] < "2024-01-01"]
valid = df[(df["apply_date"] >= "2024-01-01") & (df["apply_date"] < "2024-02-01")]
test  = df[df["apply_date"] >= "2024-02-01"]
模型选择上,逻辑回归可解释性强,适合规则融合和监管沟通;树模型如XGBoost、LightGBM在表格特征上表现稳定;图神经网络适合团伙挖掘;序列模型适合行为序列异常检测。面试中要能说明为什么选它,而不是只报模型名。
三、模型评估:AUC不够,要看业务口径
反欺诈评估至少要看四层:排序能力、阈值效果、业务收益和稳定性。AUC衡量排序,KS衡量区分度,PR-AUC在极不平衡时更敏感。上线时更关注命中率、召回率、误杀率、人工审核量、资损下降幅度和通过率变化。
| 评估维度 | 常用指标 | 反欺诈关注点 |
|---|---|---|
| 排序能力 | AUC、GAUC、PR-AUC | 极不平衡下PR-AUC更能反映正样本识别 |
| 阈值效果 | Recall、Precision、F1 | 结合误杀成本和漏放成本选阈值 |
| 业务收益 | 资损下降、通过率、审核量 | 模型必须能换算成钱和人力 |
| 稳定性 | PSI、特征漂移、分数分布 | 欺诈手法变化快,监控比离线分数更重要 |
常见误区:只报AUC 0.95,却说不清阈值怎么定、误杀多少、审核人力增加多少。面试官会立刻判断你缺少上线经验。
四、可解释性与公司侧重点
可解释性在反欺诈中不是锦上添花,而是协作刚需。风控运营需要知道为什么拦截,客服需要向用户解释,合规需要留痕,算法需要排查bad case。常用方法包括LR系数、树模型feature importance、SHAP值、规则命中路径和反事实解释。
不同公司侧重点不同。支付公司更关注实时性、资损和规则可解释;电商公司更关注刷单、薅羊毛和账号安全;信贷公司更关注信用风险与欺诈风险叠加;社交平台更关注团伙、机器注册和内容欺诈。面试时要根据公司业务调整回答重心。
案例表达:“我曾遇到一个模型离线AUC很高,但上线后误杀率飙升。复盘发现训练集用了未来投诉标签,且验证集做了随机切分。后来改为时间切分、去掉穿越特征,并用SHAP定位到几个不稳定特征,最终在召回不降的前提下把误杀率压回业务可接受范围。”
总结来说,这一章的面试回答要形成闭环:业务代价决定采样与阈值,时间切分保证特征不穿越,PR-AUC和业务指标共同评估,SHAP和规则路径支撑可解释性,最后根据公司业务类型调整表达重点。能把这条链路讲清楚,你就已经超过大多数只背概念的候选人。