1. 课程导入
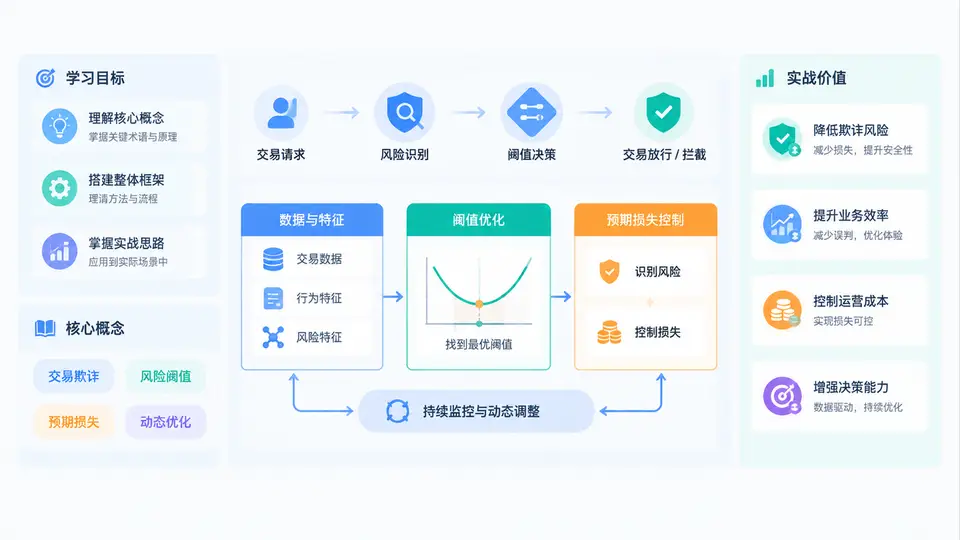
在支付、电商、信贷与数字钱包等业务中,交易欺诈识别系统每天要做出海量“放行或拦截”的决策。绝大多数风控引擎并不会直接输出“欺诈/非欺诈”,而是先给出一个连续的风险评分,再由一个或多个阈值把评分切分成不同处置动作:通过、二次验证、人工审核、直接拒绝。阈值看似只是一个数字,但它同时决定了三件事:放过多少欺诈、误伤多少正常用户、以及为兜底风险要准备多少成本。本课程的核心,就是把“调阈值”从经验拍脑袋,升级为可量化、可优化、可解释的工程方法。
一、学习目标:从会看报表到会做决策
完成本课程后,你应当能够独立完成一条完整的阈值优化闭环,而不仅是理解概念。具体目标包括:
- 能够用混淆矩阵、欺诈损失、误杀成本与人工审核成本,构建可计算的预期损失函数;
- 能够针对单一阈值、双阈值(灰名单区间)和多动作分级场景,选择并实现合适的优化方法;
- 能够基于历史样本、时间窗口与业务约束,评估阈值在未来的稳定性,避免“离线最优、上线即崩”;
- 能够把优化结果翻译成业务语言,向运营、产品与合规解释“为什么这个阈值更划算”;
- 能够识别并规避阈值优化中的典型误区,如标签延迟、样本漂移、成本口径不一致与过拟合。
二、核心概念:阈值不是分类线,而是成本杠杆
先统一几个贯穿全课程的概念。风险评分是模型对交易欺诈概率或风险强度的连续输出,通常记为 score。决策阈值是把评分映射为动作的边界值。若只有一个阈值 t,则 score ≥ t 时拦截,score < t 时放行。预期损失是在给定阈值下,所有可能结果按概率加权的平均成本,通常由四部分组成:欺诈损失、误杀损失、审核成本与拒付/客诉等衍生成本。
一个常见的预期损失表达式可以写成:
ExpectedLoss(t) =
    FN(t) * AvgFraudLoss          // 漏放欺诈的损失
  + FP(t) * AvgFalsePositiveCost  // 误杀正常交易的成本
  + (FN(t)+FP(t)) * ReviewCost    // 进入人工审核的边际成本
  + FixedCost                     // 系统与运营固定成本
其中 FN 为漏报数,FP 为误报数。这个式子看起来简单,但它揭示了阈值优化的本质:不是追求准确率最高,而是追求总成本最低。当欺诈损失远高于误杀成本时,最优阈值会偏低,系统更倾向拦截;当误杀会带来严重客户流失时,最优阈值会偏高,系统更倾向放行。阈值因此是一个业务成本结构的直接映射。
关键认知:阈值优化不是模型调参的附属动作,而是风控策略的核心决策。同一个模型,换一个阈值,可能从“高召回低精度”变成“高精度低召回”,其商业价值差异巨大。
三、整体框架:从数据到决策的六步闭环
本课程将围绕一个可复用的六步框架展开,后续章节会逐步深入每个环节。
- 定义成本口径:明确欺诈损失、误杀成本、审核成本与拒付成本的统计范围与货币单位,避免不同团队各算各的账。
- 准备评估样本:选取有代表性、标签可靠、时间窗口合理的历史交易样本,并区分训练集、验证集与时间外测试集。
- 计算阈值曲线:对每个候选阈值,计算混淆矩阵、欺诈拦截率、误杀率与预期损失,形成可比较的曲线。
- 求解最优阈值:在业务约束下寻找预期损失最小点,或使用带约束的优化方法处理多动作分级场景。
- 稳定性与压力测试:检查阈值在不同时间段、不同客群、不同欺诈模式下的表现,评估漂移风险。
- 上线与监控:灰度发布、A/B 测试、实时监控拦截率与误杀率,并建立阈值回滚与再优化机制。
这六步不是一次性项目,而是一个持续循环。欺诈模式会变,用户行为会变,成本结构也会变,因此阈值需要定期复审,而不是“一次调好、长期不动”。
四、案例场景:一个阈值调整如何影响百万级成本
假设某电商平台日均交易 100 万笔,当前阈值下每天拦截 2 万笔,其中真实欺诈 1.2 万笔,误杀 0.8 万笔;漏放欺诈 0.3 万笔。单笔欺诈平均损失 200 元,单笔误杀综合成本 30 元,人工审核成本 2 元。则当前预期损失约为:
漏放损失 = 3000 * 200 = 600,000 元
误杀损失 = 8000 * 30  = 240,000 元
审核成本 = (3000+8000) * 2 = 22,000 元
合计     ≈ 862,000 元/天
如果稍微降低阈值,拦截数增加到 2.5 万笔,真实欺诈拦截提升到 1.4 万笔,漏放降到 0.1 万笔,但误杀增加到 1.1 万笔。重新计算后,漏放损失降至 20 万元,误杀损失升至 33 万元,审核成本约 2.4 万元,合计约 55.4 万元/天。仅一个阈值方向的微调,每天就能节省约 30 万元。这个例子说明,阈值优化的收益往往不是线性的,而是存在明显的“成本洼地”。
| 指标 | 调整前 | 调整后 | 变化 |
|---|---|---|---|
| 拦截笔数 | 20,000 | 25,000 | +5,000 |
| 真实欺诈拦截 | 12,000 | 14,000 | +2,000 |
| 漏放欺诈 | 3,000 | 1,000 | -2,000 |
| 误杀正常交易 | 8,000 | 11,000 | +3,000 |
| 预期损失(元/天) | 862,000 | 554,000 | -308,000 |
五、常见误区与复盘:为什么“最优阈值”经常失效
在实际项目中,阈值优化最常见的失败原因并不是数学方法不对,而是前提假设出了问题。以下四类误区尤其值得警惕:
- 标签延迟与不完整:欺诈标签往往在拒付发生后才能确认,导致近期样本的漏报被低估,阈值被错误地调高。
- 成本口径不一致:风控团队用“欺诈金额”,运营团队用“客诉成本”,财务团队用“坏账拨备”,三者口径不同,优化目标就会互相冲突。
- 过拟合历史样本:在某个特定时间段上找到的“最优阈值”,可能只是拟合了当时的欺诈手法,换一个月份就失效。
- 忽略业务约束:数学上的最优阈值可能导致拦截率过高,触发监管或客户体验红线,最终无法上线。
复盘提醒:每次阈值调整后,都应记录调整原因、预期收益、实际表现与偏差分析。没有复盘的阈值优化,只是一次性的数字游戏,无法形成组织能力。
六、实战价值:把风控从成本中心变成利润杠杆
掌握阈值优化与预期损失控制,带来的价值是多层次的。在成本层面,它直接减少欺诈损失与误杀损失,提升每一笔交易的风险调整后收益。在体验层面,它避免“一刀切”式拦截,让正常用户顺畅通过,降低客诉与流失。在合规层面,它提供可解释、可审计的决策依据,满足监管对风控策略透明度的要求。在组织层面,它建立了一套跨团队统一的成本语言,让风控、产品、运营与财务能够在同一张表上讨论问题。
本课程后续将沿着“成本定义—曲线计算—优化求解—稳定性评估—上线监控”的主线逐步展开,并配合真实场景的代码与参数示例。你现在需要建立的第一个思维习惯是:看到任何一个阈值,先问它的预期损失是多少,而不是先问它的准确率是多少。只有把阈值放回成本函数中,它才真正具备可优化的意义。