1. 课程导入
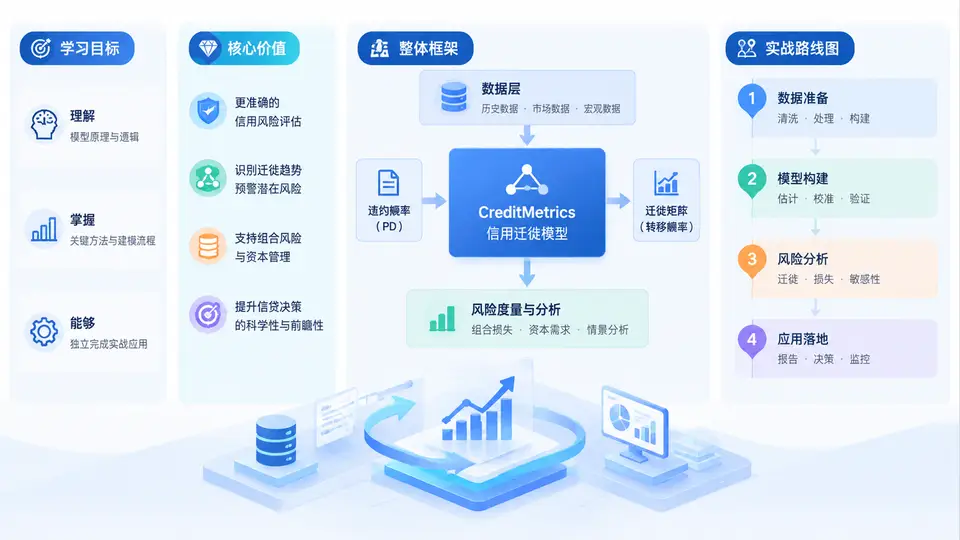
欢迎进入《CreditMetrics信用迁徙风险模型实战》课程。在正式进入建模细节之前,本章作为全课程的导入,将帮助大家建立对CreditMetrics模型的整体认知:它解决什么问题、为什么值得学习、由哪些模块构成,以及在本课程中我们将沿着怎样的路线从零到一完成一次可落地的信用风险量化实践。
一、学习目标:从“知道”到“会用”
CreditMetrics由J.P. Morgan于1997年提出,是最早将信用评级迁徙与组合信用风险度量系统化的模型之一。学习本课程,不是停留在概念背诵,而是希望达成以下四个层次的目标:
- 理解原理:掌握信用迁徙矩阵、违约概率、回收率、信用价差与相关性在组合风险中的角色。
- 掌握流程:能够独立完成从数据准备、迁徙矩阵构建、敞口映射、模拟计算到风险指标输出的完整链路。
- 具备实操:能够使用Python或同类工具实现CreditMetrics的核心计算,并读懂关键参数与日志。
- 形成判断:能够识别模型假设的边界,评估结果合理性,并在业务场景中解释风险含义。
核心价值一句话总结:CreditMetrics让信用风险从“单笔违约判断”升级为“组合价值分布度量”,从而支持授信定价、资本配置、限额管理与压力测试。
二、核心原理:信用迁徙如何驱动风险
CreditMetrics的核心思想是:一笔贷款或债券的价值,不仅取决于是否违约,还取决于借款人信用等级的变化。评级上调、下调或违约,都会改变未来现金流的现值,从而带来信用价值波动。
模型通常包含五个关键输入:
- 信用迁徙矩阵:描述一定期限内评级从某一等级迁移到另一等级的概率。
- 违约回收率:违约后能够收回的比例,直接影响违约损失。
- 信用价差曲线:用于对不同评级、不同期限的现金流进行折现。
- 敞口与期限:每笔资产的暴露金额、剩余期限和还款结构。
- 资产相关性:组合中不同债务人之间的联合迁徙关系,是组合分散效应的关键。
在计算上,CreditMetrics通过模拟或解析方法生成组合价值分布,并据此计算预期损失、非预期损失、VaR和边际风险贡献等指标。其逻辑可以概括为:评级状态 → 资产价值 → 组合价值分布 → 风险指标。
三、整体框架与实战路线图
为了让大家在学习过程中不迷失方向,我们将CreditMetrics实战拆解为六个阶段。下表给出了每个阶段的核心任务、关键产出和常见工具。
| 阶段 | 核心任务 | 关键产出 | 常用工具/方法 |
|---|---|---|---|
| 1. 数据准备 | 收集评级、敞口、期限、回收率、价差数据 | 清洗后的资产清单 | Pandas、SQL |
| 2. 迁徙矩阵构建 | 估计或校准评级迁移概率 | 年度/多年期迁徙矩阵 | 历史频率法、队列法、调整 |
| 3. 敞口与估值 | 计算各评级状态下的资产现值 | 状态-价值映射表 | 现金流折现、价差曲线 |
| 4. 相关性建模 | 刻画债务人联合迁徙 | 相关系数矩阵或因子结构 | 资产价值模型、Copula |
| 5. 模拟与计算 | 生成组合价值分布 | 损失分布、VaR、ES | 蒙特卡洛模拟 |
| 6. 结果解读 | 分析风险来源与集中度 | 风险报告与限额建议 | 边际贡献、压力测试 |
本课程后续章节将严格沿着这条路线推进。每一章都会先讲清业务含义,再给出可运行的代码或配置,最后通过案例复盘巩固理解。
四、案例场景:一家银行的组合风险管理
假设某商业银行公司金融部持有100笔企业贷款,评级覆盖AAA到CCC。风险经理需要回答三个问题:第一,未来一年组合的预期损失是多少?第二,在99%置信水平下,非预期损失有多大?第三,哪些行业或评级段的边际风险贡献最高?
使用CreditMetrics,我们可以先根据历史数据构建迁徙矩阵,再结合每笔贷款的敞口、期限和回收率,模拟每笔贷款在一年后的评级状态,并重新估值。经过数万次模拟后,得到组合价值分布,进而计算VaR和边际贡献。这个过程在代码中通常表现为以下核心步骤:
# 伪代码示例:CreditMetrics核心流程
migration_matrix = load_migration_matrix("rating_migration.csv")
exposures = load_exposures("loan_portfolio.csv")
recovery_rates = load_recovery_rates("recovery.csv")
spread_curve = load_spread_curve("spread_curve.csv")

for sim in range(n_simulations):
    for loan in exposures:
        new_rating = sample_rating(loan.rating, migration_matrix)
        value = revalue_loan(loan, new_rating, spread_curve, recovery_rates)
        portfolio_value[sim] += value

var_99 = percentile(portfolio_value, 1)
expected_loss = mean(portfolio_value)
提示:在实际项目中,迁徙矩阵的校准和相关性设定往往比模拟本身更耗时。数据质量决定了模型结果的可信度,切勿跳过数据清洗与业务校验。
五、常见误区与复盘要点
初学者在学习CreditMetrics时容易陷入以下误区,本章先做提醒,后续章节会逐一展开。
- 误区一:把迁徙矩阵当作固定常数。迁徙矩阵具有周期性和行业差异,需要定期校准和压力调整。
- 误区二:忽略回收率的不确定性。回收率本身是随机变量,固定值会低估尾部风险。
- 误区三:相关性设定过于随意。相关性直接影响组合分散效应,错误设定会导致VaR严重偏差。
- 误区四:只看最终VaR,不看中间过程。敞口映射、折现和状态采样中的任何错误都会传导到结果。
复盘建议:每完成一次建模,至少回答三个问题:结果是否符合业务直觉?关键假设是否经过敏感性测试?模型输出能否被非技术背景的风险委员会理解?
通过本章的导入,大家已经对CreditMetrics的学习目标、核心价值、整体框架和实战路线有了全局认识。接下来,我们将从信用评级体系与迁徙矩阵的基础开始,逐步搭建属于你自己的信用风险量化模型。