3. 一致性校验核心概念
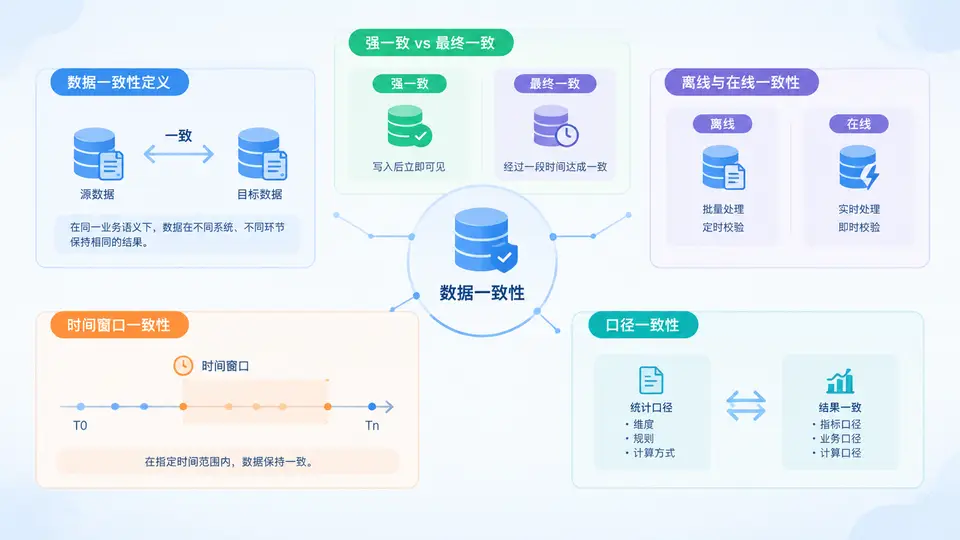
在风控训练场景中,生产数据一致性校验的目标不是“让所有数据看起来一样”,而是判断同一业务事实在不同系统、不同时间、不同口径下是否表达一致。若概念边界不清,校验规则就会写成“全表比对”或“抽样看数”,既无法定位问题,也无法支撑上线决策。本节围绕五个核心概念展开:数据一致性定义、强一致与最终一致、离线与在线一致性、时间窗口一致性、口径一致性。
一、数据一致性定义:同一事实的等价表达
数据一致性是指:对于同一个业务实体或业务事件,在不同存储、计算、传输环节中,其关键属性应满足预先定义的等价关系。这里的“等价”不是逐字节相等,而是业务语义上的可接受关系。例如,风控训练样本中的“用户近7天逾期次数”,在特征平台、训练样本表和在线特征服务中,允许存在精度差异,但不允许出现量级差异或方向性错误。
一致性校验通常包含三个层次:
- 存在性一致:该有的记录不能丢,不该有的记录不能多。
- 值域一致:数值、枚举、空值比例在允许范围内。
- 关系一致:主外键、聚合关系、派生关系可推导且不矛盾。
二、强一致与最终一致:约束强度与业务容忍
强一致要求任何时刻读取到的数据都是最新且相同的。在风控训练生产链路中,强一致通常只出现在关键主数据或交易流水落库环节。最终一致则允许中间状态存在,但经过一定时间后必须收敛到一致状态。离线特征回填、在线特征同步、样本拼接大多采用最终一致模型。
| 对比维度 | 强一致 | 最终一致 |
|---|---|---|
| 读取结果 | 任意时刻相同 | 短时可能不同,最终收敛 |
| 典型场景 | 支付扣款、额度占用 | 特征同步、样本回填、报表汇总 |
| 校验策略 | 实时比对、事务校验 | 窗口内收敛校验、延迟容忍 |
| 常见风险 | 性能瓶颈、可用性下降 | 长期不一致、脏数据残留 |
选择哪种一致性,取决于业务对“错误读取”的容忍度。风控训练中,若在线特征比离线特征晚到几分钟,但训练样本使用的是T+1离线快照,则不能简单判定为不一致,而应检查时间窗口和口径是否对齐。
三、离线与在线一致性:链路差异与校验重点
离线链路通常基于数仓、Spark、Hive 等批量计算,强调可回溯、可重跑;在线链路基于特征服务、缓存、实时计算,强调低延迟、高可用。两者天然存在差异:
- 计算时机不同:离线按分区调度,在线按请求触发。
- 数据来源不同:离线可能读全量快照,在线只读最新增量。
- 精度与编码不同:离线用 Decimal,在线可能用 Float;离线用字符串枚举,在线用整型编码。
- 空值处理不同:离线填充默认值,在线可能直接返回空。
因此,离线与在线一致性校验不能直接做全量等值比对,而应建立“映射后比对”规则。例如,将在线整型编码映射回离线枚举,再比较分布和关键分位数。
-- 离线侧:统计某特征在训练样本中的分布
SELECT
  feature_name,
  COUNT(*) AS total_cnt,
  SUM(CASE WHEN feature_value IS NULL THEN 1 ELSE 0 END) AS null_cnt,
  AVG(CAST(feature_value AS DOUBLE)) AS avg_val
FROM offline_training_sample
WHERE dt = '2025-03-01'
GROUP BY feature_name;

-- 在线侧:统计同一特征在在线服务日志中的分布
SELECT
  feature_name,
  COUNT(*) AS total_cnt,
  SUM(CASE WHEN feature_value IS NULL THEN 1 ELSE 0 END) AS null_cnt,
  AVG(feature_value) AS avg_val
FROM online_feature_log
WHERE dt = '2025-03-01'
GROUP BY feature_name;
四、时间窗口一致性:对齐业务时间与计算时间
时间窗口一致性是风控训练数据校验中最容易被忽视、也最容易引发误判的概念。同一特征在不同时间窗口下计算,结果本就不同。例如“近7天逾期次数”和“近30天逾期次数”不能直接比较;“截至昨日”和“截至当前”也不能直接比较。
校验时必须明确三个时间:
- 业务时间:事件实际发生时间。
- 计算时间:任务实际调度运行时间。
- 快照时间:数据被固化或读取的时间点。
若离线样本使用 T+1 快照,在线服务使用实时快照,则校验应选择同一业务时间分区,并允许在线侧存在合理延迟。常见做法是:以离线分区时间为基准,在线侧取对应时间窗口内的最新值,并设置延迟容忍阈值。
校验参数示例:
offline_partition = 2025-03-01
online_window_start = 2025-03-01 00:00:00
online_window_end   = 2025-03-02 00:00:00
delay_tolerance     = 5min
value_tolerance     = 0.01
null_rate_tolerance = 0.02
五、口径一致性:定义先行,校验后置
口径一致性是指同一指标在不同系统中的业务定义、过滤条件、统计粒度、单位、空值规则必须一致。口径不一致时,即使数据完全正确,比对结果也必然不一致。例如:
- 离线“逾期次数”包含已结清订单,在线只统计未结清订单。
- 离线按用户去重,在线按设备去重。
- 离线金额单位为元,在线金额单位为分。
- 离线将空值视为0,在线将空值排除。
建议为每个核心特征建立口径卡片,至少包含:指标名称、业务定义、统计粒度、过滤条件、时间范围、单位、空值处理、更新频率、责任人。校验规则直接从口径卡片生成,避免口头约定。
六、案例与复盘:一次典型的“假不一致”排查
某风控训练样本上线前,校验发现离线与在线“近7天申请次数”差异率达到 18%。初步怀疑在线特征服务有 bug。排查后发现:
- 离线口径为“近7个自然日”,在线口径为“近168小时”。
- 离线包含被拒绝的申请,在线只包含进入风控决策的申请。
- 离线按申请人去重,在线按申请单去重。
修正口径后,差异率降至 0.3%,剩余差异来自在线延迟和空值处理。这个案例说明:一致性校验的第一步不是写 SQL,而是确认“比的是什么”。
掌握这五个核心概念后,后续的校验规则设计、阈值设定和差异归因才有稳定基础。一致性校验的本质,是用工程手段证明“不同链路对同一业务事实的表达是可解释、可收敛、可接受的”。