1. 课程导入
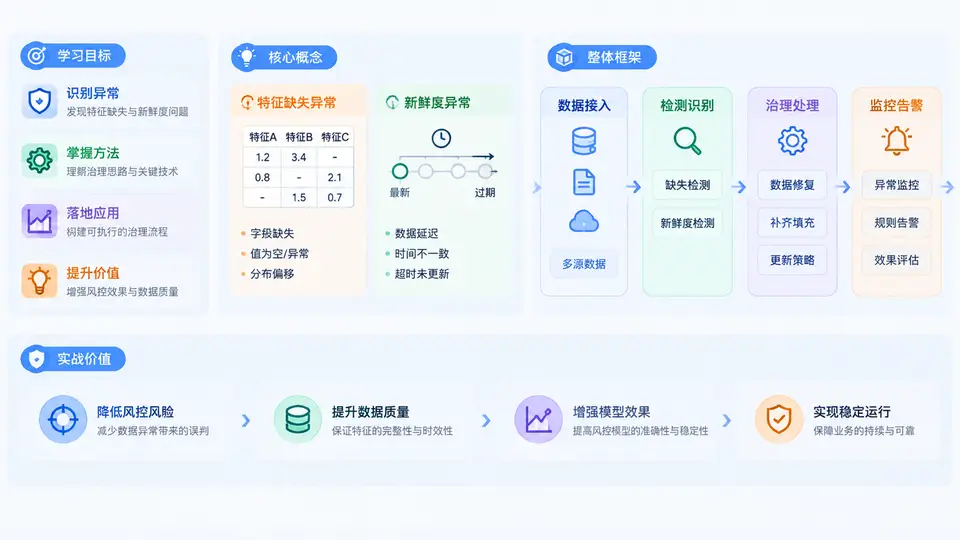
在实时风控系统中,模型效果往往不取决于算法本身,而取决于特征是否“按时、完整、可信”地到达。很多线上事故并非模型突然失效,而是特征在某个时间窗口内出现缺失、延迟或陈旧,导致评分偏移、策略误杀或漏放。本课程聚焦两个高频却常被忽视的问题:特征缺失异常与特征新鲜度治理。前者关注“值有没有、对不对”,后者关注“值是不是最新的、是否在可接受的时间范围内”。二者共同决定了风控决策的稳定性与可解释性。
学习目标
完成本课程后,你应能够独立完成以下任务:
- 识别风控特征缺失的典型模式:整列缺失、稀疏缺失、时间窗口缺失、维度对齐缺失。
- 区分“数据源故障”“计算链路延迟”“特征回填错误”“上游口径变更”四类根因。
- 设计新鲜度指标:事件时间、处理时间、特征年龄、端到端延迟、水位线。
- 搭建缺失与新鲜度的监控、告警、降级与自愈闭环。
- 在离线回放与线上灰度中验证治理策略,避免“修了监控、坏了策略”。
核心概念:缺失不是空值,新鲜度不是时间戳
在风控语境中,缺失至少包含三层含义:物理缺失(字段不存在)、逻辑缺失(字段存在但语义为空)、业务缺失(值存在但不可用,如全为默认值)。如果只把 null 当作缺失,就会漏掉“全零填充”“默认分桶”“过期缓存”等隐性缺失。新鲜度同样不只是“有没有时间戳”,而是特征值所代表的事件时间与当前决策时间之间的差距,以及该差距是否超过业务容忍阈值。
关键公式:特征年龄 = 决策时刻 − 特征事件时间;端到端延迟 = 特征可查询时刻 − 特征事件时间。前者决定“是否过期”,后者决定“是否来得及”。
为了统一语言,本课程约定以下术语:
| 术语 | 含义 | 典型阈值示例 |
|---|---|---|
| 事件时间 | 业务事件真实发生的时间 | 交易创建时间 |
| 处理时间 | 特征计算完成并可被查询的时间 | Flink 算子输出时间 |
| 特征年龄 | 决策时刻与事件时间之差 | ≤ 5 分钟 |
| 缺失率 | 缺失记录数 / 总记录数 | ≤ 0.1% |
| 水位线 | 允许迟到数据的最大边界 | 2 分钟 |
整体框架:从发现到自愈的四层治理
本课程将治理体系拆为四层,层层递进:
- 感知层:采集缺失率、特征年龄、延迟分位数、维度覆盖率,形成特征健康画像。
- 诊断层:通过血缘、日志、对比基线定位根因,区分偶发与系统性异常。
- 决策层:根据严重程度选择告警、降级、切换备用特征或拒绝决策。
- 自愈层:自动回填、重跑、熔断与恢复验证,形成闭环。
治理不是“把缺失率降到零”,而是在可接受的成本下,让系统在异常时仍能做出可控决策。零缺失往往意味着过度保守或过度补数,反而引入新风险。
案例场景:一次“全零特征”引发的误杀
某支付风控系统在凌晨批量任务延迟后,实时特征服务返回了全零向量。模型将全零解释为“低风险”,导致一批高风险交易被放行。事后复盘发现:缺失监控只统计了 null,未统计默认值;新鲜度监控只看了时间戳,未看事件时间。修复方案包括:增加默认值占比监控、引入特征年龄告警、在特征不可用时切换至保守策略。
# 特征健康检查伪代码
def check_feature_health(feature, now):
    missing_rate = count_null(feature) / total
    default_rate = count_default(feature) / total
    age = now - feature.event_time
    if missing_rate > 0.001 or default_rate > 0.05:
        return "DEGRADE"
    if age > timedelta(minutes=5):
        return "STALE"
    return "OK"
常见误区与复盘要点
- 误区一:只监控离线表,不监控线上特征服务。离线正常不代表线上正常。
- 误区二:把新鲜度等同于“最近更新时间”。缓存刷新时间不等于事件时间。
- 误区三:缺失时统一填 0。填 0 会改变模型输入分布,可能比缺失更危险。
- 误区四:告警阈值一刀切。不同特征对时效敏感度不同,应分级治理。
复盘时务必回答三个问题:异常何时开始?影响哪些决策?如果再次发生,系统能否在 1 分钟内自动降级?答不上来,说明治理闭环尚未形成。