3. 数据血缘核心概念
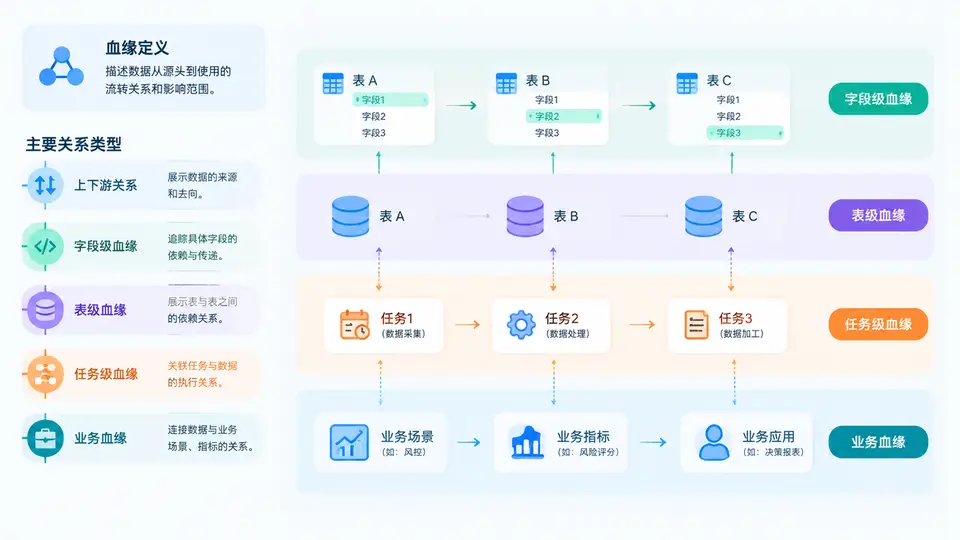
在风控数据治理中,血缘不是一张“好看的关系图”,而是定位问题、评估变更影响、追溯指标口径的基础设施。很多团队把血缘简单理解为“表A加工成表B”,结果在指标口径争议、数据异常排查、监管审计时仍然束手无策。根本原因在于:血缘有粒度之分,不同粒度回答不同问题,必须组合使用。
一、血缘的定义与本质
数据血缘(Data Lineage)描述数据从产生、加工、流转到消费的全链路关系。它至少包含三个要素:节点(数据实体或处理过程)、边(数据流动方向)、属性(加工逻辑、时间、责任人)。在风控场景中,血缘的核心价值是回答四个问题:这个指标从哪来?改了这张表会影响谁?这个字段为什么为空?监管要求的计算口径是否可还原?
血缘的本质是“可追溯的依赖关系”。依赖关系越细,追溯能力越强,但维护成本也越高。因此,血缘治理不是追求最细粒度,而是根据治理目标选择合适粒度,并保证不同粒度之间可关联。
二、上下游关系:血缘的方向性
血缘天然有方向。上游是数据来源,下游是数据消费。在风控体系中,典型链路为:业务系统产生原始数据 → 贴源层(ODS)→ 明细层(DWD)→ 汇总层(DWS)→ 指标层(ADS)→ 报表/模型/决策引擎。上游变更会向下游传播,下游问题需要向上游追溯。
三、六类血缘粒度的区别与联系
实际工作中常见的血缘粒度包括:表级血缘、字段级血缘、任务级血缘、业务血缘。它们不是并列替代关系,而是从不同视角描述同一链路。
| 血缘类型 | 描述对象 | 核心问题 | 典型用途 | 局限 |
|---|---|---|---|---|
| 表级血缘 | 表与表 | 这张表由哪些表加工而来? | 影响分析、调度依赖、下线评估 | 无法定位具体字段问题 |
| 字段级血缘 | 字段与字段 | 这个指标字段来自哪些源字段? | 口径追溯、敏感字段追踪、精准影响分析 | 解析成本高,SQL复杂时易缺失 |
| 任务级血缘 | 任务与任务 | 哪个任务产出哪张表?任务间如何依赖? | 调度排障、失败重跑、SLA监控 | 不直接反映数据语义 |
| 业务血缘 | 业务概念与数据 | “逾期率”这个业务指标对应哪些表和字段? | 指标口径治理、业务影响沟通 | 依赖人工维护,易与物理实现脱节 |
四者的联系可以概括为:业务血缘定义“要什么”,表级血缘描述“存在什么”,字段级血缘解释“怎么算出来”,任务级血缘支撑“怎么跑出来”。缺少任何一层,治理都会出现盲区。例如只做表级血缘,当“逾期率”口径争议时,无法说明分子分母分别来自哪些字段;只做字段级血缘,当调度失败时,无法快速定位是哪个任务导致下游延迟。
四、方法流程:从采集到关联
建立可用血缘体系通常遵循以下流程:
- 元数据采集:从调度系统、数仓、BI工具采集表、字段、任务、脚本信息。
- SQL解析:解析ETL/ELT脚本,提取表级和字段级依赖关系。
- 任务关联:将任务与产出表、输入表绑定,形成任务级血缘。
- 业务映射:将指标、业务术语与物理字段建立映射,形成业务血缘。
- 存储与查询:以图结构存储节点和边,支持正向、反向、多层追溯。
- 持续校验:通过运行日志和产出数据校验血缘准确性,及时修正。
-- 字段级血缘解析示例(简化)
INSERT INTO dws_risk_overdue_d
SELECT
  apply_id,
  CASE WHEN overdue_days > 0 THEN 1 ELSE 0 END AS is_overdue,
  loan_amount
FROM dwd_loan_detail
WHERE dt = '${bizdate}';

-- 解析结果:
-- dws_risk_overdue_d.apply_id      <- dwd_loan_detail.apply_id
-- dws_risk_overdue_d.is_overdue    <- dwd_loan_detail.overdue_days
-- dws_risk_overdue_d.loan_amount   <- dwd_loan_detail.loan_amount
五、案例场景:一次口径争议的追溯
某风控团队发现“首逾率”指标在报表中为3.2%,但决策引擎中为2.8%。仅看表级血缘,两张表都来自同一张DWD表,无法解释差异。启用字段级血缘后发现:报表口径的分母是“放款成功且未结清”的订单,而决策引擎口径的分母是“所有申请通过”的订单。再结合业务血缘,确认两个口径分别对应“资产质量监控”和“策略效果评估”两个业务场景,并非数据错误,而是口径定义不同。最终通过指标口径治理,将两个口径分别命名并登记,消除了争议。
六、误区复盘与治理建议
- 误区一:血缘等于调度依赖。调度依赖只说明任务先后,不说明数据语义。两者必须区分。
- 误区二:血缘一次建设即可长期使用。SQL变更、任务重构、指标调整都会导致血缘失效,必须持续更新。
- 误区三:业务血缘可以自动生成。业务血缘涉及业务定义和口径约定,通常需要人工确认和治理流程保障。
- 建议:以业务血缘为牵引,以字段级血缘为支撑,以表级和任务级血缘为底座,形成分层可用的血缘体系。
理解这六类概念的区别与联系,是后续开展影响分析、口径治理和监管追溯的前提。只有把血缘粒度与治理目标对齐,血缘才能真正成为风控数据治理的生产力工具。