1. 课程导入
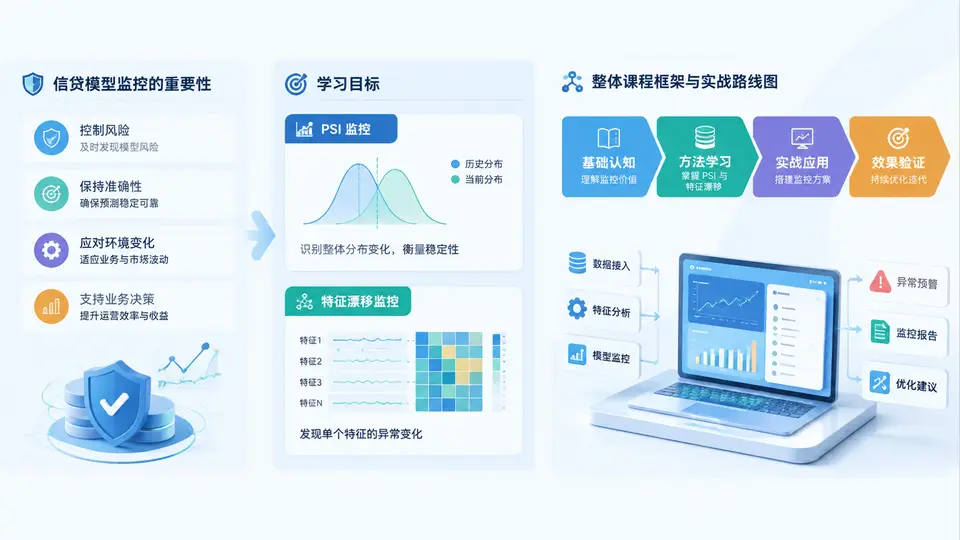
在信贷业务中,模型上线从来不是终点,而是风险管理的起点。无论是申请评分卡、行为评分卡,还是额度定价、反欺诈与催收策略模型,它们都建立在一个隐含假设之上:未来数据的分布与建模时的数据分布保持相对一致。一旦这个假设被打破,模型输出的分数就会失真,原本用于区分好坏客户的排序能力会迅速衰减。PSI(Population Stability Index,群体稳定性指标)与特征漂移监控,正是用来回答一个核心问题:模型今天看到的客户,还是不是它当初认识的那批客户?
很多团队在模型上线后只关注KS、AUC等离线指标,却忽略了线上数据分布的变化。实际业务中,一次渠道策略调整、一轮营销活动、一次外部征信数据源升级,甚至宏观经济波动,都可能让入模特征的分布发生迁移。如果缺乏系统化监控,风险往往在贷后表现恶化时才被察觉,而此时损失已经发生。因此,本课程不是单纯讲一个指标公式,而是围绕“监控什么、怎么算、如何预警、怎样归因、如何闭环”构建一套可落地的实战方法。
学习目标:从会算PSI到能定位漂移根因
完成本课程后,你应当能够独立完成以下任务:
- 理解PSI、特征漂移、概念漂移与模型衰减之间的区别与联系;
- 掌握PSI的计算逻辑、分箱策略、阈值设定及其业务解释边界;
- 能够对申请、行为、催收等不同场景设计差异化的监控指标体系;
- 使用Python/SQL构建日级、周级、月级的特征漂移监控流水线;
- 通过监控报表定位漂移来源,判断是数据问题、业务变化还是模型本身失效;
- 形成“监控—预警—归因—处置—复盘”的闭环运营机制。
核心原理:PSI与特征漂移到底在监控什么
PSI衡量的是两个群体在同一变量上的分布差异。在模型监控中,通常将建模时的训练集或某个稳定基准期作为“预期分布”,将当前线上近期样本作为“实际分布”,按分箱计算占比变化。其经典公式为:
PSI = Σ (Actual% - Expected%) × ln(Actual% / Expected%)PSI的值越大,说明当前样本与基准样本的分布差异越明显。行业常用的经验阈值为:PSI小于0.1表示分布稳定;0.1到0.25之间表示轻微漂移,需要关注;大于0.25表示显著漂移,需要排查原因并考虑模型迭代。但必须强调,阈值不是绝对标准,不同客群、不同特征、不同业务阶段应结合实际情况调整。
特征漂移监控则更细粒度地观察单个入模变量。它既包括数值型特征的均值、方差、分位数变化,也包括类别型特征的类别占比变化,还包括缺失率、异常值比例等数据质量指标。PSI可以看作特征漂移监控的一种汇总手段,但仅看PSI不够,因为两个分布可能PSI相同,却由完全不同的分箱变化引起。因此,实战中通常采用“PSI总览 + 特征级明细 + 业务维度下钻”的三层结构。
方法流程:从数据准备到监控闭环
一个完整的PSI与特征漂移监控流程,通常包含以下步骤:
- 确定监控对象:明确要监控哪些模型、哪些特征、哪些业务线,以及监控频率是日级、周级还是月级。
- 建立基准分布:选择训练集、跨时间验证集或某个业务稳定期作为基准,并保存每个特征的分箱边界与预期占比。
- 数据采集与清洗:从数仓或特征平台抽取当前样本,处理缺失、异常、类型转换,确保与基准期口径一致。
- 分箱与占比计算:数值型特征按基准分箱边界切分,类别型特征按类别归并,计算实际占比。
- 计算PSI与辅助指标:输出PSI值,同时计算缺失率变化、均值偏移、IV变化等。
- 预警与归因:根据阈值触发预警,结合业务事件、渠道变化、数据源变更进行根因分析。
- 处置与复盘:决定是否重新校准、重新训练、调整策略或仅持续观察,并记录处置结果。
下面是一个简化的Python示例,展示如何对单个数值特征计算PSI:
import numpy as np
import pandas as pd

def calc_psi(expected, actual, bins=10):
    # 基于基准分布确定分箱边界
    breakpoints = np.percentile(expected, np.linspace(0, 100, bins + 1))
    breakpoints[0] = -np.inf
    breakpoints[-1] = np.inf
    breakpoints = np.unique(breakpoints)

    expected_counts = pd.cut(expected, bins=breakpoints).value_counts(normalize=True).sort_index()
    actual_counts = pd.cut(actual, bins=breakpoints).value_counts(normalize=True).sort_index()

    # 避免除零,用极小值平滑
    expected_pct = expected_counts.replace(0, 1e-6)
    actual_pct = actual_counts.replace(0, 1e-6)

    psi = np.sum((actual_pct - expected_pct) * np.log(actual_pct / expected_pct))
    return psi

# 示例:基准期与当前期的年龄分布
base_age = np.random.normal(35, 8, 10000)
curr_age = np.random.normal(38, 9, 10000)
print("Age PSI:", round(calc_psi(base_age, curr_age), 4))
在实际工程中,这段逻辑会被封装成调度任务,按日或按周运行,并将结果写入监控表,最终通过BI看板或告警系统呈现。
案例场景:一次渠道调整引发的PSI告警
某消费金融公司上线了一款现金贷产品,申请评分卡运行三个月后,监控系统显示“近30天收入特征PSI=0.31”,触发红色预警。初步排查发现,模型本身没有改动,数据源也没有变更。进一步按渠道下钻后发现,某新合作渠道的进件量在两周内增长了4倍,而该渠道客户收入普遍偏低且缺失率较高。由于模型训练时该渠道样本极少,导致当前样本分布与基准分布产生显著差异。
团队随后采取了三项措施:第一,对该渠道单独计算PSI并纳入渠道级监控;第二,评估该渠道客户的KS是否仍在可接受范围;第三,在策略层面对该渠道设置临时额度上限,并加快样本积累。一个月后,随着该渠道样本进入训练集,模型完成迭代,PSI回落至0.12。这个案例说明,PSI告警不是终点,而是业务排查的起点。
常见误区与复盘清单
在初期实践中,团队容易陷入以下误区:
| 误区 | 问题表现 | 正确做法 |
|---|---|---|
| 只看PSI,不看业务 | PSI升高就立即重训模型 | 先归因,区分数据问题、业务变化与模型失效 |
| 分箱边界随当前数据变化 | 每次计算都重新分箱,PSI不可比 | 固定基准分箱边界,保证跨期可比 |
| 忽略缺失率与异常值 | PSI正常但数据质量已恶化 | 将缺失率、零值率、极值比例纳入监控 |
| 阈值一刀切 | 所有特征都用0.1/0.25 | 按特征重要性、业务敏感度分层设定阈值 |
| 监控结果不闭环 | 报表很多,无人处置 | 建立预警工单、责任人、处置时限与复盘机制 |
整体课程框架与实战路线图
本课程共30章,整体分为五个模块:基础认知、指标与计算、工程实现、场景实战、体系闭环。第1章帮助你建立全局视角;后续章节将逐步深入PSI计算细节、分箱策略、特征级监控、模型级监控、报表设计、告警配置、根因分析方法,并结合申请评分卡、行为评分卡、反欺诈模型等真实场景展开。每一章都配有可运行的代码片段、参数说明与复盘清单,帮助你从“知道PSI”走向“能落地监控体系”。
实战路线图可以概括为:先跑通单特征PSI计算,再搭建批量监控任务,然后接入调度与告警,最后形成监控看板和处置流程。不要一开始就追求大而全的平台,先用最小可行方案覆盖核心模型和核心特征,再逐步扩展。监控体系的价值不在于指标多,而在于能否及时发现问题、准确定位原因、有效推动处置。