1. 课程导入
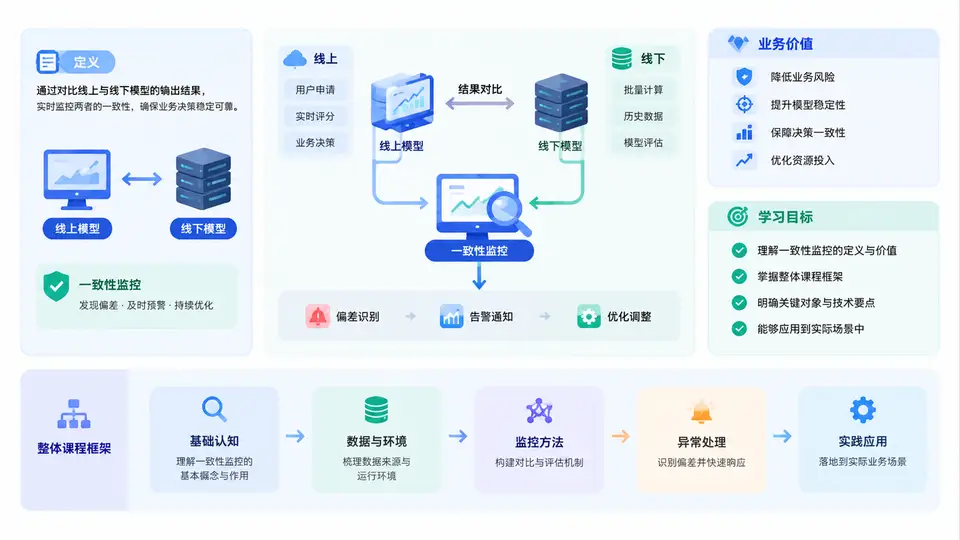
在信贷风控体系中,模型上线并不意味着工作结束,恰恰相反,它意味着模型真正开始接受业务检验。很多团队在建模阶段投入大量精力,离线AUC、KS、PSI等指标表现良好,但上线后却出现通过率异常、逾期率抬升、客群结构偏移等问题。造成这种落差的核心原因之一,就是线上线下一致性没有被系统监控。本课程围绕这一主题展开,帮助你建立从指标定义、监控设计、异常定位到闭环治理的完整能力。
一、什么是信贷模型线上线下一致性监控
信贷模型线上线下一致性监控,是指对模型在离线训练与评估环境和线上生产决策环境中的输入数据、特征计算、模型打分、策略执行及最终业务结果进行持续比对,识别并量化差异,进而定位原因、评估风险并推动修复的一整套机制。
它至少包含四个层面的一致性:
- 数据一致性:线上请求字段、埋点数据与离线样本字段在口径、时点、枚举值上是否一致。
- 特征一致性:同一客户在离线特征回刷与线上实时计算中,特征取值是否一致。
- 打分一致性:相同输入下,离线评分与线上评分是否一致,评分分布是否稳定。
- 业务一致性:通过率、拒绝率、额度分布、风险表现等业务指标是否符合预期。
可以用一个简化公式理解监控目标:
一致性偏差 = 线上实际表现 - 离线预期表现
监控价值 = 偏差可发现 + 原因可定位 + 风险可量化 + 修复可验证
二、业务价值:为什么它值得单独成为一门课
一致性监控不是技术团队的“自嗨”,而是直接关联资产质量和经营效率。其业务价值主要体现在以下方面:
| 价值维度 | 具体表现 | 业务影响 |
|---|---|---|
| 风险防控 | 及时发现评分偏移、特征失效、策略误杀 | 降低异常逾期与集中风险 |
| 经营决策 | 保证通过率、额度、定价符合策略预期 | 稳定放款规模与收益 |
| 客户体验 | 减少因系统不一致导致的误拒、重复授信 | 提升申请转化与满意度 |
| 合规审计 | 留存监控证据,支持模型治理与监管检查 | 降低合规风险 |
| 研发效率 | 快速定位是数据、特征还是模型问题 | 缩短故障恢复时间 |
核心观点:一致性监控的本质不是“证明模型没问题”,而是“尽早发现模型有问题,并知道问题出在哪一层”。
三、核心原理:从离线到线上的偏差链路
要理解一致性监控,必须先理解偏差是如何产生的。一个信贷模型从离线到线上,通常经历样本构建、特征加工、模型训练、评分卡部署、策略编排、实时决策等环节。每个环节都可能引入偏差。
离线样本 → 特征回刷 → 模型训练 → 模型文件 → 线上部署
   ↓           ↓           ↓          ↓          ↓
时点偏差   口径偏差   版本偏差   参数偏差   计算偏差
   ↓           ↓           ↓          ↓          ↓
                最终表现为评分/通过率/逾期率偏差
常见偏差来源包括:
- 时点不一致:离线使用T+1数据,线上使用实时数据,导致特征取值不同。
- 口径不一致:离线缺失值填充为0,线上填充为-1;离线用近6个月,线上用近3个月。
- 版本不一致:模型文件、特征脚本、策略配置未同步更新。
- 计算不一致:离线用Python计算,线上用Java/C++实现,浮点精度或逻辑分支不同。
- 数据源不一致:线上调用第三方接口失败后走了默认值,离线样本没有该场景。
排查口诀:先看数据,再看特征;先看特征,再看模型;先看模型,再看策略;先看策略,再看业务。逐层缩小范围,避免一上来就怀疑模型本身。
四、方法流程:一致性监控的闭环框架
一套可落地的一致性监控体系,通常遵循以下闭环流程:
- 定义监控指标:确定要监控哪些字段、特征、评分和业务指标。
- 建立基线:以离线评估结果、历史稳定期数据作为基线。
- 采集线上数据:记录请求入参、特征快照、模型打分、策略决策结果。
- 比对与告警:按日/小时计算偏差,设置阈值并触发告警。
- 定位根因:从数据、特征、模型、策略四个层面逐层排查。
- 修复与验证:修复后重新比对,确认偏差收敛。
- 沉淀与复盘:将案例纳入知识库,优化监控规则。
下面是一个简化的监控配置示例,用于说明线上打分与离线打分的比对逻辑:
monitor:
  name: score_consistency
  compare:
    offline_score: offline_score_t1
    online_score: online_score_realtime
  metrics:
    - mean_diff
    - psi
    - ks
    - null_rate_diff
  threshold:
    mean_diff: 0.02
    psi: 0.1
    null_rate_diff: 0.01
  alert:
    channel: risk_monitor
    level: P1
五、案例场景:一次通过率异常引发的排查
某消费信贷产品上线新模型后,首周通过率从42%下降到35%,但离线评估显示通过率应保持在41%左右。团队按一致性监控流程排查:
- 数据层:发现线上某收入字段缺失率从3%上升到18%,原因是第三方数据源接口超时后返回空值。
- 特征层:离线缺失值填充为行业中位数,线上填充为0,导致收入类特征整体偏低。
- 模型层:评分分布左移,高风险客户占比上升。
- 策略层:拒绝规则触发率上升,最终通过率下降。
修复措施包括:统一缺失值填充逻辑、增加数据源超时重试与降级策略、对线上特征快照进行回刷验证。修复后通过率恢复至40.5%,评分PSI从0.23降至0.04。
常见误区:很多团队只监控模型分数,不监控特征和入参。结果是分数异常时无法判断是模型问题还是数据问题,排查周期被大幅拉长。正确做法是建立“入参—特征—分数—策略—业务”的全链路监控。
六、学习目标与整体课程框架
完成本课程后,你应当能够:
- 准确解释线上线下一致性的定义、层次与业务价值。
- 独立设计一致性监控指标、阈值与告警规则。
- 使用特征快照、评分比对、PSI/KS等工具定位偏差。
- 区分数据、特征、模型、策略四类根因并制定修复方案。
- 建立从监控到复盘再到优化的闭环治理机制。
本课程共30章,整体框架分为五个部分:
- 基础认知篇:定义、价值、核心原理与监控框架。
- 指标与工具篇:PSI、KS、评分比对、特征快照、日志采集。
- 实战排查篇:数据偏差、特征偏差、模型偏差、策略偏差的定位方法。
- 工程落地篇:监控平台设计、告警治理、自动化比对与CI/CD集成。
- 案例复盘篇:真实业务场景拆解与最佳实践沉淀。
学习建议:不要只记结论,要跟着每章的排查思路动手画链路图、写监控规则、做偏差计算。一致性监控是一门实践课,只有亲手排查过偏差,才能真正掌握。