3. 模型开发与验证流程面试题
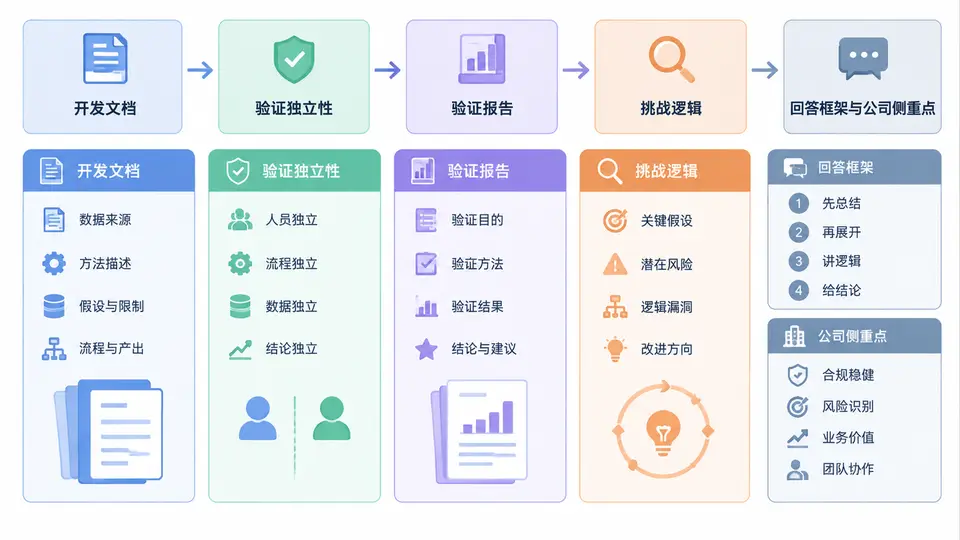
模型风险管理岗位的面试中,开发与验证流程类问题几乎是必考项。面试官并不指望你亲手训练一个大模型,而是想确认三件事:你是否理解模型全生命周期的文档留痕要求,是否清楚验证独立性的边界与落地方式,以及能否用结构化逻辑对模型假设发起有效挑战。本章围绕开发文档、验证独立性、验证报告、挑战逻辑四条主线,给出可复用的回答框架与追问应对策略。
一、开发文档:从“能跑通”到“能复现”
开发文档的核心不是写得厚,而是让第三方在不联系开发者的前提下复现模型结果。面试中常被问:“你们的模型开发文档包含哪些内容?”回答应覆盖六个模块:业务目标与使用场景、数据字典与样本筛选逻辑、特征工程与变量处理、模型算法与超参数、训练与验证结果、已知限制与假设。每个模块都要有版本号、作者、审批记录。
高频追问是“如果文档缺失关键参数怎么办”。此时应展示补救流程:先冻结当前模型版本,再通过代码仓库、日志和实验记录反向重建参数,最后由独立验证人员复核重建结果与原结果的一致性。可以这样表达:
文档完整性检查清单(示例)
1. 数据来源、时间窗口、排除规则是否写明
2. 特征变换公式与缺失值处理是否可执行
3. 随机种子、交叉验证折数、调参范围是否记录
4. 模型文件哈希与训练环境依赖是否归档
5. 审批人、审批日期、变更原因是否留痕
二、验证独立性:人、数据、结论三层隔离
验证独立性是MRM的立身之本。面试官会追问:“你和开发团队不在同一部门,就独立了吗?”答案是否定的。独立性至少包含三层:人员独立,验证人员不参与开发且绩效不受开发团队影响;数据独立,验证方有权获取原始数据并独立清洗;结论独立,验证报告不经过开发团队预审即可提交。
常见冲突场景是开发团队对验证结论有异议。此时应强调“分歧留痕”机制:验证方保留原始证据,开发方提交书面反驳,由模型治理委员会裁决,而不是私下修改报告。回答时可用“我经历过的一次分歧”作为案例,说明如何用独立复算结果推动双方回到数据本身。
三、验证报告:结论、证据、限制三段式
验证报告不是学术论文,而是决策文件。推荐结构为:结论先行、证据支撑、限制与建议收尾。结论部分明确模型是否可用、适用边界和风险等级;证据部分展示独立复算、敏感性测试、压力测试和基准对比;限制部分列出数据缺陷、假设脆弱点和监控建议。
| 报告模块 | 核心内容 | 面试常见追问 |
|---|---|---|
| 结论 | 可用性、适用范围、风险评级 | 评级标准是什么? |
| 证据 | 独立复算、敏感性、压力测试 | 复算差异多大可接受? |
| 限制 | 数据缺陷、假设脆弱点 | 如何监控这些限制? |
| 建议 | 整改项、责任人、时限 | 整改未完成能否上线? |
四、挑战逻辑:从假设出发,而非从结果出发
挑战逻辑是验证人员最核心的能力。面试中常给一个场景:“开发团队说模型AUC达到0.85,你怎么挑战?”低阶回答是质疑数据泄漏,高阶回答是从假设链条入手:业务假设是否成立、样本代表性是否充分、目标变量定义是否稳定、特征与目标是否存在因果倒置、模型在极端场景下是否失效。
建议使用“假设—证据—替代解释”三步法。例如:开发方假设“历史违约率可预测未来”,挑战点是宏观周期变化导致分布漂移;证据是跨周期回测AUC下降;替代解释是模型过度依赖某个周期性特征。最后给出可执行的验证动作,如分层回测、剔除该特征后的对比实验。
公司侧重点差异也需注意:银行系更关注监管映射与文档留痕,互联网金融更关注迭代速度与监控闭环,外资机构更关注独立验证的治理架构。面试前应研究目标公司的MRM成熟度,调整回答重心。例如面对成熟度较高的机构,多谈治理委员会与审计接口;面对快速迭代的团队,多谈自动化文档与持续验证。
最后,所有流程类回答都应落到一个具体项目上。用STAR结构简述一次你参与的开发或验证经历,说明你产出了什么文档、如何保证独立性、报告结论是什么、挑战了哪个假设。有细节的回答,永远比背诵制度更有说服力。