1. 课程导入
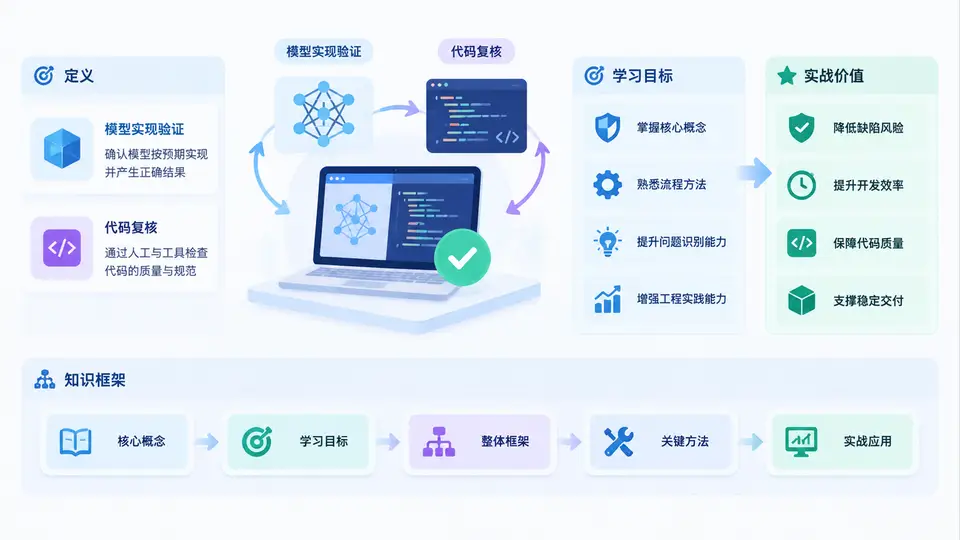
一、为什么需要“模型实现验证与代码复核”
在机器学习、深度学习以及各类统计建模项目中,模型从论文、设计文档或业务需求走向可运行代码,中间存在大量“语义损耗”。论文中的公式、伪代码、超参数描述,一旦落到具体框架与工程代码里,就可能出现维度错位、损失函数缩放错误、数据泄漏、随机种子未固定、评估指标口径不一致等问题。更棘手的是,这些问题往往不会让程序崩溃,而是让模型“看起来能跑”,却悄悄给出错误结论。
模型实现验证关注的是:代码所实现的模型,是否与设计意图、数学定义或论文描述一致。它回答“我们建的是不是我们想建的模型”。代码复核则更偏向工程审查:通过阅读、走查、测试、对照和工具检查,发现实现缺陷、边界条件遗漏、可维护性风险与复现性问题。两者结合,构成从“能运行”到“可信赖”的关键桥梁。
二、核心原理:验证与复核的四个层次
模型实现验证不是单点检查,而是分层递进的证据链。通常可划分为以下四个层次:
- 数值一致性:前向传播、损失函数、梯度是否与数学定义或参考实现一致。常用小规模输入、解析解、数值梯度对比来验证。
- 结构一致性:网络层数、张量形状、参数数量、连接关系、激活函数位置是否与设计一致。
- 训练行为一致性:损失是否按预期下降,梯度是否更新到正确参数,优化器状态是否正确,随机性是否可控。
- 评估与复现一致性:数据划分、指标计算、后处理、随机种子、环境依赖是否可复现,结论是否可被独立验证。
代码复核则围绕可读性、可测试性、边界条件、异常处理、依赖管理、性能与安全展开。它不追求“吹毛求疵”,而是用系统化清单降低漏检概率。
三、方法流程:从设计到复核的闭环
一个可落地的验证与复核流程,通常包含以下步骤:
- 建立参照物:明确论文、公式、伪代码、参考实现或业务规则,作为验证基准。
- 拆解关键单元:将模型拆为数据管道、特征工程、模型结构、损失函数、优化器、评估指标等模块。
- 设计最小验证用例:用极小张量、已知答案、边界输入验证每个单元。
- 执行代码走查:按清单检查命名、形状、设备、数据类型、随机种子、异常分支。
- 运行对照实验:与参考实现或基线模型对比输出、梯度、指标。
- 记录证据与复盘:保存日志、差异、修复记录,形成可追溯的验证报告。
# 示例:数值梯度检查的核心思路
# 对输入 x 施加微小扰动,比较解析梯度与数值梯度
eps = 1e-5
loss_plus  = compute_loss(x + eps)
loss_minus = compute_loss(x - eps)
num_grad = (loss_plus - loss_minus) / (2 * eps)
rel_err = abs(num_grad - analytic_grad) / max(1e-8, abs(num_grad) + abs(analytic_grad))
assert rel_err < 1e-4, f"梯度不一致: {rel_err}"
这段代码体现了一个重要原则:验证要尽量自动化、可重复,而不是依赖“看一眼觉得对”。
四、案例与场景:一个典型的数据泄漏复核
假设某团队在预测用户流失时,先对全量数据做了标准化,再划分训练集和测试集。模型在测试集上表现极好,但上线后效果骤降。复核发现:标准化时使用了测试集的均值和方差,导致训练阶段间接“看到”了测试分布。这就是典型的数据泄漏。
修复方式是把标准化放入训练管道,仅在训练集上拟合参数,再应用到验证集和测试集。复核清单中应明确:
| 检查项 | 常见问题 | 复核动作 |
|---|---|---|
| 数据划分 | 先增强后划分、先标准化后划分 | 确认划分发生在所有拟合操作之前 |
| 特征工程 | 使用未来信息或全局统计量 | 逐特征检查时间边界与拟合范围 |
| 模型结构 | 维度不匹配、激活函数位置错误 | 打印每层输入输出形状,对照设计文档 |
| 损失函数 | 缩放系数错误、忽略掩码 | 用小样本手算损失并与代码输出对比 |
| 评估指标 | 口径不一致、阈值选择不当 | 固定评估脚本,记录指标定义与版本 |
| 随机性 | 种子未固定、数据加载顺序不稳定 | 设置全局种子并验证多次运行结果一致 |
这个案例说明,模型实现验证与代码复核不是“额外工作”,而是避免错误结论和返工的必要投资。
五、常见误区与复盘要点
误区一:能跑通就等于正确。程序不报错只说明语法和部分形状兼容,不代表数学语义正确。
误区二:只看最终指标。指标好可能是数据泄漏、过拟合或评估错误造成的假象。
误区三:复核等于找茬。复核的目标是建立证据链和团队共识,而不是追究个人责任。
误区四:验证一次就够。代码、数据、依赖和需求都会变化,验证应随变更持续进行。
复盘时建议回答三个问题:这次验证发现了什么?为什么之前没有发现?下次用什么清单或自动化手段更早发现?把答案沉淀为团队规范,才能真正提升工程可靠性。
六、整体知识框架与实战价值
本课程后续将围绕“验证什么、怎么验证、如何复核、如何沉淀”展开。整体知识框架包括:模型结构验证、数值梯度检查、数据管道复核、训练过程监控、评估指标审计、复现性管理、代码走查清单与自动化测试。实战价值体现在四个方面:降低隐蔽缺陷导致的决策风险;提升科研结论与业务模型的可信度;缩短调试与返工周期;形成可复用、可审计的工程规范。
当你能够用证据说明“模型实现与设计一致、代码质量可控、结果可复现”,你就具备了从普通实现者走向可信赖建模工程师的关键能力。