3. 模型全生命周期总览
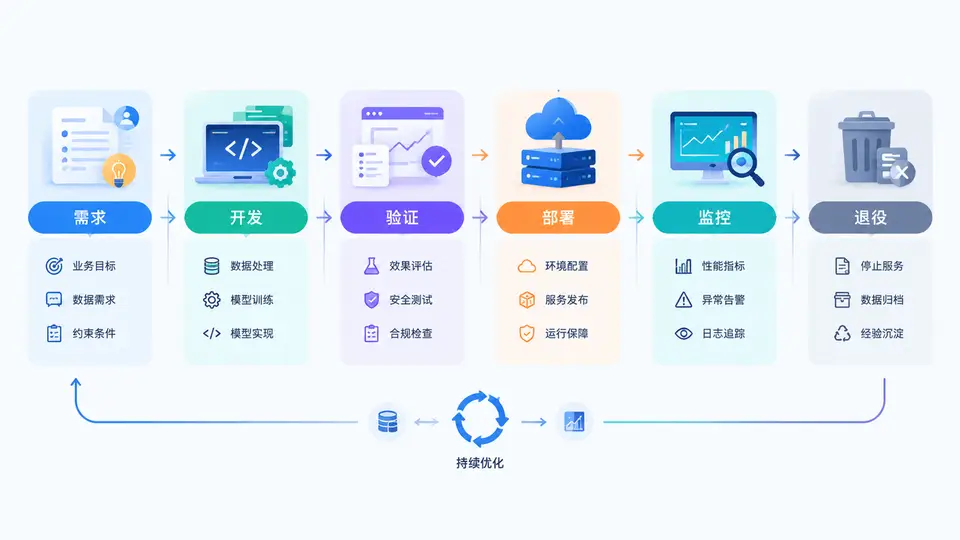
模型不是一次训练完成就结束的“项目”,而是一条持续演进的“生产线”。在金融风控、医疗辅助诊断、工业质检等场景中,一个模型从想法到退役往往跨越数月甚至数年,期间会经历需求澄清、数据准备、开发训练、验证评估、部署上线、运行监控和最终退役。若缺乏阶段划分,团队容易陷入“只关注训练精度、忽视上线后衰减”的陷阱。本节将模型全生命周期拆解为六个阶段,并给出每个阶段的核心交付物、风险控制点和常见误区。
一、核心原理:为什么必须做阶段划分
模型全生命周期的本质,是把“不确定性”逐步收敛为“可管理的工程对象”。需求阶段的不确定性最高,退役阶段最低。阶段划分带来三个直接收益:
- 责任可追溯:每个阶段有明确负责人和准入准出条件,避免“数据脏了怪算法、效果差了怪数据”的扯皮。
- 风险可分级:不同阶段的风险类型不同,需求阶段怕目标错位,开发阶段怕数据泄漏,部署阶段怕环境漂移,监控阶段怕概念漂移。
- 成本可控制:越早发现错误,修复成本越低。需求阶段改一句话,比上线后回滚一个模型便宜几个数量级。
关键认知:生命周期不是瀑布式的一次性流程,而是带反馈回路的迭代闭环。监控阶段发现的漂移,可能触发回到开发阶段重新训练;验证阶段发现的偏差,可能回到需求阶段重新定义目标。
二、方法流程:六阶段划分与交付物
下面给出一个可落地的六阶段划分。每个阶段都包含“输入—活动—输出—准出条件”四要素。
| 阶段 | 核心活动 | 关键交付物 | 准出条件 |
|---|---|---|---|
| 1. 需求定义 | 业务目标拆解、成功指标定义、约束条件梳理 | 模型需求说明书、指标基线、风险等级初判 | 业务方与技术方对指标口径签字确认 |
| 2. 数据与开发 | 数据采集、清洗、特征工程、模型训练与调参 | 训练数据集、特征字典、模型文件、实验记录 | 离线指标达到基线,数据血缘可追溯 |
| 3. 验证评估 | 离线验证、公平性检查、压力测试、对抗测试 | 验证报告、偏差分析、失败案例集 | 通过业务验收与合规审查,无严重偏差 |
| 4. 部署上线 | 模型打包、服务封装、灰度发布、回滚预案 | 推理服务、API文档、部署清单、回滚脚本 | 灰度期指标稳定,回滚演练通过 |
| 5. 运行监控 | 性能监控、数据漂移检测、业务指标追踪、告警 | 监控看板、告警规则、漂移报告、重训触发记录 | 告警闭环率达标,漂移在阈值内 |
| 6. 退役下线 | 影响评估、替代方案切换、数据归档、服务关停 | 退役申请、归档记录、切换验证报告 | 无业务依赖,归档完整,审计通过 |
在实际工程中,阶段之间并非严格串行。例如,监控阶段发现数据漂移后,会触发“重训”流程,重新进入开发与验证阶段。因此,更准确的描述是“阶段划分 + 反馈回路”。
三、案例/场景:一个信贷评分模型的完整旅程
假设某银行要构建一个信贷评分模型,用于判断小微企业贷款申请人的违约概率。我们按六阶段走一遍:
- 需求定义:业务目标是“在通过率不低于60%的前提下,将坏账率控制在3%以内”。风险等级初判为“高”,因为涉及资金和合规。成功指标定为AUC≥0.75、KS≥0.30。
- 数据与开发:采集近三年贷款记录、企业工商信息、法人征信数据。清洗后发现缺失率超过40%的特征有12个,决定剔除。训练逻辑回归和XGBoost两个基线,XGBoost离线AUC达到0.79。
- 验证评估:做时间外样本验证,AUC降至0.74,接近阈值。进一步做公平性检查,发现对“成立年限少于2年”的企业通过率显著偏低。业务方决定调整阈值并补充替代数据。
- 部署上线:将模型封装为REST API,先对10%流量灰度。灰度期监控发现响应延迟P99为320ms,超过200ms的SLA,于是增加缓存层并优化特征计算。
- 运行监控:上线三个月后,监控看板显示“近30天申请企业平均成立年限”从4.2年降至2.8年,触发数据漂移告警。同时KS从0.30降至0.22,触发重训流程。
- 退役下线:两年后,银行引入新的联合建模方案,旧模型被替代。团队完成影响评估,确认无下游系统依赖,将模型文件和训练数据归档,关停API服务。
场景启示:这个案例中,真正决定模型成败的不是训练阶段的AUC,而是验证阶段的公平性检查和监控阶段的漂移告警。生命周期管理的价值,在于让每个阶段的风险都被“看见”并“接住”。
四、误区与复盘:阶段划分中最容易踩的坑
即使团队接受了生命周期理念,实践中仍常见以下误区:
- 误区一:需求阶段跳过风险分级。很多团队直接进入开发,导致高风险的医疗模型和低风险的推荐模型用同一套验证标准,要么过度审查拖慢进度,要么审查不足埋下合规隐患。
- 误区二:验证阶段只看离线指标。离线AUC高不代表线上效果好。必须做时间外验证、跨群体验证和压力测试,否则上线后容易“见光死”。
- 误区三:部署后没有回滚预案。灰度发布不是“发完再看”,而是“发完能退”。没有回滚脚本和演练,一旦出问题就是事故。
- 误区四:监控只看模型指标,不看业务指标。模型KS正常,但业务坏账率上升,说明模型与业务目标脱节。监控必须同时覆盖技术指标和业务指标。
- 误区五:退役阶段直接删模型。退役不等于删除。需要评估下游依赖、归档训练数据和配置、保留审计记录,否则未来无法复现或解释历史决策。
复盘要点:生命周期管理的核心不是“走完流程”,而是“在每个阶段留下可审计的证据”。需求阶段的签字、开发阶段的实验记录、验证阶段的偏差报告、部署阶段的回滚脚本、监控阶段的告警日志、退役阶段的归档清单,这些才是模型治理的真正资产。
最后,用一段伪代码概括生命周期各阶段的准入检查逻辑,帮助你在工程中落地:
def lifecycle_gate(stage, artifacts):
    if stage == "需求定义":
        assert artifacts.get("指标基线") is not None
        assert artifacts.get("风险等级") in ["低", "中", "高"]
    elif stage == "数据与开发":
        assert artifacts.get("数据血缘") is not None
        assert artifacts.get("离线指标") >= artifacts.get("基线")
    elif stage == "验证评估":
        assert artifacts.get("偏差报告") is not None
        assert artifacts.get("合规审查") == "通过"
    elif stage == "部署上线":
        assert artifacts.get("回滚脚本") is not None
        assert artifacts.get("灰度指标") == "稳定"
    elif stage == "运行监控":
        assert artifacts.get("告警闭环率") >= 0.95
        assert artifacts.get("漂移阈值") == "正常"
    elif stage == "退役下线":
        assert artifacts.get("归档记录") is not None
        assert artifacts.get("下游依赖") == "无"
    return "准出通过"