3. 策略监控体系设计
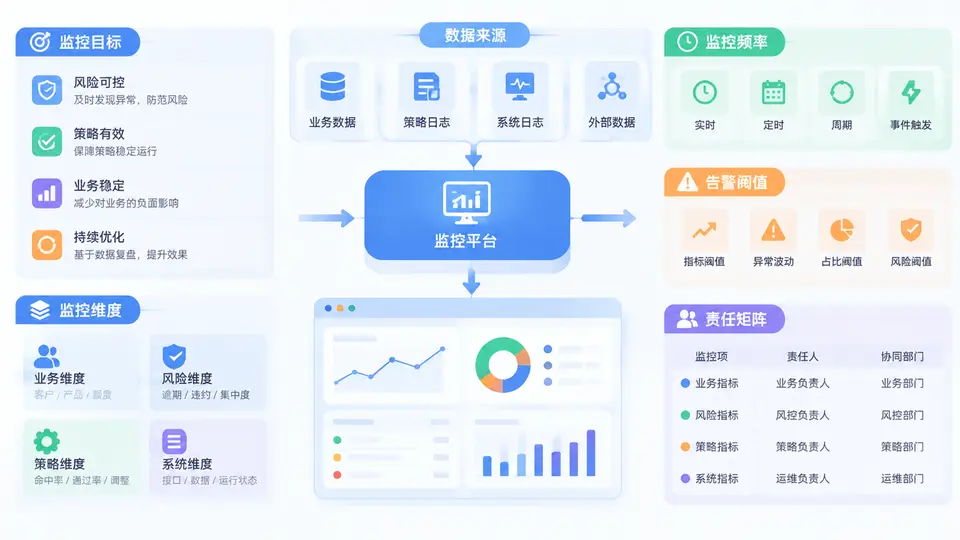
授信策略上线之后,真正决定其能否持续创造价值的,不是策略本身有多精巧,而是能否在运行过程中被稳定地“看见”。策略监控体系就是这套“看见”的机制。它要回答五个问题:为什么监控、监控什么、多久看一次、什么情况算异常、异常之后谁来处理。这五个问题分别对应监控目标、监控维度、监控频率、告警阈值与责任矩阵。本节将围绕这五个要素,给出一套可落地的搭建方法。
一、核心原理:监控体系是策略的“闭环传感器”
策略监控不是简单的报表堆砌,而是策略生命周期中的反馈回路。一个完整的反馈回路包含四个环节:采集(把策略运行数据沉淀下来)、比对(与预期、基线或历史对比)、判定(是否触发告警)、响应(由责任人采取动作)。缺少任何一环,监控都会退化为“只看不动”的摆设。
因此,监控体系设计的第一原则是以终为始:先明确监控目标,再倒推需要哪些维度、频率和阈值。第二原则是分层设计:把监控分为“策略级、组合级、资产级”三层,避免所有指标挤在一张表里。第三原则是责任到人:每个告警都必须有明确的响应人和响应时限,否则告警就是噪音。
二、方法流程:五步搭建监控体系
下面给出一套从零搭建监控体系的五步流程,适用于新策略上线或存量策略重构。
- 第一步:定义监控目标。目标要具体、可衡量。常见目标包括:验证策略是否按预期运行、及时发现风险异动、评估策略对业务指标的影响、满足监管与审计要求。目标不同,监控重点完全不同。
- 第二步:选择监控维度。维度要覆盖“风险、业务、客群、策略执行”四类。风险维度看逾期、坏账、迁徙率;业务维度看通过率、授信额度、放款量;客群维度看分层表现;策略执行维度看规则命中率、拒绝原因分布。
- 第三步:确定监控频率。频率由“指标变化速度”和“决策时效要求”共同决定。高频指标(如申请量、通过率)按日监控;中频指标(如逾期率、迁徙率)按周或按月监控;低频指标(如模型稳定性PSI)按月或按季监控。
- 第四步:设定告警阈值。阈值不能拍脑袋,要基于历史基线、业务容忍度和统计波动来设定。常用方法包括:固定阈值、同比/环比波动阈值、控制图阈值、分位数阈值。
- 第五步:建立责任矩阵。用RACI模型明确每个监控项的负责人、执行人、被咨询人和知会人,并规定响应时限和升级路径。
三、监控维度与频率的对应关系
监控维度与频率不是随意组合的,而是由指标的“波动特性”和“业务影响”共同决定。下表给出一个典型的对应关系清单,可作为设计模板。
| 监控层级 | 典型指标 | 建议频率 | 主要用途 |
|---|---|---|---|
| 策略级 | 规则命中率、拒绝率、通过率、拒绝原因分布 | 日 | 验证策略执行是否符合设计 |
| 策略级 | 评分分布、PSI、KS | 周/月 | 监控模型与策略稳定性 |
| 组合级 | 放款量、授信额度使用率、平均额度 | 日/周 | 评估业务规模与结构变化 |
| 组合级 | 逾期率、迁徙率、坏账率 | 周/月 | 监控资产质量与风险趋势 |
| 客群级 | 分层通过率、分层逾期率、新老客表现 | 月 | 识别客群结构漂移 |
| 资产级 | Vintage、滚动率、回收率 | 月/季 | 评估长期资产表现与策略效果 |
四、告警阈值设定与责任矩阵
阈值设定是监控体系中最容易出问题的环节。常见做法有三种:固定阈值(如通过率低于60%告警)、波动阈值(如环比波动超过20%告警)、统计阈值(如超出均值±3倍标准差告警)。实际应用中建议组合使用:固定阈值守住底线,波动阈值捕捉异动,统计阈值发现隐性漂移。
# 告警阈值配置示例(YAML)
monitor:
  - name: approval_rate_daily
    metric: approval_rate
    frequency: daily
    threshold:
      fixed: 0.60          # 低于60%触发
      wow_change: 0.20     # 周环比波动超过20%触发
      std_dev: 3           # 超出3倍标准差触发
    severity: high
    owner: risk_strategy_team
    response_sla: 4h
    escalate_to: risk_committee

  - name: psi_weekly
    metric: psi_score
    frequency: weekly
    threshold:
      fixed: 0.25          # PSI超过0.25触发
    severity: medium
    owner: model_team
    response_sla: 24h
    escalate_to: risk_strategy_team
责任矩阵建议采用RACI模型,并明确响应时限与升级路径。以下是一个简化的责任矩阵清单:
- 策略执行类告警:负责人为策略运营岗,执行人为监控值班岗,被咨询人为策略设计岗,知会人为风险经理;响应时限4小时。
- 模型稳定性告警:负责人为模型团队,执行人为模型监控岗,被咨询人为策略团队,知会人为风险委员会;响应时限24小时。
- 资产质量类告警:负责人为风险策略团队,执行人为资产监控岗,被咨询人为业务团队,知会人为高管层;响应时限8小时。
- 合规与审计类告警:负责人为合规岗,执行人为审计对接岗,被咨询人为法务,知会人为风险委员会;响应时限立即。
五、案例场景:一次通过率异常告警的完整处理
某消费信贷策略上线后,日监控发现通过率从72%骤降至58%,触发固定阈值告警。值班岗在4小时内完成初步排查,发现是某条规则命中率异常升高。进一步分析发现,该规则依赖的一个外部数据源当天返回了大量空值,导致规则误拒。策略团队随即启动应急预案,临时调整规则逻辑并重新上线,同时知会模型团队评估对评分的影响。整个处理过程在8小时内完成,未对业务造成显著影响。
这个案例说明:监控体系的价值不在于发现异常,而在于让异常被快速定位和闭环处理。如果当时没有明确的告警阈值和责任矩阵,这次异常可能演变为持续数天的业务损失。
六、复盘与迭代:让监控体系自身也“被监控”
监控体系不是一次搭建就一劳永逸的。建议每季度对监控体系本身做一次复盘,重点检查四件事:告警准确率(有多少告警是真实有效的)、响应及时率(有多少告警在规定时限内被处理)、阈值适配性(阈值是否仍符合当前业务基线)、覆盖完整性(是否有新的策略或客群未被监控覆盖)。
复盘后要形成明确的迭代动作:调整阈值、增删指标、优化频率、更新责任矩阵。只有让监控体系自身也进入“监控—复盘—迭代”的循环,它才能持续支撑授信策略的稳定运行和版本审计的可追溯性。