1. 课程导入
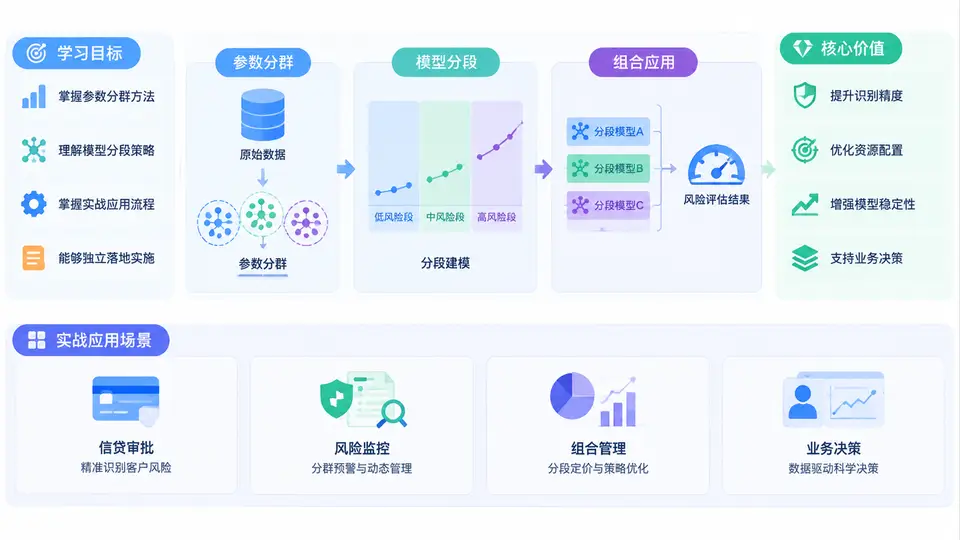
欢迎进入《信用风险参数分群与模型分段策略实战》。在信用风险管理体系中,无论是零售信贷、小微企业授信,还是对公客户评级,参数估计与模型开发从来不是"一套模型打天下"的过程。真正决定模型区分能力、稳定性与业务可用性的,往往不是算法本身,而是是否在正确的粒度上做了分群,是否在正确的逻辑上做了分段。本课程围绕这一核心命题展开,帮助你把"分群"与"分段"从经验判断升级为可复用、可验证、可落地的工程方法。
一、学习目标:从"会建模"到"会分群分段"
本课程的学习目标分为四个层次,逐层递进:
- 认知层:理解信用风险参数(PD、LGD、EAD、CCF)与模型分段之间的内在关系,明确分群不是数据预处理,而是风险区分能力的结构性来源。
- 方法层:掌握分群变量筛选、分群边界确定、分段模型开发、分段一致性检验的完整方法链路。
- 工具层:能够使用Python/SQL完成分群特征构造、分段样本切分、分段模型训练与跨段对比评估。
- 业务层:能够将分群分段结果转化为授信政策、定价策略、额度管理与贷后监控的具体动作。
核心判断标准:一个好的分群方案,应当让"段内差异最小化、段间差异最大化",并且每一段都具备独立的业务解释与稳定的样本支撑。
二、核心价值:为什么分群分段决定模型成败
很多团队在模型开发中遇到这样的困境:全样本AUC尚可,但落到某个客群或某个产品线时,模型排序能力明显下降;或者模型上线后KS快速衰减,排查发现是某类客户的行为模式发生了结构性变化。这些问题的根源,通常不是算法不够复杂,而是把异质性极强的样本强行塞进同一个模型。
分群与分段的核心价值体现在三个方面:
- 提升区分能力:将风险驱动因素差异显著的客群分开建模,避免"平均化"导致的排序失真。
- 增强可解释性:每一段对应明确的业务场景与风险逻辑,便于向业务方、监管方解释模型结果。
- 保障稳定性:分段后单段样本更同质,模型对客群结构变化的敏感度降低,衰减更可控。
下表概括了"不分群"与"科学分群"在关键维度上的差异:
| 对比维度 | 不分群/粗放分群 | 科学分群分段 |
|---|---|---|
| 样本同质性 | 低,异质样本混杂 | 高,段内风险逻辑一致 |
| 模型区分能力 | 全样本尚可,局部失效 | 各段均保持稳定排序能力 |
| 业务解释性 | 弱,难以对应具体策略 | 强,可直接映射授信政策 |
| 监控与迭代 | 整体监控,问题定位难 | 分段监控,问题定位快 |
| 监管沟通 | 解释成本高 | 逻辑清晰,易通过验证 |
三、整体课程框架:30章的能力地图
本课程共30章,按照"认知—方法—工具—实战—复盘"的主线组织,整体框架如下:
- 导入与基础(第1–4章):学习目标、核心概念、参数体系、分群分段在风控全流程中的位置。
- 分群方法论(第5–12章):分群变量体系、统计分群、业务分群、组合分群、边界确定与稳定性检验。
- 分段建模策略(第13–20章):分段模型开发、跨段一致性、样本不足处理、迁移学习与冷启动。
- 工具与工程化(第21–25章):Python/SQL实现、自动化分群流水线、模型监控与迭代机制。
- 实战与复盘(第26–30章):零售、小微、对公场景案例,常见误区与复盘方法。
建议学习路径:先建立"分群是风险结构识别"的认知,再掌握统计与业务结合的分群方法,最后通过实战案例固化工程能力。不要跳过方法论直接套用代码。
四、实战应用场景:分群分段在哪里产生价值
分群与分段策略并非抽象概念,它直接对应以下高频业务场景:
- 零售信贷申请评分:按客群来源(线上/线下)、产品类型(信用卡/消费贷/现金贷)分段建模,避免不同获客渠道风险混叠。
- 行为评分与额度管理:按账龄、活跃度、还款行为分群,实现差异化提额与降额策略。
- 小微企业授信:按行业、区域、经营年限、纳税等级分段,解决小微样本稀疏与风险异质问题。
- 对公客户评级:按行业周期性与企业规模分段,提升评级结果的行业可比性。
- 贷后预警与催收:按逾期阶段与客户响应特征分群,优化催收资源分配。
以零售信贷为例,一个典型的分段建模流程可以用如下伪代码表达:
# 分段建模核心流程示意
segments = define_segments(
    data,
    rules=[
        ("new_customer", "apply_channel == 'online' and tenure == 0"),
        ("active_customer", "tenure >= 6 and active_flag == 1"),
        ("dormant_customer", "tenure >= 6 and active_flag == 0")
    ]
)

for seg_name, seg_data in segments.items():
    model = train_model(seg_data, target="default_12m")
    evaluate(model, metrics=["AUC", "KS", "PSI"])
    save_model(model, path=f"models/{seg_name}_pd.pkl")
这段流程的关键不在于代码本身,而在于分段规则的设计是否来自业务逻辑与数据验证的双重支撑。规则拍脑袋,模型再精细也难以稳定。
五、常见误区与学习提醒
误区一:为了分群而分群。分群不是越细越好,段内样本不足会导致模型过拟合,段间差异不显著则分群无意义。
误区二:只看统计指标,忽略业务解释。统计上显著但业务上无法解释的分群,上线后往往难以维护。
误区三:分群后不做一致性检验。各段模型若在重叠区域给出矛盾结论,会引发策略冲突。
误区四:一次分群长期使用。客群结构会变化,分群方案需要定期回溯与迭代。
误区二:只看统计指标,忽略业务解释。统计上显著但业务上无法解释的分群,上线后往往难以维护。
误区三:分群后不做一致性检验。各段模型若在重叠区域给出矛盾结论,会引发策略冲突。
误区四:一次分群长期使用。客群结构会变化,分群方案需要定期回溯与迭代。
本课程后续章节将围绕这些误区逐一展开,给出可操作的检验方法与迭代机制。你在学习过程中,应始终带着三个问题:这段样本为什么应该放在一起?这段之间的差异是否足够大且稳定?这段结果能否转化为具体业务动作?能回答这三个问题,分群分段才算真正落地。
接下来,我们将从信用风险参数体系与分群分段的基本概念开始,逐步构建完整的方法论与实战能力。