3. 原始申请数据加载与初步探查
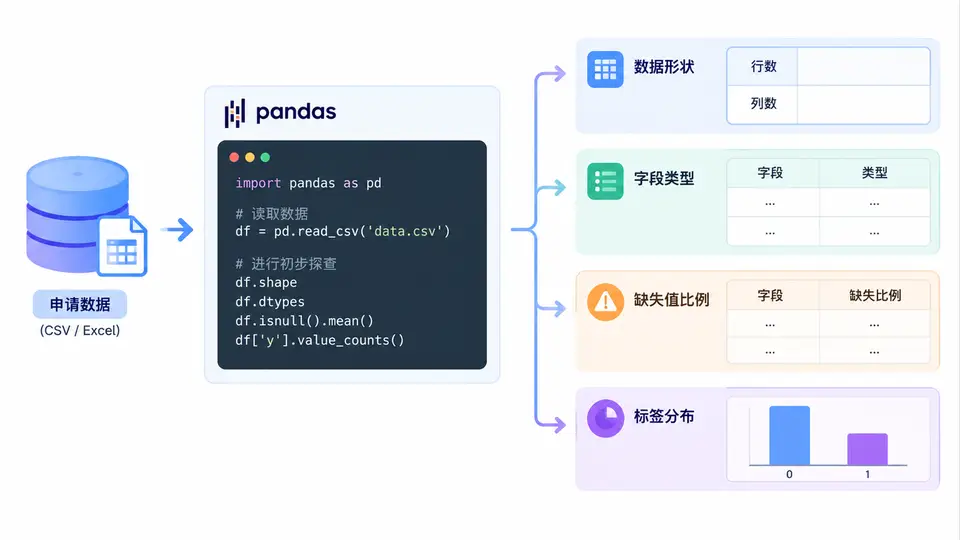
任务说明
本案例用 pandas 读取一份申请数据 CSV,完成四件事:查看数据形状、字段类型、各字段缺失值比例、标签分布。这是评分卡建模前的第一步探查,用于确认数据规模、字段可用性和正负样本是否失衡。
环境与数据
依赖:Python 3.8+、pandas。安装命令:
pip install pandas数据文件 application.csv 放在脚本同目录,含字段:id、age、income、education、label。其中 label 为标签列(1 表示违约,0 表示正常),income 与 education 故意留有空值以演示缺失值统计。
完整代码
import pandas as pd

DATA_PATH = "application.csv"
LABEL_COL = "label"

def load_data(path):
    """读取申请数据,返回 DataFrame。"""
    return pd.read_csv(path)

def explore(df, label_col):
    """输出形状、字段类型、缺失值比例、标签分布。"""
    print("=== 数据形状 ===")
    print(f"行数: {df.shape[0]}, 列数: {df.shape[1]}")

    print("\n=== 字段类型 ===")
    print(df.dtypes)

    print("\n=== 缺失值比例 ===")
    missing_ratio = df.isnull().mean().sort_values(ascending=False)
    print((missing_ratio * 100).round(2).astype(str) + " %")

    print("\n=== 标签分布 ===")
    counts = df[label_col].value_counts().sort_index()
    ratio = df[label_col].value_counts(normalize=True).sort_index()
    dist = pd.DataFrame({"count": counts, "ratio": (ratio * 100).round(2)})
    print(dist)

if __name__ == "__main__":
    df = load_data(DATA_PATH)
    explore(df, LABEL_COL)
运行方式
python explore.py验证方法与通过条件
运行后应依次看到四段输出:
- 数据形状:行数与列数与 CSV 实际一致;
- 字段类型:
id、age、income为数值型,education为 object,label为整数型; - 缺失值比例:
income、education比例大于 0,其余为 0; - 标签分布:同时给出 0/1 的样本数与占比,两者占比之和为 100%。
若四段输出齐全且数值与数据文件一致,即判定通过。若某字段缺失比例异常高(如超过 50%),需在后续建模中重点处理。