3. 数据清洗与特征工程面试题
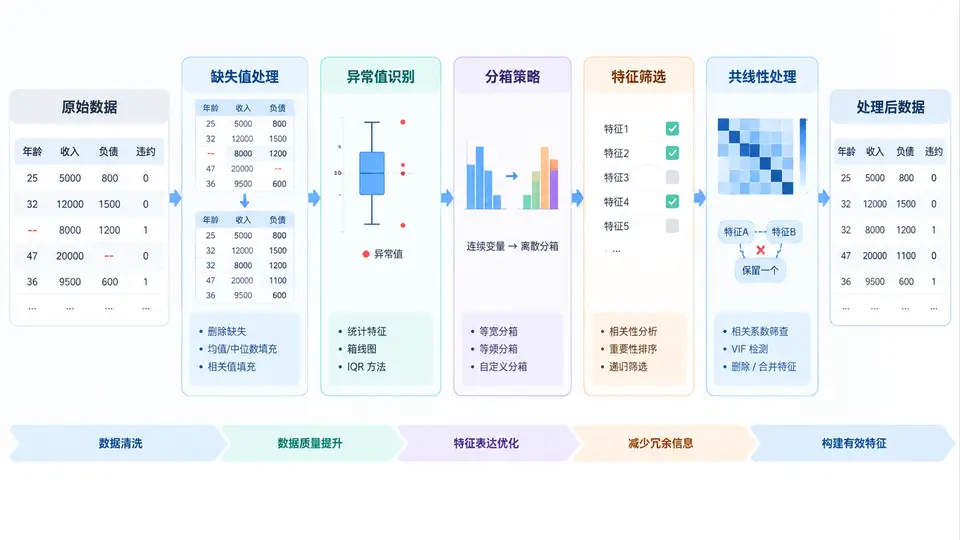
在信贷风控建模面试中,数据清洗与特征工程往往比模型选择更能体现候选人的实战功底。面试官真正想确认的不是你“知道多少种方法”,而是你能否在业务约束、样本规模、可解释性与上线稳定性之间做出合理取舍。本章围绕五类高频问题,给出可复用的回答框架与追问应对路径。
一、核心原理:特征工程是业务假设的代码化
缺失值、异常值、分箱、筛选与共线性,本质上都在回答同一个问题:如何把原始数据转化为稳定、可解释、可上线的风险信号。面试中不要孤立地背方法,而要把它放进“业务假设—数据验证—模型验证—上线监控”的闭环里。
- 缺失值:先判断缺失机制(完全随机、随机、非随机),再决定删除、填充或保留缺失标志。信贷场景中,缺失本身常是风险信号。
- 异常值:区分“错误值”与“真实极端值”。错误值修正或剔除,真实极端值可截断、分箱或单独建模。
- 分箱:把连续变量离散化,提升稳定性与可解释性,同时处理非线性关系。常用等频、等距、卡方、决策树分箱。
- 特征筛选:从业务、统计、模型三个维度筛选,兼顾IV、PSI、相关性、VIF与业务可解释性。
- 共线性:共线性不影响树模型预测,但影响逻辑回归系数解释与稳定性,需通过VIF、相关性矩阵识别并处理。
面试表达要点:先给结论,再给依据,最后给验证。例如“我优先保留缺失标志,因为缺失率与逾期率呈单调关系,IV提升约0.02,且上线后PSI稳定”。
二、方法流程:五步走的标准回答
- 数据诊断:统计缺失率、异常比例、分布、IV与PSI,形成数据质量报告。
- 缺失处理:缺失率低于5%可填充;5%~30%考虑填充加缺失标志;高于30%谨慎保留或单独分析。
- 异常处理:用箱线图、3σ、分位数、业务规则识别,结合业务判断修正或截断。
- 分箱与编码:优先卡方或决策树分箱,保证单调性;WOE编码后检查IV与PSI。
- 筛选与共线性:先业务筛选,再统计筛选,最后模型筛选;VIF大于5或10时处理共线性。
| 环节 | 常用方法 | 关键指标 | 面试追问 |
|---|---|---|---|
| 缺失值 | 删除、均值/中位数/众数、模型填充、缺失标志 | 缺失率、IV、PSI | 缺失是随机还是非随机? |
| 异常值 | 3σ、IQR、分位数、业务规则 | 异常比例、截断前后分布 | 极端值是错误还是真实风险? |
| 分箱 | 等频、等距、卡方、决策树 | 单调性、IV、WOE | 为什么不用等距? |
| 筛选 | IV、相关性、RFE、L1、业务规则 | IV、AUC、KS | 如何避免过拟合? |
| 共线性 | 相关性矩阵、VIF、PCA | VIF、系数稳定性 | 树模型需要处理吗? |
三、案例/场景:一个消费贷评分卡项目
假设你在某消费金融公司做申请评分卡,样本100万,坏样本率4%。发现“月收入”缺失率18%,“年龄”存在999异常值,“近6个月查询次数”与“近3个月查询次数”高度相关。
处理策略:
1. 月收入:缺失标志 + 中位数填充,缺失标志IV=0.03,保留。
2. 年龄:999修正为缺失,按业务规则截断至[18,70]。
3. 查询次数:保留近3个月,删除近6个月,VIF从8.2降至2.1。
4. 分箱:对收入使用决策树分箱,保证坏样本率单调。
5. 验证:AUC从0.72提升至0.76,KS从0.28提升至0.34,PSI小于0.1。
这个案例的加分点在于:每一步都有量化依据,并且说明了上线后的稳定性验证。面试官追问“为什么保留缺失标志”时,你可以回答:缺失人群的坏样本率显著高于非缺失人群,缺失本身携带风险信息。
回答模板:背景—问题—方案—验证—上线监控。用STAR结构讲项目,用数据讲效果,用业务讲取舍。
四、误区与复盘:面试中常见的失分点
- 只讲方法不讲场景:一上来就说用均值填充,却不判断缺失机制。
- 忽视业务可解释性:为了提升AUC引入大量黑箱特征,导致评分卡无法解释。
- 分箱后不检查单调性:WOE不单调会削弱模型稳定性与业务信任。
- 共线性一刀切:树模型对共线性不敏感,但仍需关注特征重要性的稳定性。
- 缺少上线监控:没有PSI、缺失率、异常率监控,模型衰减后无法及时预警。
复盘建议:每次面试后记录被追问的问题,尤其是“为什么这样做”和“如果数据变了怎么办”。把答案整理成可复用的决策树,而不是零散知识点。
总结来看,这一章的面试题看似分散,实则围绕一条主线:用业务假设驱动数据处理,用统计指标验证处理效果,用上线监控保证长期稳定。掌握这条主线,你就能在面试中从“会做题”升级为“能落地”。