1. 行为克隆入门
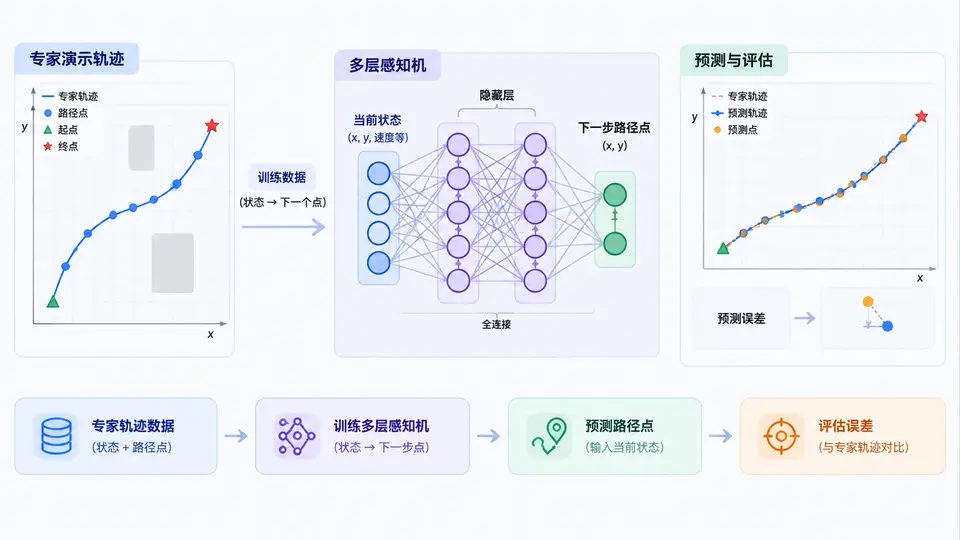
任务说明
本案例将训练一个行为克隆(Behavior Cloning)神经网络,输入为车辆前方道路的俯视图像,输出为转向角,使车辆能够在直线道路上稳定跟随路径。核心目标是:用专家驾驶数据训练模型,使模型在未见过的直线道路图像上预测出正确的转向角(接近0°)。
环境依赖
- Python 3.8+
- PyTorch 2.0+
- OpenCV (cv2)
- NumPy
数据准备
使用模拟器(如Udacity自驾驶模拟器)采集直线道路驾驶数据。每帧保存一张前方摄像头图像(160×80 RGB)和对应的转向角。直线路段转向角接近0,但包含微小修正。将数据按8:2划分为训练集和验证集。以下代码假设数据已按此格式组织:
data/
  train/
    images/   # 0001.jpg, 0002.jpg, ...
    labels.npy  # shape (N,), 转向角单位弧度
  val/
    images/
    labels.npy
完整实现代码
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import Dataset, DataLoader
import cv2
import numpy as np
import os
from glob import glob

# ---------- 数据集 ----------
class DrivingDataset(Dataset):
    def __init__(self, img_dir, label_path):
        self.img_paths = sorted(glob(os.path.join(img_dir, "*.jpg")))
        self.labels = np.load(label_path)
        assert len(self.img_paths) == len(self.labels)

    def __len__(self):
        return len(self.img_paths)

    def __getitem__(self, idx):
        img = cv2.imread(self.img_paths[idx])
        img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
        img = cv2.resize(img, (160, 80))
        img = img.astype(np.float32) / 255.0
        img = img.transpose(2, 0, 1)  # (C, H, W)
        label = np.float32(self.labels[idx])
        return torch.tensor(img), torch.tensor(label)

# ---------- 行为克隆模型 ----------
class BehaviorCloningNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 24, kernel_size=5, stride=2),
            nn.ReLU(),
            nn.Conv2d(24, 32, kernel_size=5, stride=2),
            nn.ReLU(),
            nn.Conv2d(32, 48, kernel_size=5, stride=2),
            nn.ReLU(),
            nn.Conv2d(48, 64, kernel_size=3, stride=1),
            nn.ReLU(),
            nn.Conv2d(64, 64, kernel_size=3, stride=1),
            nn.ReLU(),
        )
        self.classifier = nn.Sequential(
            nn.Flatten(),
            nn.Linear(64 * 4 * 4, 100),
            nn.ReLU(),
            nn.Linear(100, 50),
            nn.ReLU(),
            nn.Linear(50, 1),
        )

    def forward(self, x):
        return self.classifier(self.features(x))

# ---------- 训练与验证 ----------
def train(model, train_loader, val_loader, epochs=20, lr=1e-3):
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    model.to(device)
    criterion = nn.MSELoss()
    optimizer = optim.Adam(model.parameters(), lr=lr)

    for epoch in range(epochs):
        model.train()
        train_loss = 0.0
        for imgs, labels in train_loader:
            imgs, labels = imgs.to(device), labels.to(device)
            optimizer.zero_grad()
            outputs = model(imgs).squeeze()
            loss = criterion(outputs, labels)
            loss.backward()
            optimizer.step()
            train_loss += loss.item() * imgs.size(0)
        train_loss /= len(train_loader.dataset)

        # 验证
        model.eval()
        val_loss = 0.0
        with torch.no_grad():
            for imgs, labels in val_loader:
                imgs, labels = imgs.to(device), labels.to(device)
                outputs = model(imgs).squeeze()
                loss = criterion(outputs, labels)
                val_loss += loss.item() * imgs.size(0)
        val_loss /= len(val_loader.dataset)
        print(f"Epoch {epoch+1}/{epochs} | Train Loss: {train_loss:.6f} | Val Loss: {val_loss:.6f}")

    return model

# ---------- 主程序 ----------
if __name__ == "__main__":
    BATCH_SIZE = 64
    EPOCHS = 20

    train_dataset = DrivingDataset("data/train/images", "data/train/labels.npy")
    val_dataset = DrivingDataset("data/val/images", "data/val/labels.npy")
    train_loader = DataLoader(train_dataset, batch_size=BATCH_SIZE, shuffle=True)
    val_loader = DataLoader(val_dataset, batch_size=BATCH_SIZE, shuffle=False)

    model = BehaviorCloningNet()
    trained_model = train(model, train_loader, val_loader, epochs=EPOCHS)

    # 保存模型
    torch.save(trained_model.state_dict(), "behavior_cloning_model.pth")
    print("模型已保存至 behavior_cloning_model.pth")
运行方式
# 1. 安装依赖
pip install torch torchvision opencv-python numpy

# 2. 准备数据(按上述目录结构放置)

# 3. 训练模型
python train_bc.py
验证方法与通过标准
训练过程中观察验证集MSE损失。通过标准:
- 验证集MSE损失收敛至 0.01以下(对应转向角均方误差约0.1弧度≈5.7°以内);
- 训练完成后,加载模型对验证集图像进行预测,预测转向角应集中在-0.1~0.1弧度区间内,且与真实标签的误差不超过0.15弧度。
若验证损失持续高于0.01,可增加训练轮次至50或增大模型容量;若出现过拟合(训练损失远低于验证损失),可增加数据量或添加Dropout层。
常见问题
- 图像尺寸不匹配:确保输入图像resize为160×80,否则模型前向传播会报错。
- 标签单位:转向角必须使用弧度制,若数据为角度需先转换(角度×π/180)。
- 数据量不足:建议至少采集5000张以上直线道路图像,否则模型难以收敛。