3. 动态量化全连接层实战
任务目标
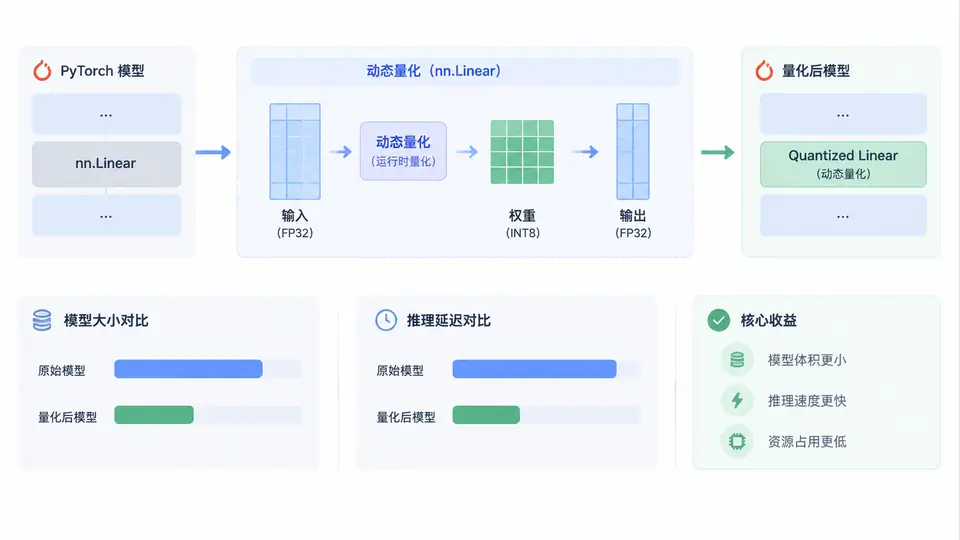
对基于LSTM的语言模型应用PyTorch动态量化,量化仅影响权重(int8),激活仍以float32计算。完成后对比量化前后模型文件大小与CPU上的推理耗时。
环境依赖
Python 3.8+,PyTorch 1.8+(推荐2.x),torchtext仅用于获取内置数据集(若网络受限可替换为任意文本序列数据)。
完整实现
import torch
import torch.nn as nn
import time
from torch.utils.data import DataLoader, Dataset

# ---------- 1. 定义LSTM语言模型 ----------
class LSTMLanguageModel(nn.Module):
    def __init__(self, vocab_size=5000, embed_dim=128, hidden_dim=256, num_layers=2):
        super().__init__()
        self.embedding = nn.Embedding(vocab_size, embed_dim)
        self.lstm = nn.LSTM(embed_dim, hidden_dim, num_layers, batch_first=True)
        self.fc = nn.Linear(hidden_dim, vocab_size)

    def forward(self, x):
        emb = self.embedding(x)
        out, _ = self.lstm(emb)
        return self.fc(out)

# ---------- 2. 构造最小可复现数据集 ----------
class SequenceDataset(Dataset):
    def __init__(self, num_samples=200, seq_len=20, vocab_size=5000):
        self.data = torch.randint(1, vocab_size, (num_samples, seq_len))
        self.target = torch.randint(1, vocab_size, (num_samples, seq_len))

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        return self.data[idx], self.target[idx]

# ---------- 3. 初始化模型并执行动态量化 ----------
torch.manual_seed(42)
model = LSTMLanguageModel()
model.eval()

quantized_model = torch.quantization.quantize_dynamic(
    model, {nn.LSTM, nn.Linear}, dtype=torch.qint8
)

# ---------- 4. 模型大小对比 ----------
import os

def get_model_size_mb(m):
    torch.save(m.state_dict(), "tmp.pth")
    size = os.path.getsize("tmp.pth") / 1e6
    os.remove("tmp.pth")
    return size

orig_size = get_model_size_mb(model)
quant_size = get_model_size_mb(quantized_model)
print(f"原始模型大小: {orig_size:.3f} MB")
print(f"动态量化模型大小: {quant_size:.3f} MB")
print(f"压缩比: {orig_size / quant_size:.2f}x")

# ---------- 5. CPU推理速度对比 ----------
dataset = SequenceDataset(num_samples=50, seq_len=20)
dataloader = DataLoader(dataset, batch_size=8)

def benchmark(model, dataloader, num_runs=5):
    model.eval()
    # 预热
    for data, _ in dataloader:
        with torch.no_grad():
            _ = model(data)
        break
    times = []
    with torch.no_grad():
        for _ in range(num_runs):
            start = time.perf_counter()
            for data, _ in dataloader:
                _ = model(data)
            times.append(time.perf_counter() - start)
    return sum(times) / len(times)

# 强制CPU执行
orig_time = benchmark(model.to("cpu"), dataloader)
quant_time = benchmark(quantized_model.to("cpu"), dataloader)
print(f"原始模型平均推理耗时: {orig_time*1000:.2f} ms")
print(f"量化模型平均推理耗时: {quant_time*1000:.2f} ms")
print(f"加速比: {orig_time / quant_time:.2f}x")

# ---------- 6. 输出正确性验证 ----------
with torch.no_grad():
    sample_data, _ = next(iter(dataloader))
    orig_out = model(sample_data)
    quant_out = quantized_model(sample_data)
    max_diff = (orig_out - quant_out).abs().max().item()
print(f"量化前后输出最大误差: {max_diff:.4f}")
运行方式
python dynamic_quantization_lstm.py验证方法与判定标准
- 模型大小:量化后state_dict文件应显著小于原始模型,压缩比通常在2~4倍之间(取决于LSTM与Linear层占比)。
- 推理速度:在CPU上量化模型推理耗时通常低于原始模型,加速比受batch size、序列长度和线程数影响,一般可达1.2~3倍。
- 输出正确性:量化前后输出最大误差应小于0.1(相对量级),若误差过大说明量化敏感层需要特殊处理。
关键说明
- 动态量化仅对
nn.LSTM和nn.Linear的权重进行int8量化,Embedding层保持不变。 - 量化后模型需调用
.eval()模式进行推理,不支持训练。 - 若需真实语言建模任务,可将
SequenceDataset替换为torchtext的WikiText2或自定义文本数据,模型结构无需改动。 - 推理速度测试需在CPU上进行(
torch.set_num_threads(1)可固定单线程获得更稳定对比)。