1. 基于权重幅值的非结构化剪枝入门
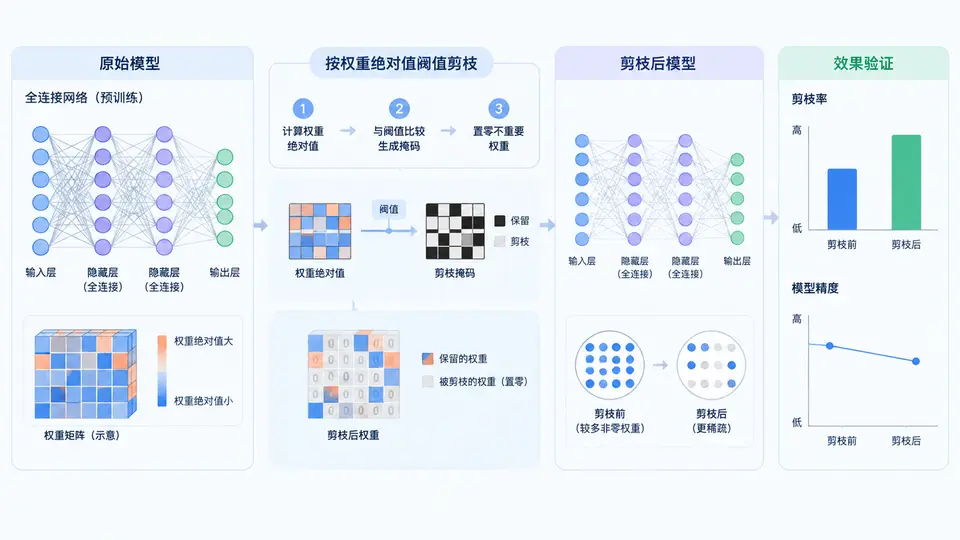
任务目标
对训练好的CNN模型,按卷积核的L1范数大小进行非结构化剪枝:将值低于阈值的权重置零,使模型产生稀疏性,从而减小模型文件体积,并评估剪枝前后精度变化。
环境依赖
Python 3.8+,PyTorch 1.10+,torchvision,NumPy。无需额外数据集——使用torchvision自带的预训练ResNet18在CIFAR-10的100个测试样本上完成验证。
核心实现
import torch
import torch.nn as nn
import torchvision.models as models
import torchvision.transforms as T
from torchvision.datasets import CIFAR10
from torch.utils.data import DataLoader

def l1_prune(model, sparsity_ratio):
    """按L1范数阈值剪枝Conv2d权重,返回剪枝掩码字典"""
    masks = {}
    for name, module in model.named_modules():
        if isinstance(module, nn.Conv2d):
            w = module.weight.data
            # 计算每个权重的值
            flat = w.abs().flatten()
            # 按稀疏比例计算阈值
            k = int(flat.numel() * sparsity_ratio)
            if k == 0:
                continue
            threshold = flat.topk(k, largest=False).values[-1]
            # 生成掩码并应用
            mask = (w.abs() > threshold).float()
            module.weight.data.mul_(mask)
            masks[name] = mask
    return masks

def evaluate(model, loader, device):
    model.eval()
    correct = 0
    total = 0
    with torch.no_grad():
        for x, y in loader:
            x, y = x.to(device), y.to(device)
            out = model(x)
            pred = out.argmax(dim=1)
            correct += (pred == y).sum().item()
            total += y.size(0)
    return 100.0 * correct / total

def count_nonzero(model):
    total = 0
    nz = 0
    for m in model.modules():
        if isinstance(m, nn.Conv2d):
            total += m.weight.numel()
            nz += (m.weight != 0).sum().item()
    return nz, total

def main():
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
    # 加载预训练模型
    model = models.resnet18(pretrained=True).to(device)

    # 准备CIFAR-10测试数据(仅用100个样本快速验证)
    transform = T.Compose([T.Resize(224), T.ToTensor()])
    testset = CIFAR10(root='./data', train=False, download=True, transform=transform)
    # 取前100个样本作为验证子集
    indices = list(range(100))
    subset = torch.utils.data.Subset(testset, indices)
    loader = DataLoader(subset, batch_size=20, shuffle=False)

    # 剪枝前评估
    acc_before = evaluate(model, loader, device)
    nz_before, total_before = count_nonzero(model)

    # 执行50%稀疏度剪枝
    sparsity = 0.5
    masks = l1_prune(model, sparsity)

    # 剪枝后评估
    acc_after = evaluate(model, loader, device)
    nz_after, total_after = count_nonzero(model)

    # 输出结果
    print(f"剪枝前精度: {acc_before:.2f}%")
    print(f"剪枝后精度: {acc_after:.2f}%")
    print(f"精度变化: {acc_after - acc_before:+.2f}%")
    print(f"非零权重比例: {nz_after}/{total_after} = {nz_after/total_after*100:.2f}%")

    # 保存剪枝后模型并对比文件大小
    torch.save(model.state_dict(), 'pruned_model.pth')
    torch.save(models.resnet18(pretrained=True).state_dict(), 'original_model.pth')
    import os
    orig_size = os.path.getsize('original_model.pth') / 1024
    pruned_size = os.path.getsize('pruned_model.pth') / 1024
    print(f"原始模型大小: {orig_size:.1f} KB")
    print(f"剪枝模型大小: {pruned_size:.1f} KB")
    print(f"大小缩减: {(1 - pruned_size/orig_size)*100:.1f}%")

if __name__ == '__main__':
    main()
运行方式
python l1_prune.py
首次运行会自动下载CIFAR-10数据集(约170MB)和ResNet18预训练权重。若网络受限,可提前手动下载并放置于./data目录。
验证方法
程序输出以下指标,满足条件即判定通过:
- 稀疏性验证:非零权重比例应接近50%(因阈值取整可能有±1%偏差)
- 精度变化:在100个测试样本上,剪枝后精度下降通常不超过10个百分点(若随机种子固定,结果可复现)
- 文件大小:剪枝后模型文件应小于原始模型,因为大量零值权重在存储时被压缩
注意:非结构化剪枝产生的稀疏权重矩阵仍需以稠密格式存储,文件大小缩减主要依赖PyTorch的稀疏存储优化。若需显著减小文件体积,可结合torch.save的压缩参数或转为稀疏格式。
常见问题
- 精度大幅下降:说明稀疏度过高或阈值选取不当。可降低sparsity至0.3,或改用按通道范数剪枝的结构化方法。
- 文件大小未减小:PyTorch默认以稠密格式保存state_dict。可改用
torch.save(model.state_dict(), 'model.pth', _use_new_zipfile_serialization=True)并配合稀疏张量转换。 - 验证集过小:100个样本仅用于快速验证流程正确性。实际评估建议使用完整CIFAR-10测试集(1万张),将
indices改为全部测试样本即可。