1. CSV训练数据缺失值检测与统计
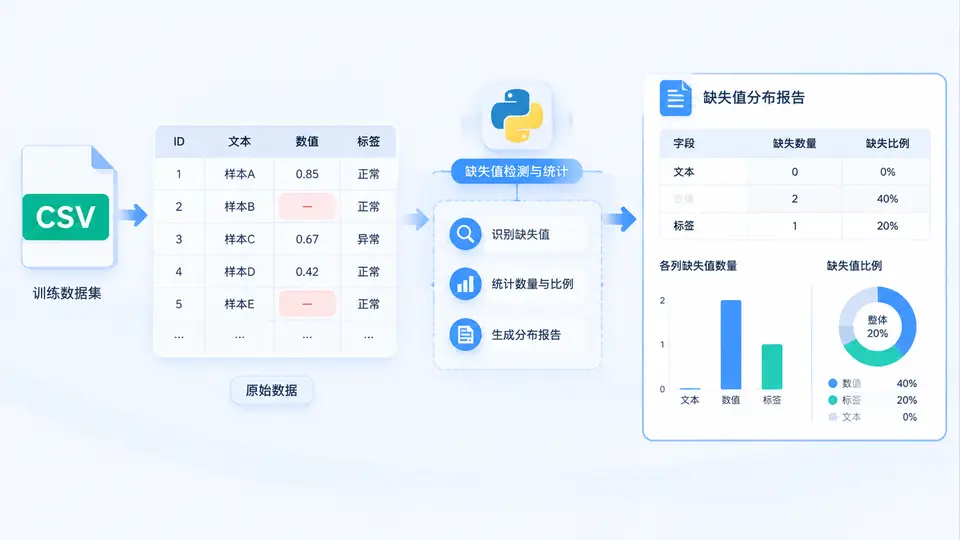
任务说明
图像数据集中常存在完全相同的副本或经过缩放、轻微压缩、格式转换的近似重复样本。这些冗余数据会放大某些样本在训练中的权重,导致模型过拟合且评估指标失真。本案例使用感知哈希(Perceptual Hash, pHash)算法为每张图像生成64位指纹,通过汉明距离判定重复与近似重复,并自动移除冗余样本。
环境依赖
需要 Python 3.8+,并安装以下库:
pip install opencv-python-headless numpy完整实现代码
import os
import cv2
import numpy as np
from collections import defaultdict

def compute_phash(image_path, hash_size=8):
    """计算图像感知哈希(64位)"""
    img = cv2.imread(image_path, cv2.IMREAD_GRAYSCALE)
    if img is None:
        raise ValueError(f"无法读取图像: {image_path}")
    # 缩放到 hash_size+1 x hash_size+1 以计算DCT
    img = cv2.resize(img, (hash_size + 1, hash_size + 1))
    # 转为浮点并计算DCT
    dct = cv2.dct(np.float32(img))
    # 取左上角 8x8 低频块(去掉DC分量)
    low_freq = dct[:hash_size, :hash_size]
    # 用中值作为阈值生成二进制哈希
    med = np.median(low_freq)
    hash_bits = (low_freq > med).flatten().astype(np.uint8)
    # 打包为64位整数
    hash_val = 0
    for bit in hash_bits:
        hash_val = (hash_val << 1) | int(bit)
    return hash_val

def hamming_distance(h1, h2):
    """计算两个64位哈希的汉明距离"""
    return bin(h1 ^ h2).count('1')

def find_and_remove_duplicates(image_dir, threshold=10):
    """
    检测并移除重复/近似重复图像。
    threshold: 汉明距离阈值,小于等于该值判定为重复(默认10,适合8x8 pHash)
    """
    # 收集所有图像文件
    exts = ('.jpg', '.jpeg', '.png', '.bmp', '.webp')
    files = [f for f in os.listdir(image_dir) if f.lower().endswith(exts)]
    if not files:
        print("目录中没有找到图像文件")
        return

    # 计算每张图像的pHash
    hash_map = {}  # filename -> hash_value
    for fname in files:
        path = os.path.join(image_dir, fname)
        try:
            hash_map[fname] = compute_phash(path)
        except Exception as e:
            print(f"跳过 {fname}: {e}")

    # 分组查找重复(O(n^2)比较,适合中小规模数据集)
    visited = set()
    groups = []  # 每个元素是重复组的文件列表
    names = list(hash_map.keys())
    for i in range(len(names)):
        if names[i] in visited:
            continue
        group = [names[i]]
        visited.add(names[i])
        for j in range(i + 1, len(names)):
            if names[j] in visited:
                continue
            if hamming_distance(hash_map[names[i]], hash_map[names[j]]) <= threshold:
                group.append(names[j])
                visited.add(names[j])
        if len(group) > 1:
            groups.append(group)

    # 输出分组并删除冗余(每组保留第一个文件)
    total_removed = 0
    for group in groups:
        print(f"重复组: {group}")
        for redundant in group[1:]:  # 保留第一个,删除其余
            os.remove(os.path.join(image_dir, redundant))
            total_removed += 1
            print(f"  已删除: {redundant}")

    if not groups:
        print("未检测到重复图像")
    else:
        print(f"共移除 {total_removed} 个冗余文件")

if __name__ == "__main__":
    # 使用示例:将下方路径替换为你的图像目录
    find_and_remove_duplicates("./images", threshold=10)
运行方式
将上述代码保存为 remove_duplicates.py,在代码所在目录下创建 images 文件夹并放入待清洗的图像,然后执行:
python remove_duplicates.py验证方法
运行前先记录图像总数。程序执行后观察输出:
- 若存在重复图像,会打印每个重复组的文件名列表,并显示已删除的冗余文件;
- 运行结束后,再次统计目录中图像数量,减少的数量应与输出中“共移除”的数字一致;
- 手动抽查保留的图像,确认没有误删内容明显不同的样本。
通过条件:程序无报错完成执行,重复组被正确识别并删除,剩余图像均为互不重复的样本。阈值 threshold=10 适用于大多数场景;若发现近似重复未被检出,可适当增大阈值(如12~15);若出现不同图像被误判为重复,则减小阈值。
常见问题
- 图像无法读取:确认文件路径正确且格式受OpenCV支持,损坏文件会被自动跳过并提示。
- 检测过严或过松:调整
threshold参数即可控制判定灵敏度。 - 大规模数据集:当前O(n²)比较适合万级以下规模;更大数据集可先按哈希值分桶加速,但本案例以最小可复现实现为目标。