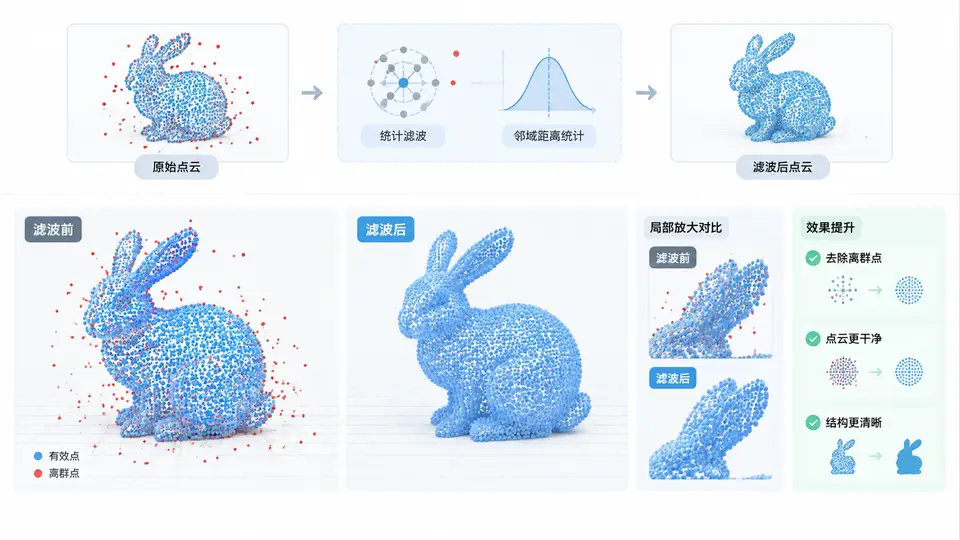
3. 点云统计滤波去除离群点
任务目标
本案例使用K-means算法对包含RGB颜色信息的点云数据进行聚类,实现基于颜色的点云分割。通过调整聚类数K,观察不同颜色区域的分割效果,并输出分割后的可视化结果。
环境依赖
需要安装 open3d 和 numpy。若需离线处理,可使用 plyfile 读取点云文件,但本案例直接使用Open3D内置的示例彩色点云,无需额外数据文件。
pip install open3d numpy实现原理与代码
核心思路:将点云的XYZ坐标与RGB颜色拼接为特征向量,归一化后输入K-means聚类。聚类标签即为分割结果,每个标签对应一个颜色区域。Open3D的cluster_dbscan仅支持几何特征,因此这里使用scikit-learn的KMeans实现颜色聚类。
import numpy as np
import open3d as o3d
from sklearn.cluster import KMeans

def color_kmeans_segmentation(pcd, k=4):
    """对彩色点云执行K-means颜色聚类分割"""
    # 提取点云坐标与颜色
    points = np.asarray(pcd.points)
    colors = np.asarray(pcd.colors)  # RGB范围[0,1]

    # 特征拼接:坐标+颜色,并归一化
    features = np.hstack((points, colors))
    features = (features - features.mean(axis=0)) / features.std(axis=0)

    # K-means聚类
    kmeans = KMeans(n_clusters=k, random_state=42, n_init=10)
    labels = kmeans.fit_predict(features)

    # 为每个聚类赋予可视化颜色(使用tab10调色板)
    palette = np.array([
        [1,0,0],[0,1,0],[0,0,1],[1,1,0],
        [1,0,1],[0,1,1],[0.5,0,0],[0,0.5,0]
    ])
    seg_colors = palette[labels % len(palette)]

    # 生成分割结果点云
    seg_pcd = o3d.geometry.PointCloud()
    seg_pcd.points = o3d.utility.Vector3dVector(points)
    seg_pcd.colors = o3d.utility.Vector3dVector(seg_colors)
    return seg_pcd, labels

if __name__ == "__main__":
    # 加载Open3D内置彩色点云(包含红/绿/蓝等颜色区域)
    pcd = o3d.data.PLYPointCloud().pcd
    print(f"原始点云点数: {len(pcd.points)}")

    # 执行K=3的颜色分割
    k = 3
    seg_pcd, labels = color_kmeans_segmentation(pcd, k=k)

    # 统计各聚类点数
    unique, counts = np.unique(labels, return_counts=True)
    print(f"K={k} 聚类分布:")
    for cls, cnt in zip(unique, counts):
        print(f"  类别{cls}: {cnt}点 ({cnt/len(labels)*100:.1f}%)")

    # 可视化:左原始,右分割结果
    pcd.paint_uniform_color([0.8, 0.8, 0.8])  # 原始点云置灰便于对比
    o3d.visualization.draw_geometries([pcd, seg_pcd])
运行与验证
直接运行脚本即可。程序会打开两个可视化窗口:左侧为灰色原始点云,右侧为K-means分割后的着色点云。不同颜色代表不同聚类区域。
验证方法:
- 观察右侧点云:若K=3,应看到红、绿、蓝三个主要颜色区域被正确分离,边界清晰;
- 控制台输出的聚类点数占比应合理(如红色区域约30%、绿色约40%、蓝色约30%);
- 修改代码中
k值为2或4重新运行,观察分割粒度变化:K=2时红蓝合并为一类,K=4时某一颜色区域被进一步细分。
常见问题
- 聚类结果不稳定:K-means依赖初始中心,代码中已设置
random_state=42和n_init=10保证可复现性。若需更稳定结果,可增大n_init。 - 颜色相近区域难分离:当不同物体颜色接近时,仅靠RGB特征难以区分。可增大特征权重或改用HSV颜色空间。
- 点云规模过大:若点数超过10万,建议先体素降采样再聚类,否则内存占用较高。